TDLearning
Less than 1 minute
TDLearning
Temporal Difference Learningとも言う。ModelFreePolicyEvaluationの一種。
TD Learningとは
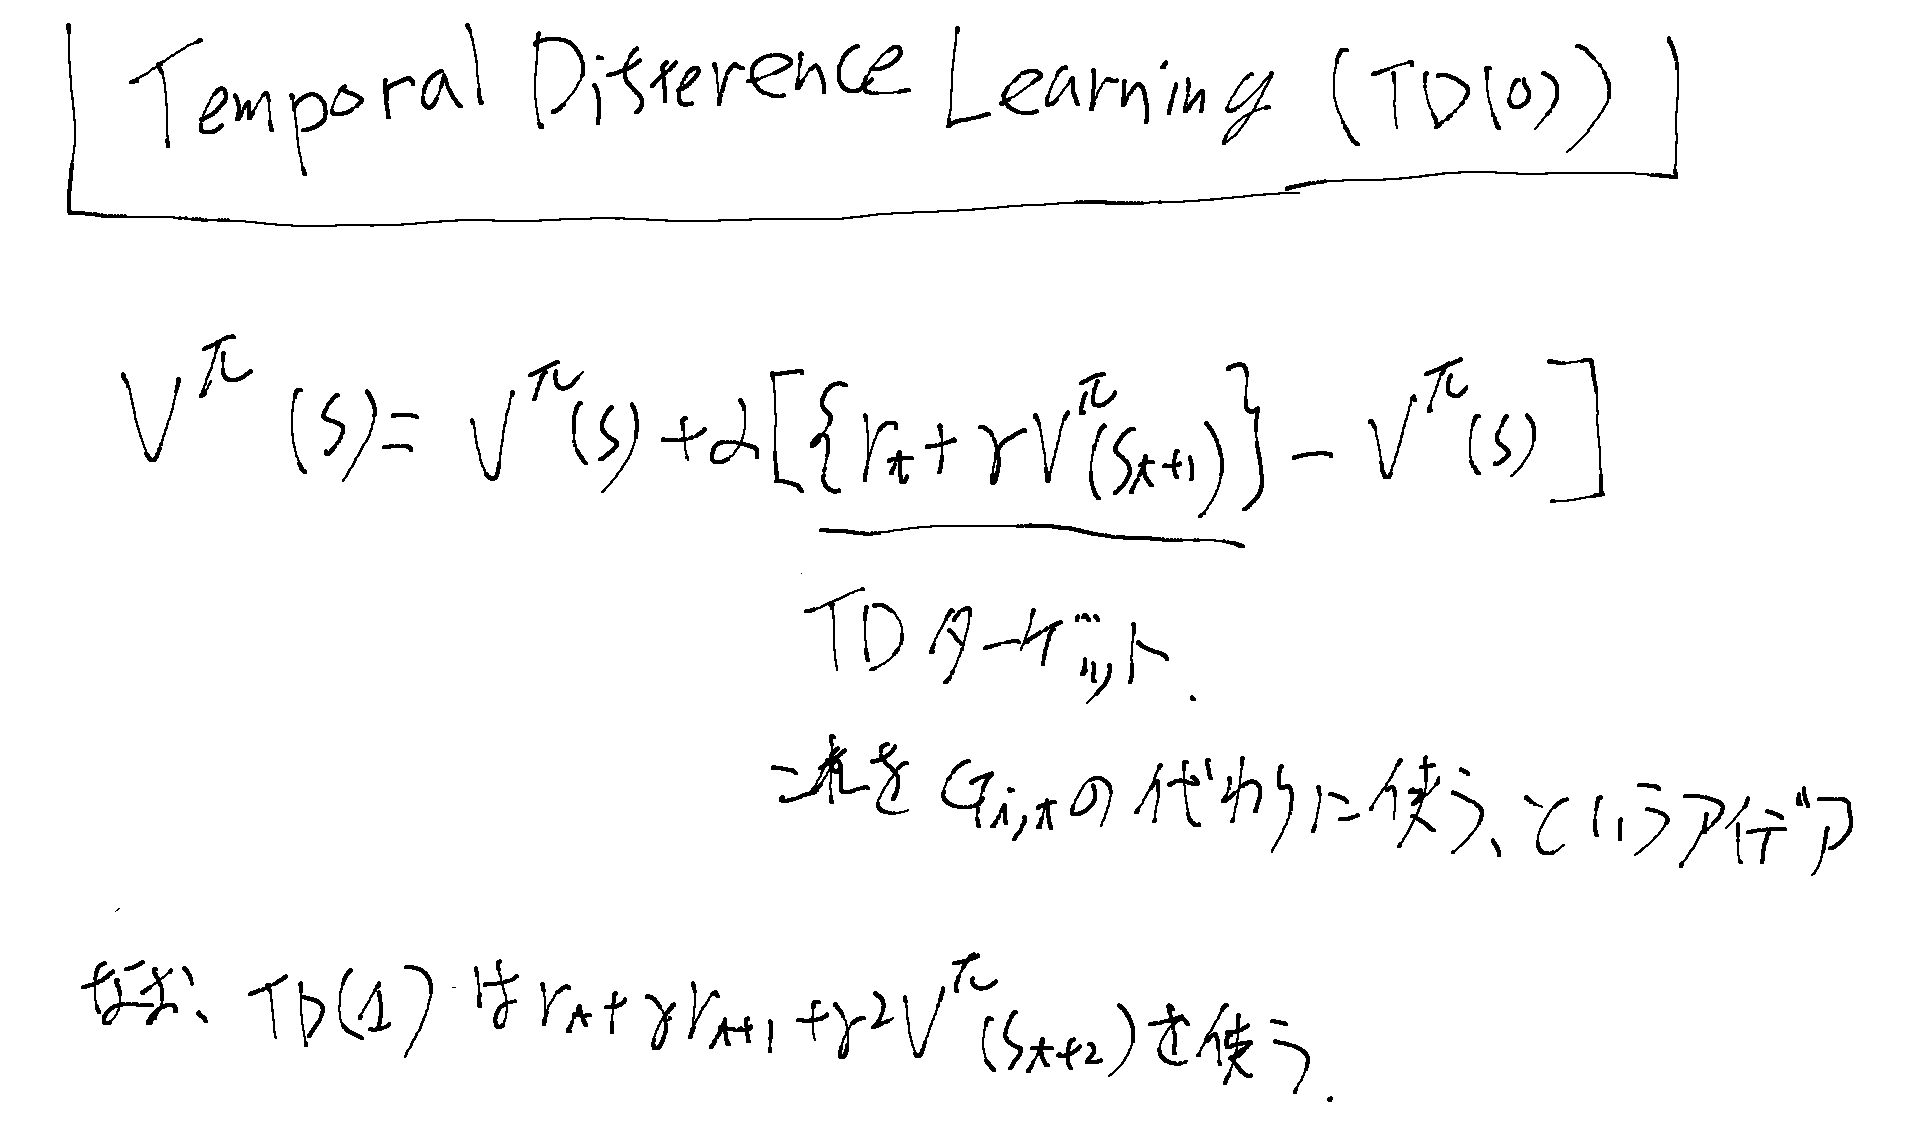
つまりGの見積もりとしてエピソード全体を使うのでは無く、そこまでの推計のVと今回のrewardsを組み合わせたものを使う。 1期のrewardsしか使っていない事に注目。(モンテカルロPolicyEvaluationのインクリメンタルとの違い)
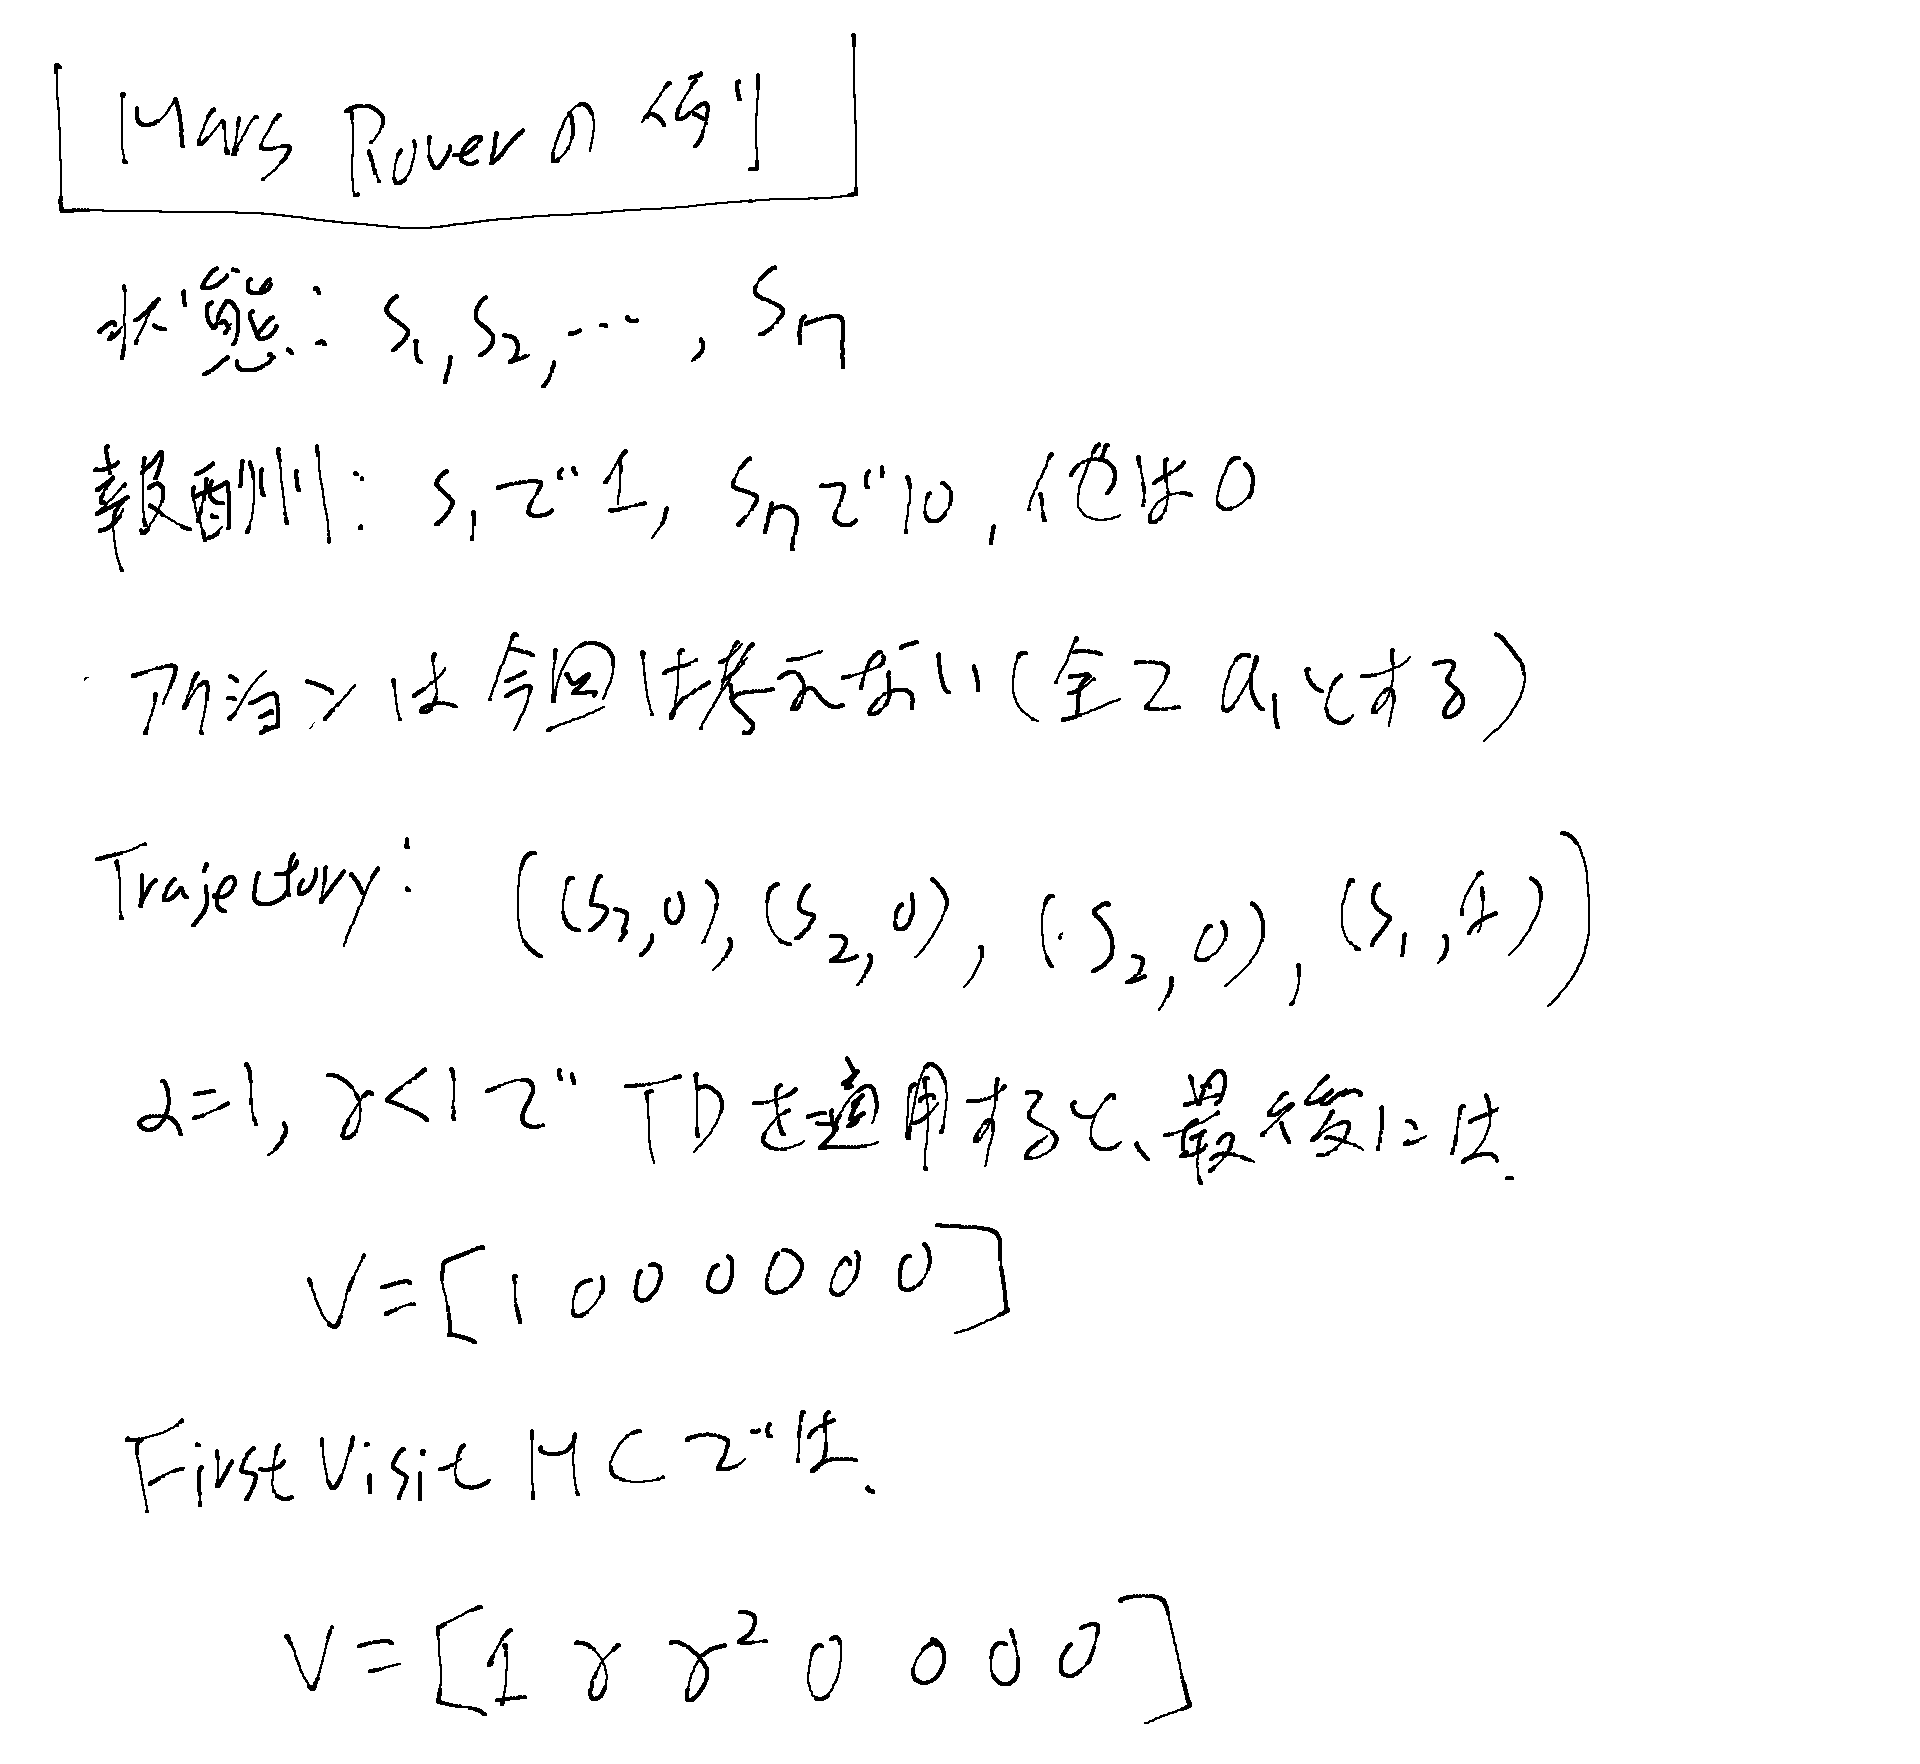
Mars Roverでの例
特徴など
- モンテカルロとdynamic programmingのハイブリッド的なもの
- ブートストラップとサンプリング
- ブートストラッピングは自分自身を足場に自分自身を引き上げる、というようなニュアンスで、Vの更新の時にその時点のV自身の予測値を使っている、というような意味らしい(V(A)を更新する時にその時点のV(B)を使ったりしている)
- 有限地平で無くても使える(エピソード的なセッティングじゃなくてもOK)
- (s, a, r, s')のタプルが来るごとにその場で更新
- 最初の頃は初期化によるのでbiasedなestimator
- インクリメンタルなモンテカルロPolicyEvaluationと同じ条件でConsistentEstimatorになる
- モンテカルロPolicyEvaluationよりvarianceが低い