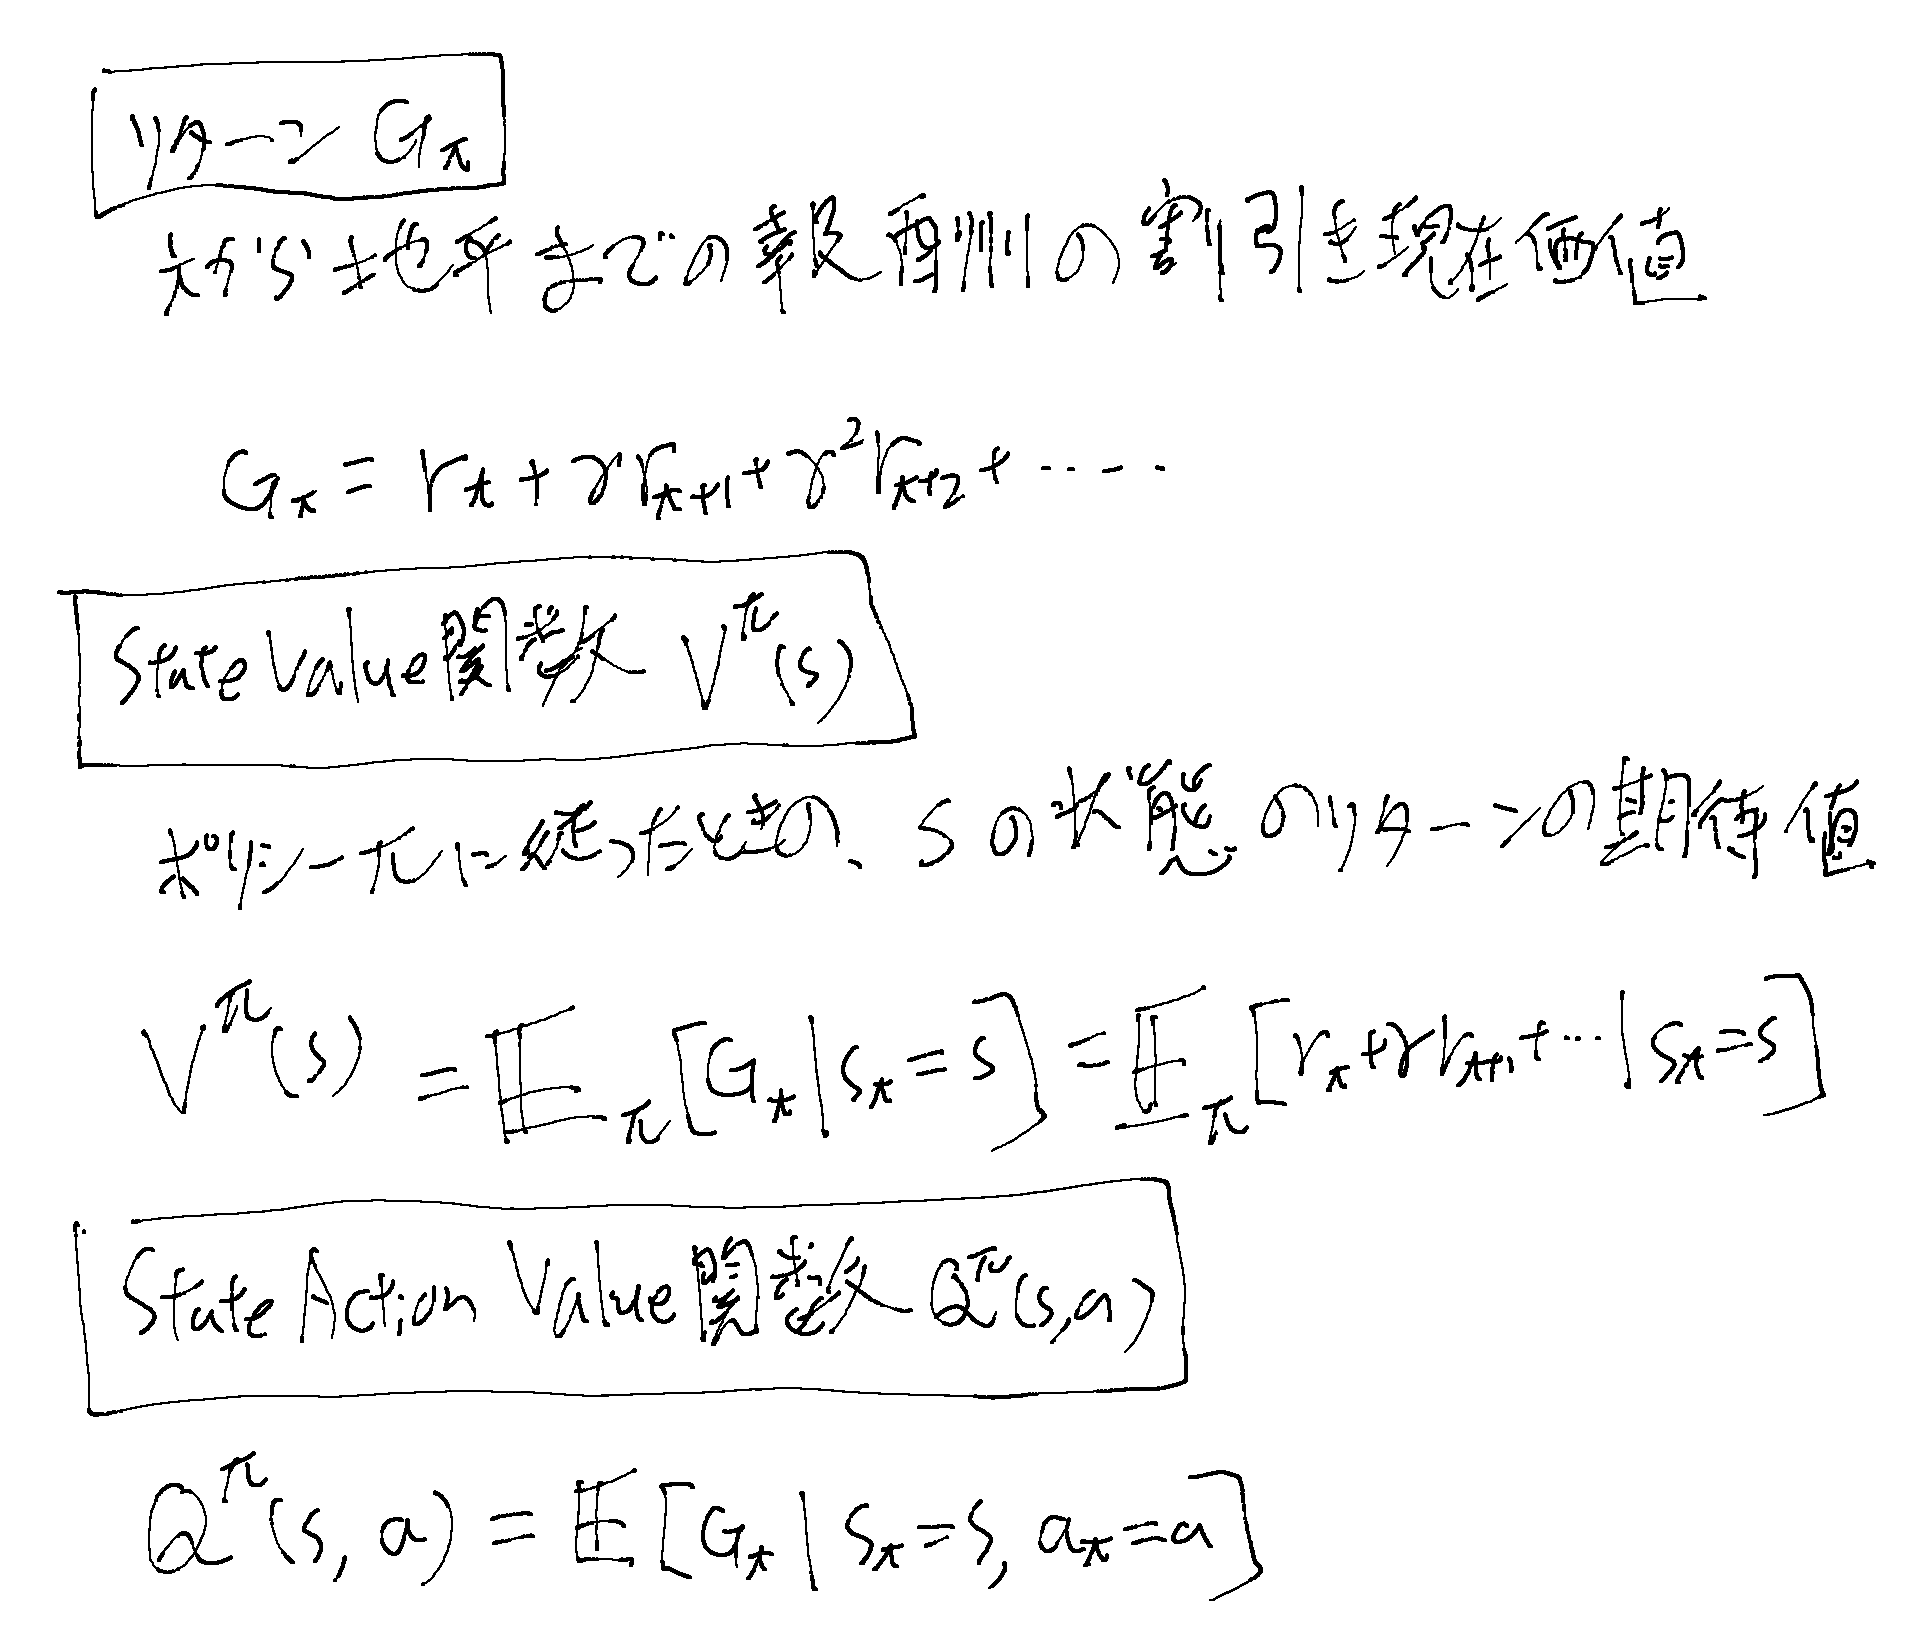ModelFreePolicyEvaluation
Less than 1 minute
ModelFreePolicyEvaluation
強化学習のCS234のLecture 3のノート。 dynamicsとrewardsに関するmodelを知らない状態でのpolicy evaluation。
Stanford CS234 Reinforcement Learning I Policy Evaluation I 2024 I Lecture 3 - YouTube
概要
- モンテカルロ Policy Evaluation
- First Visit
- EveryVisit
- インクリメンタル
- Temporal Difference Learning
- Certainty Equivalence with dynamic programming
- バッチPolicy Evaluation
今回の講義の前提
今回の前提としてpolicyはfixedなものが与えられているとする。 このpolicyに対して、環境から得られたデータだけでこのpolicyを評価する。具体的にはなんらかのアルゴリズムをdeployして顧客が実際に何を買ったか、とかそういうシチュエーション。 rewardsは観測は出来るが数式は知らない。
それぞれの手法の比較の前提
強化学習の用語定義も参照。