モンテカルロPolicyEvaluation
Less than 1 minute
モンテカルロPolicyEvaluation
ModelFreePolicyEvaluationの一種。強化学習。TDLearning、CertaintyEquivalenceによるモデル推計。
Stanford CS234 Reinforcement Learning I Policy Evaluation I 2024 I Lecture 3 - YouTube
MC Policy Evaluationとは
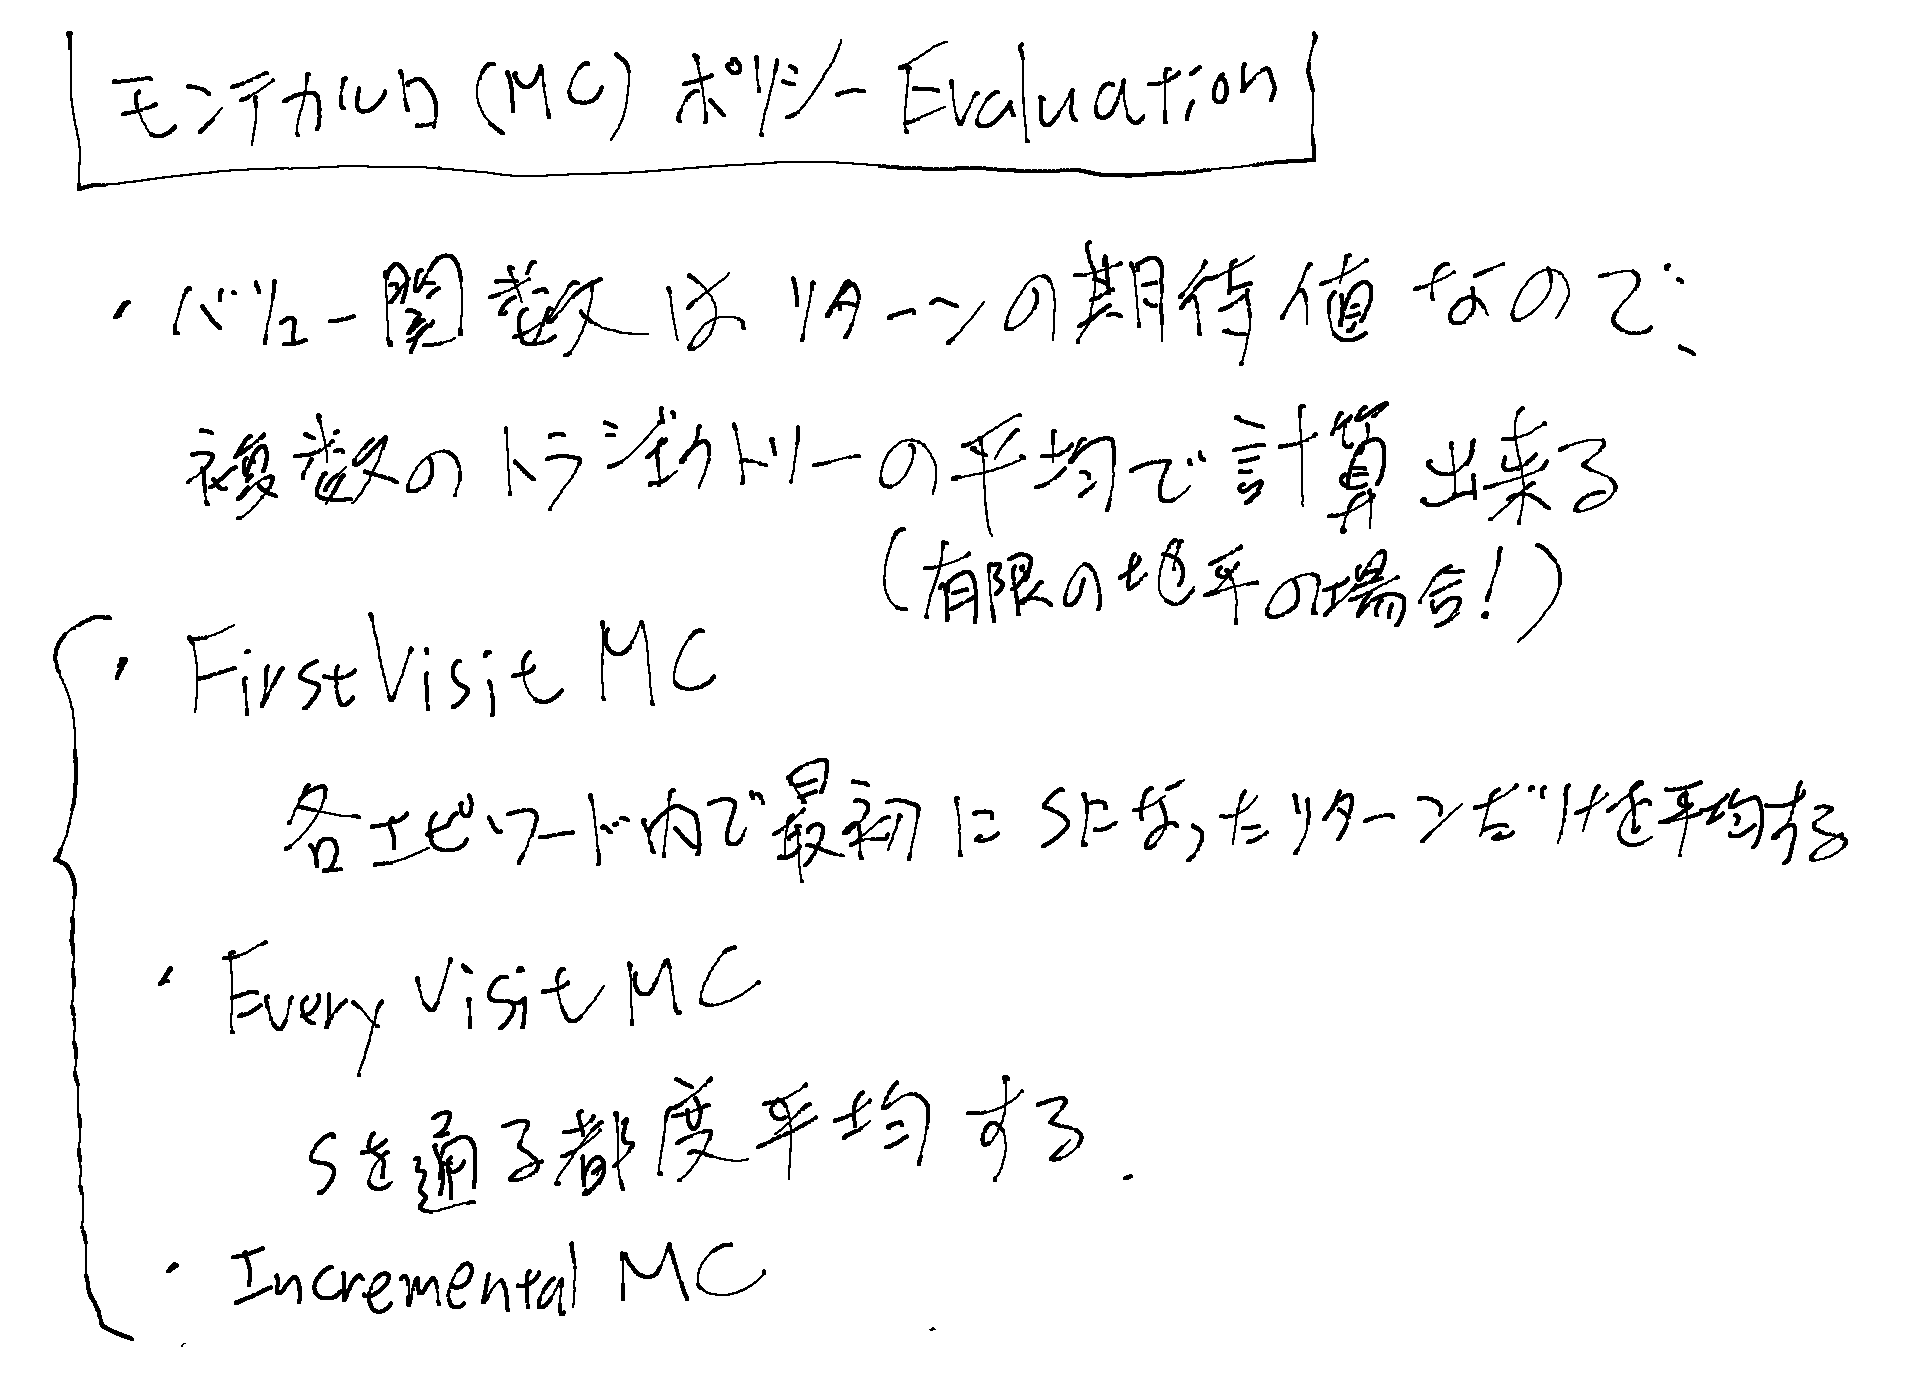
エピソードをサンプリングしてVを更新、を繰り返す。 エピソード単位でないと使えない。
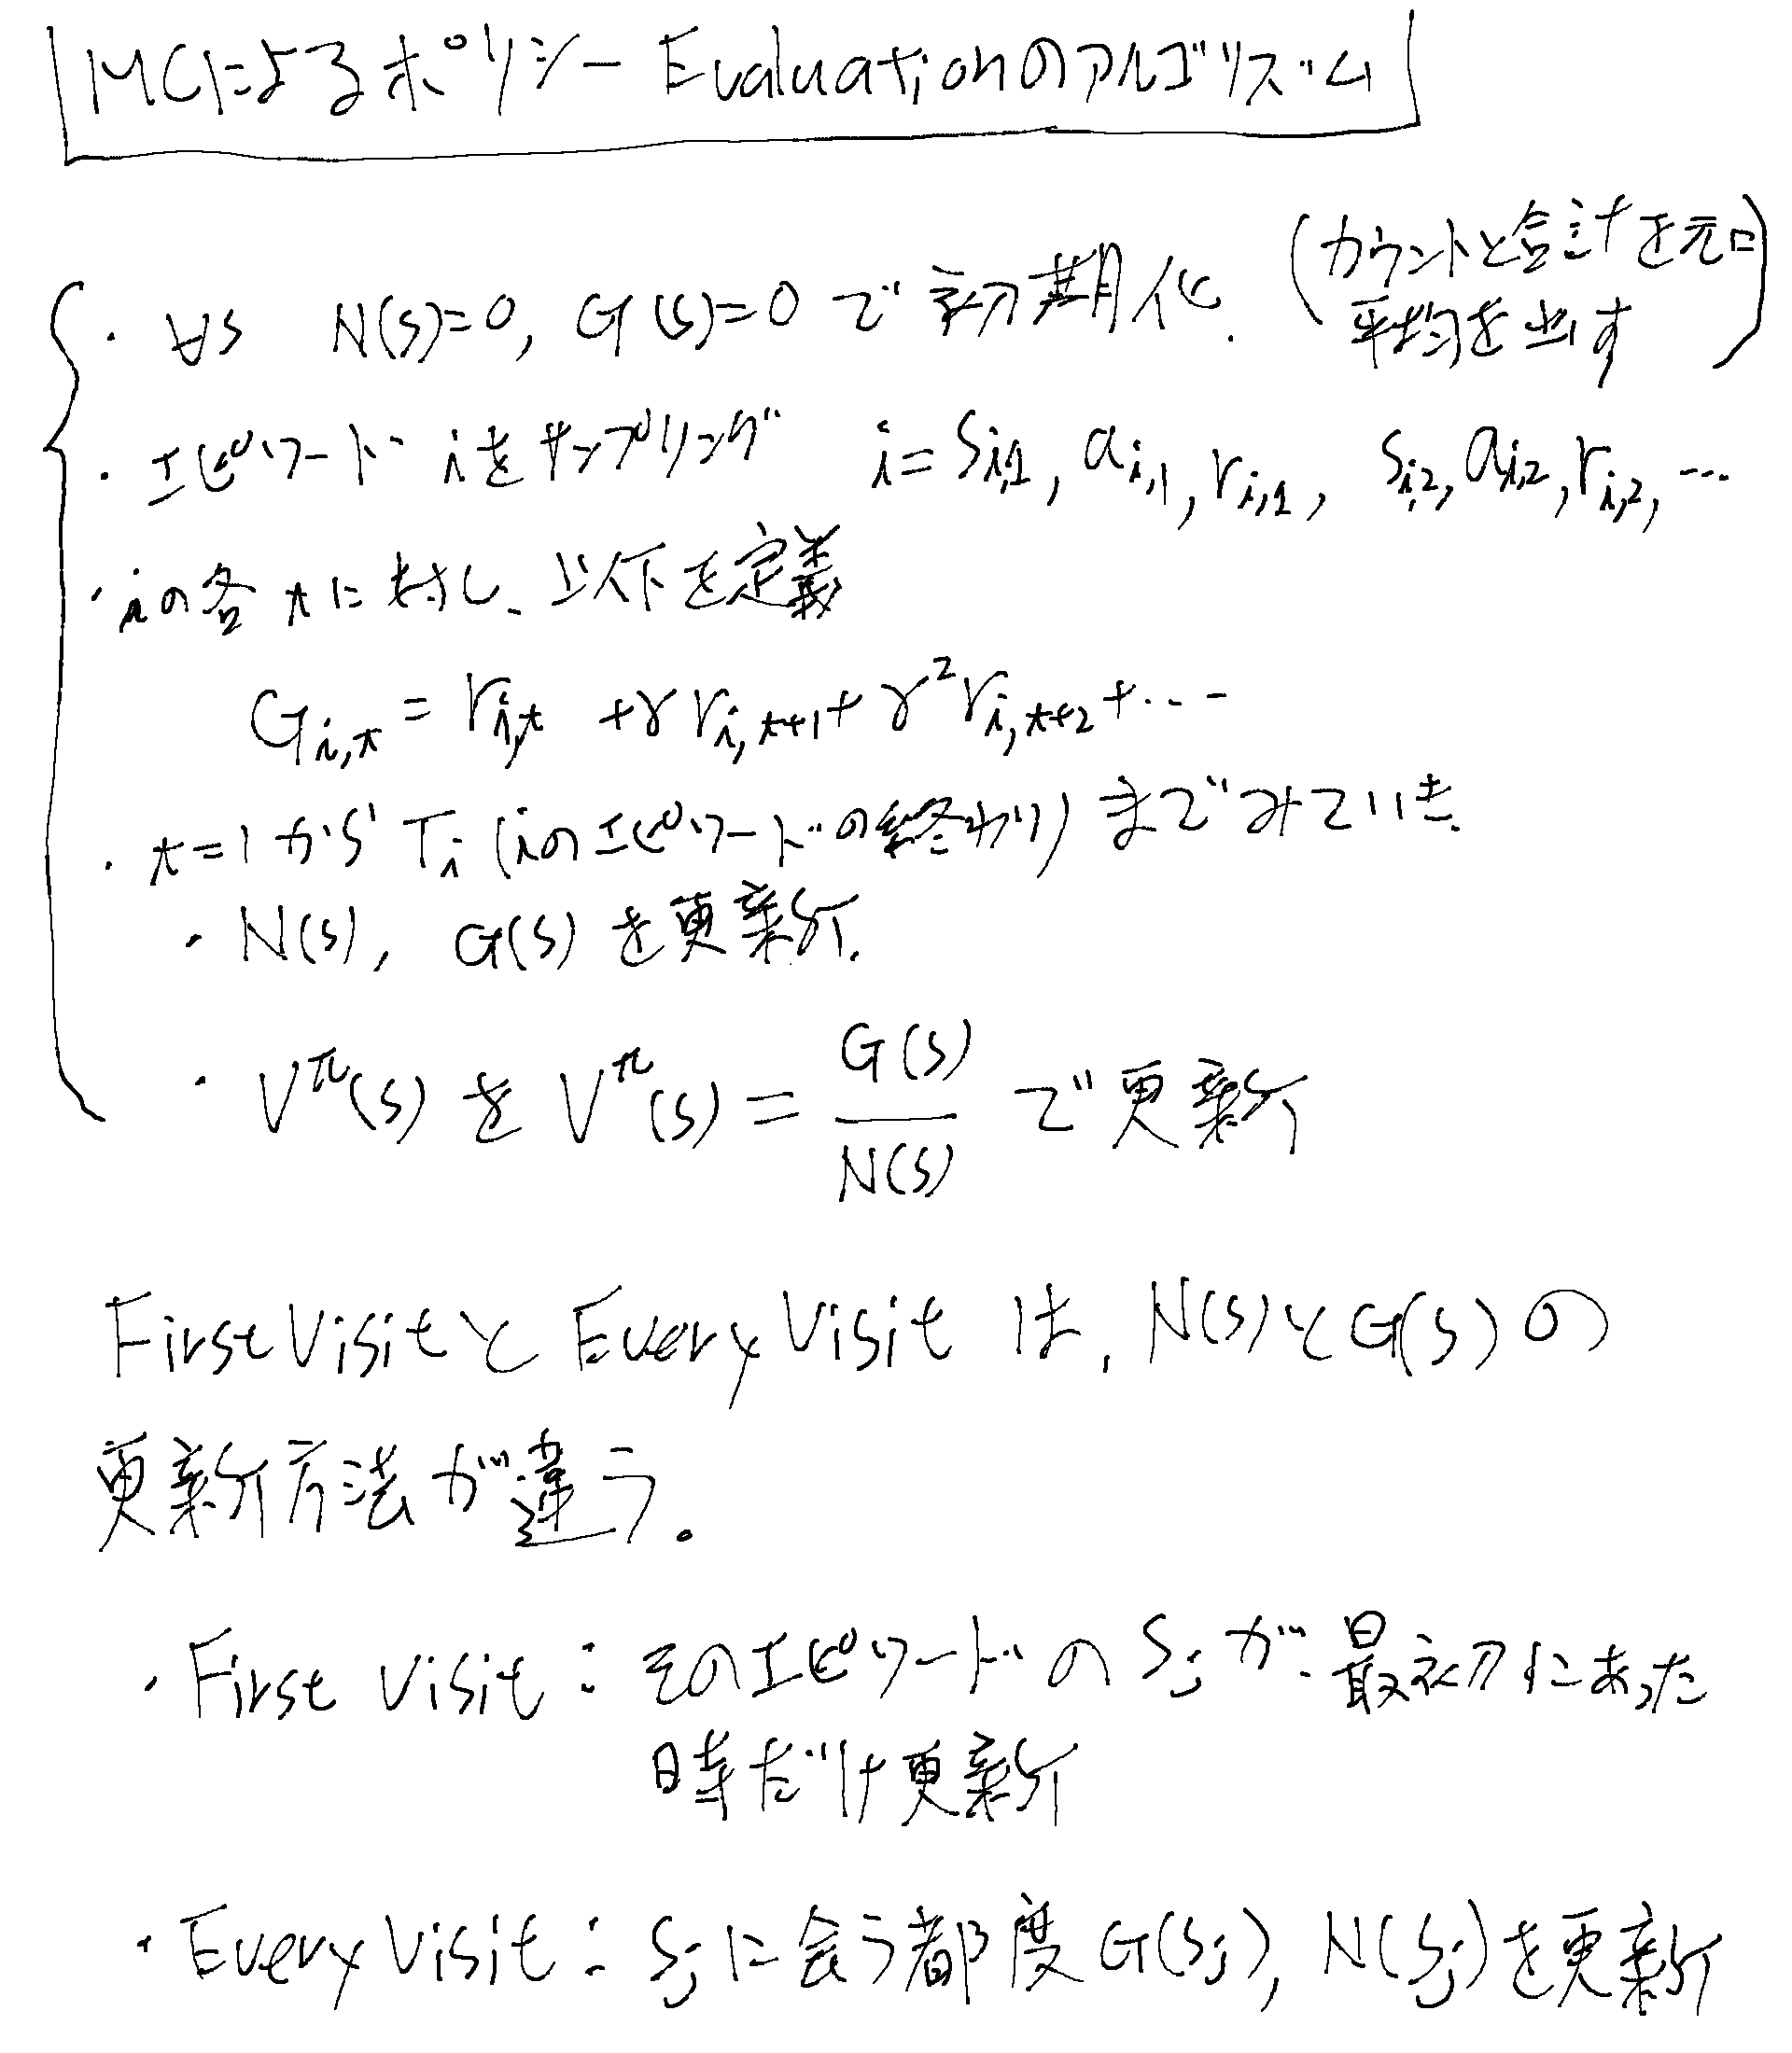
アルゴリズムとFirstVisitとEveryVisitの違い
インクリメンタル
エピソードをサンプルしてを定義する所までは変わらない。
各エピソードiのタイプステップtで、sに遭遇する都度Vを更新する。
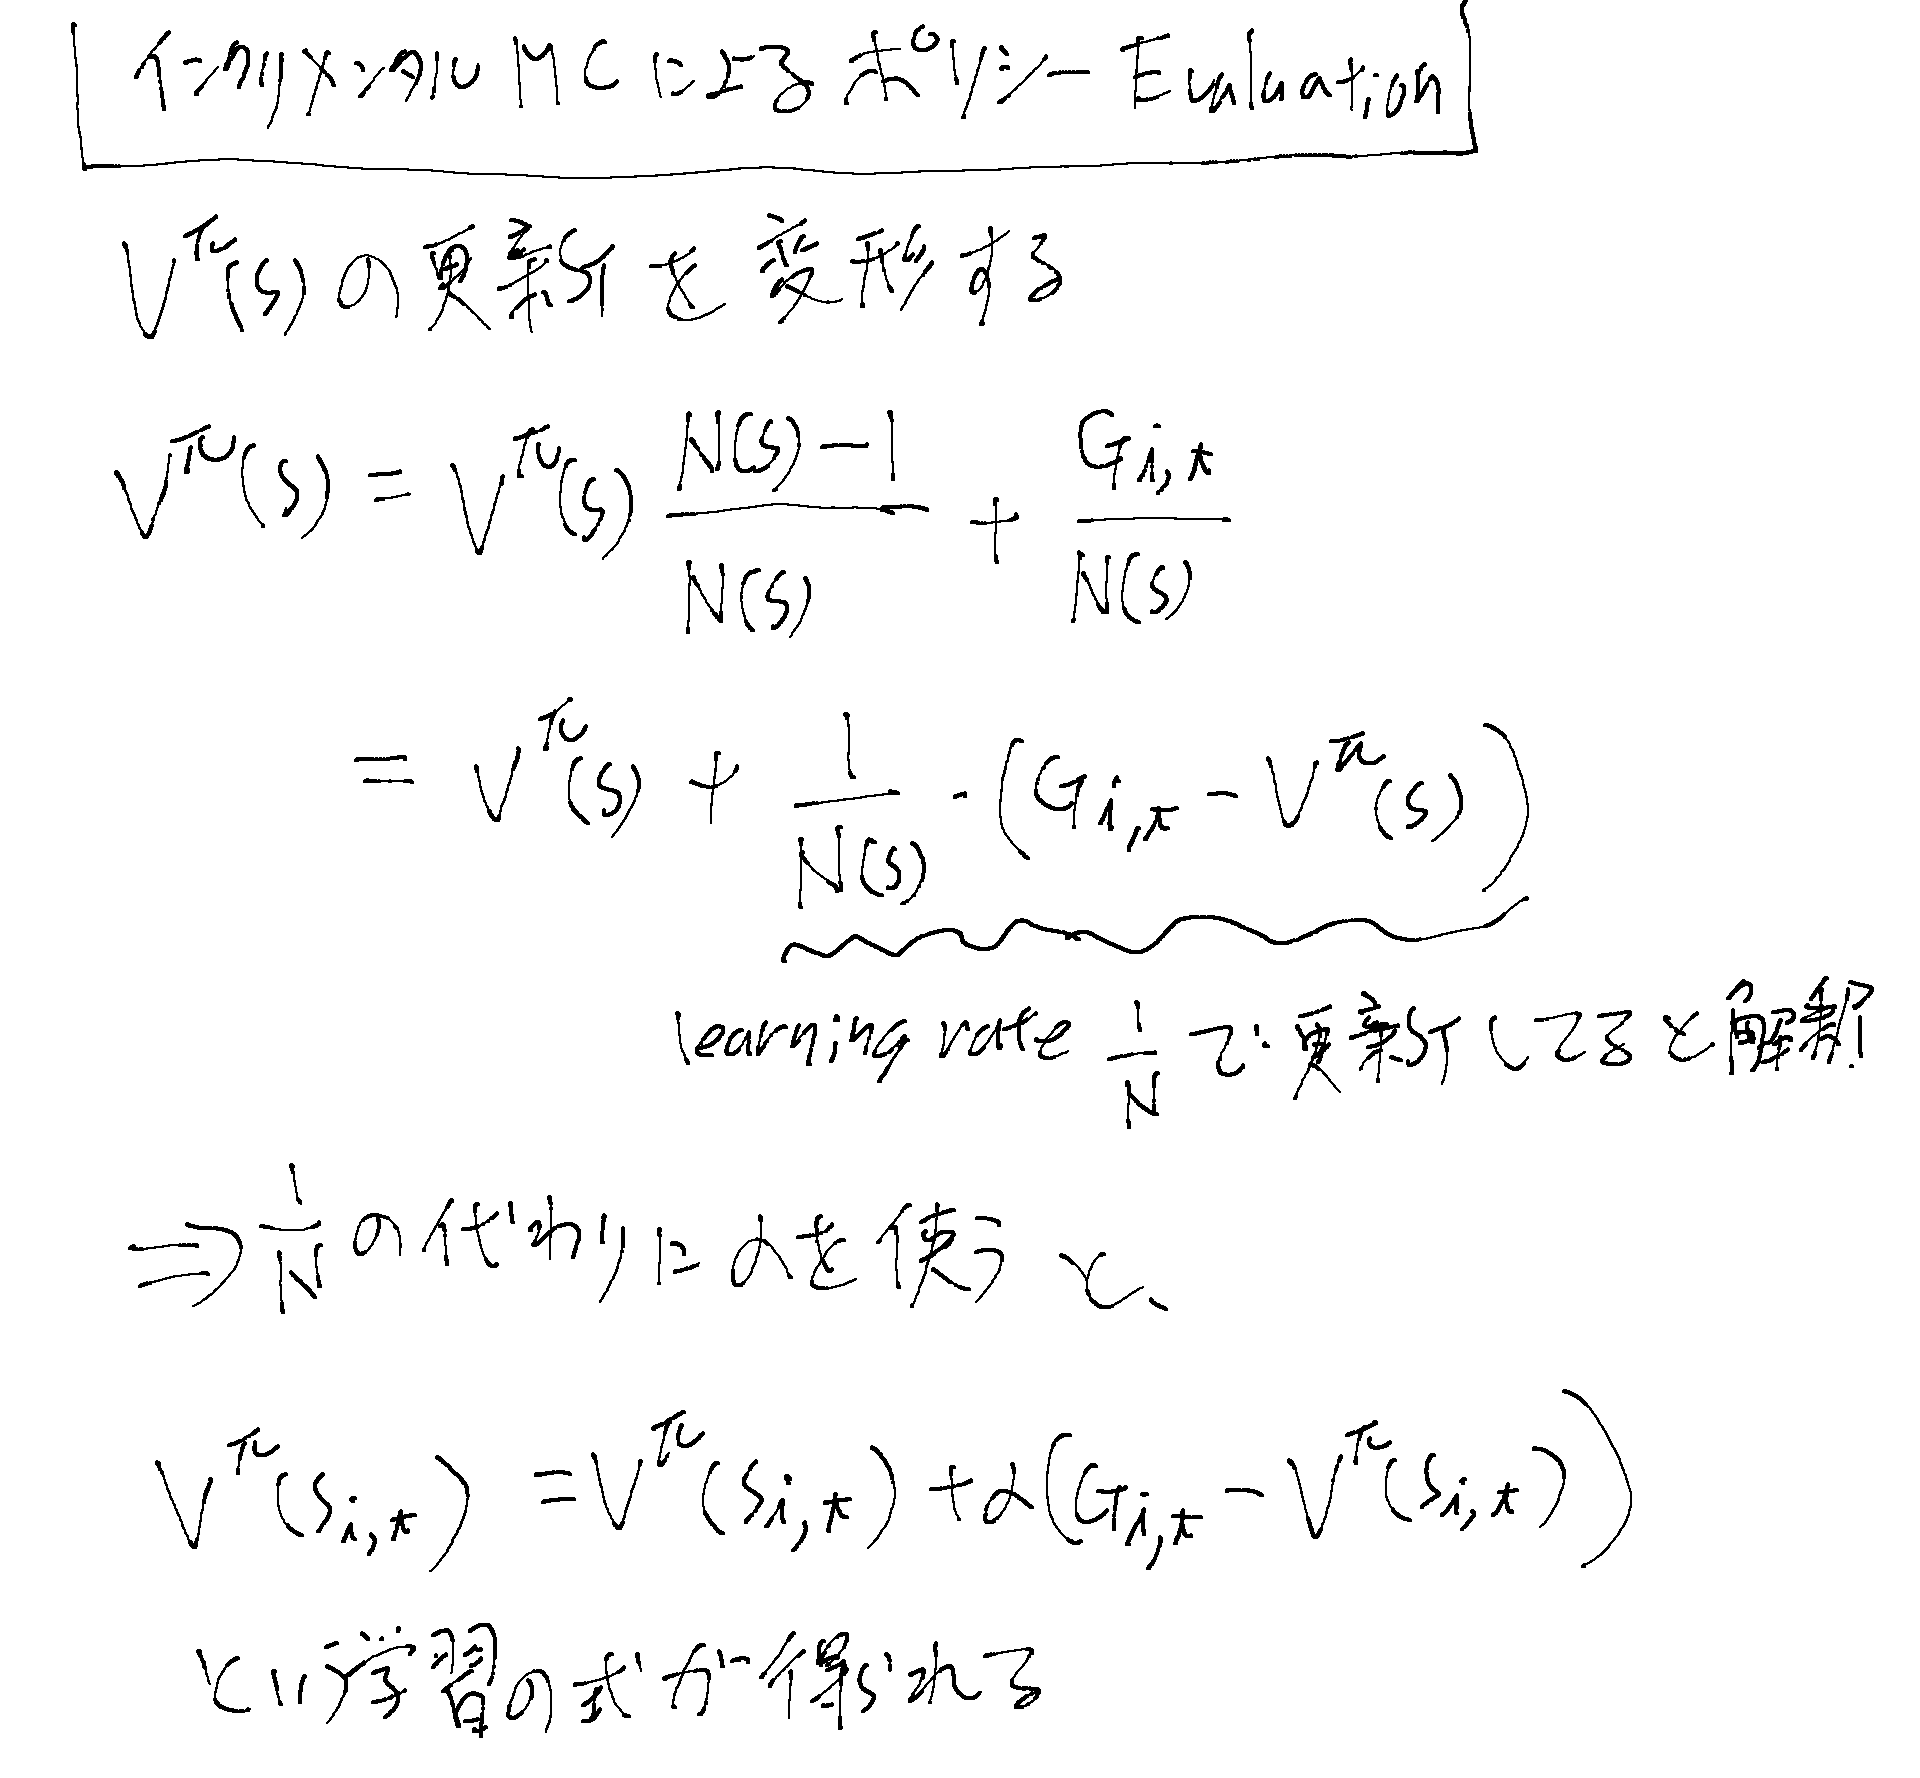
という事で1/Nを使ってもいいがそれにこだわらず、一般にラーニングレートのαならなんでも使って良い。
3つの手法の比較
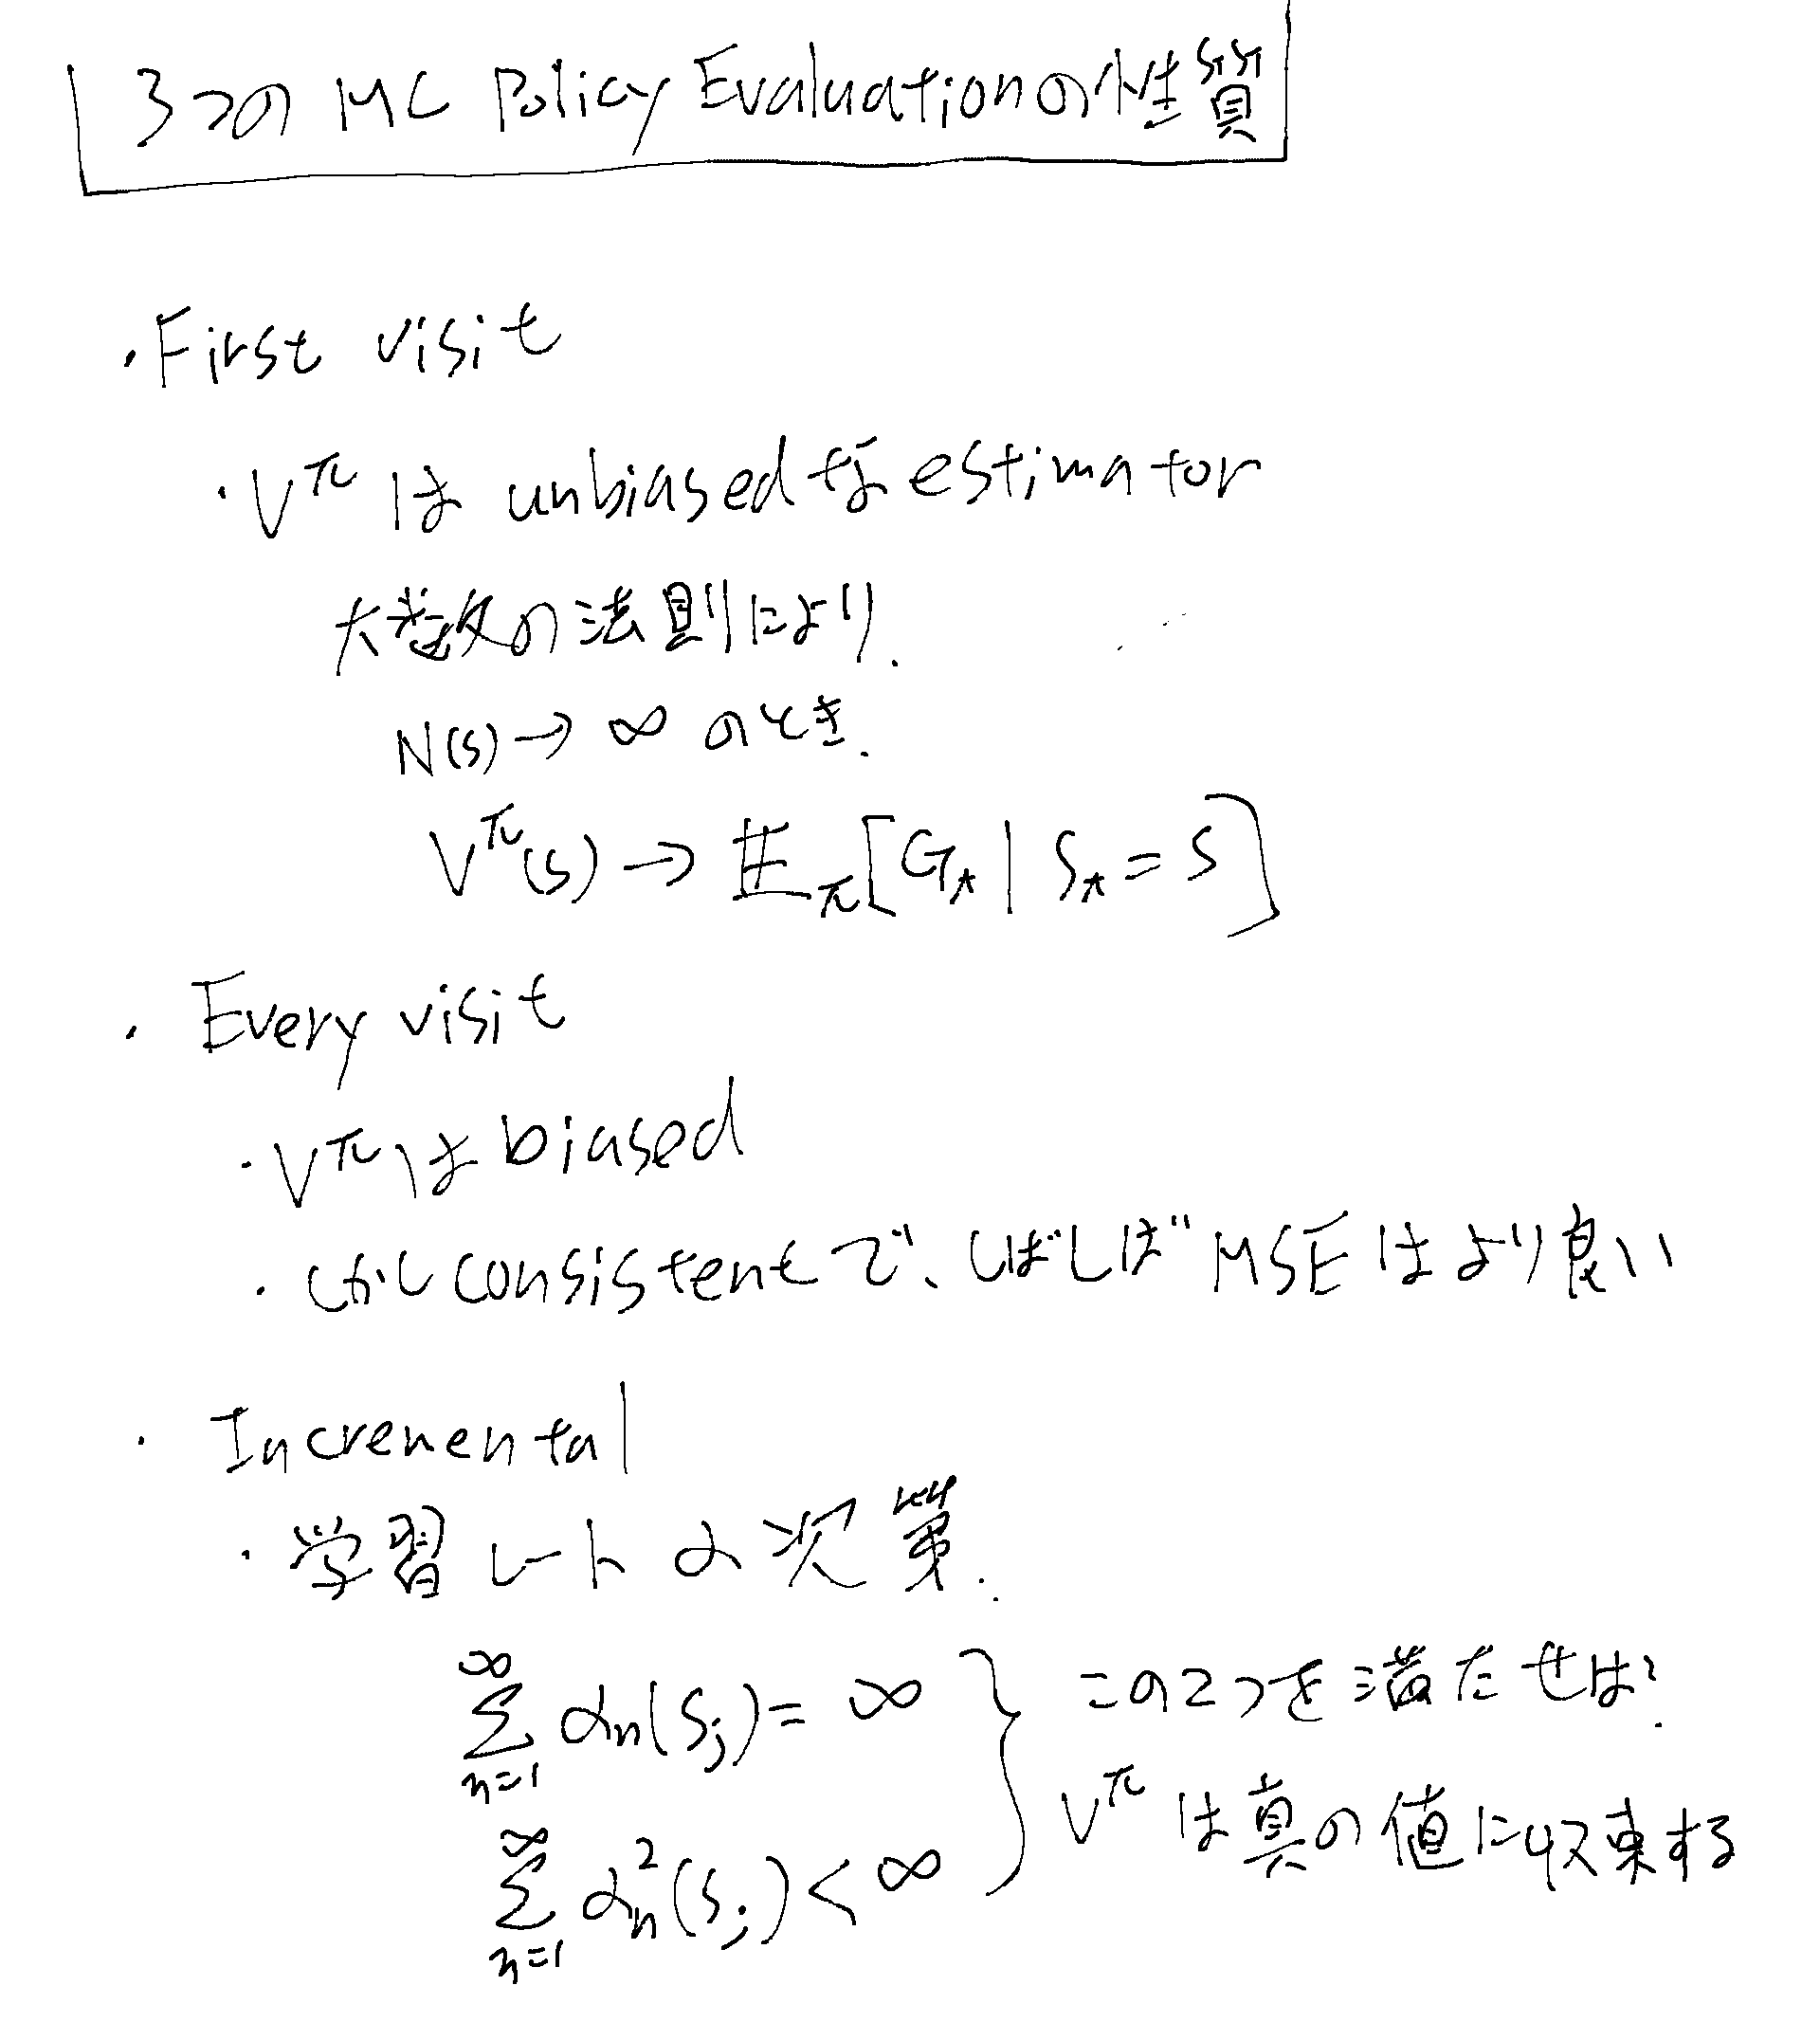
ConsistentについてはConsistentEstimatorを参照のこと。
モンテカルロPolicy Evaluationの欠点
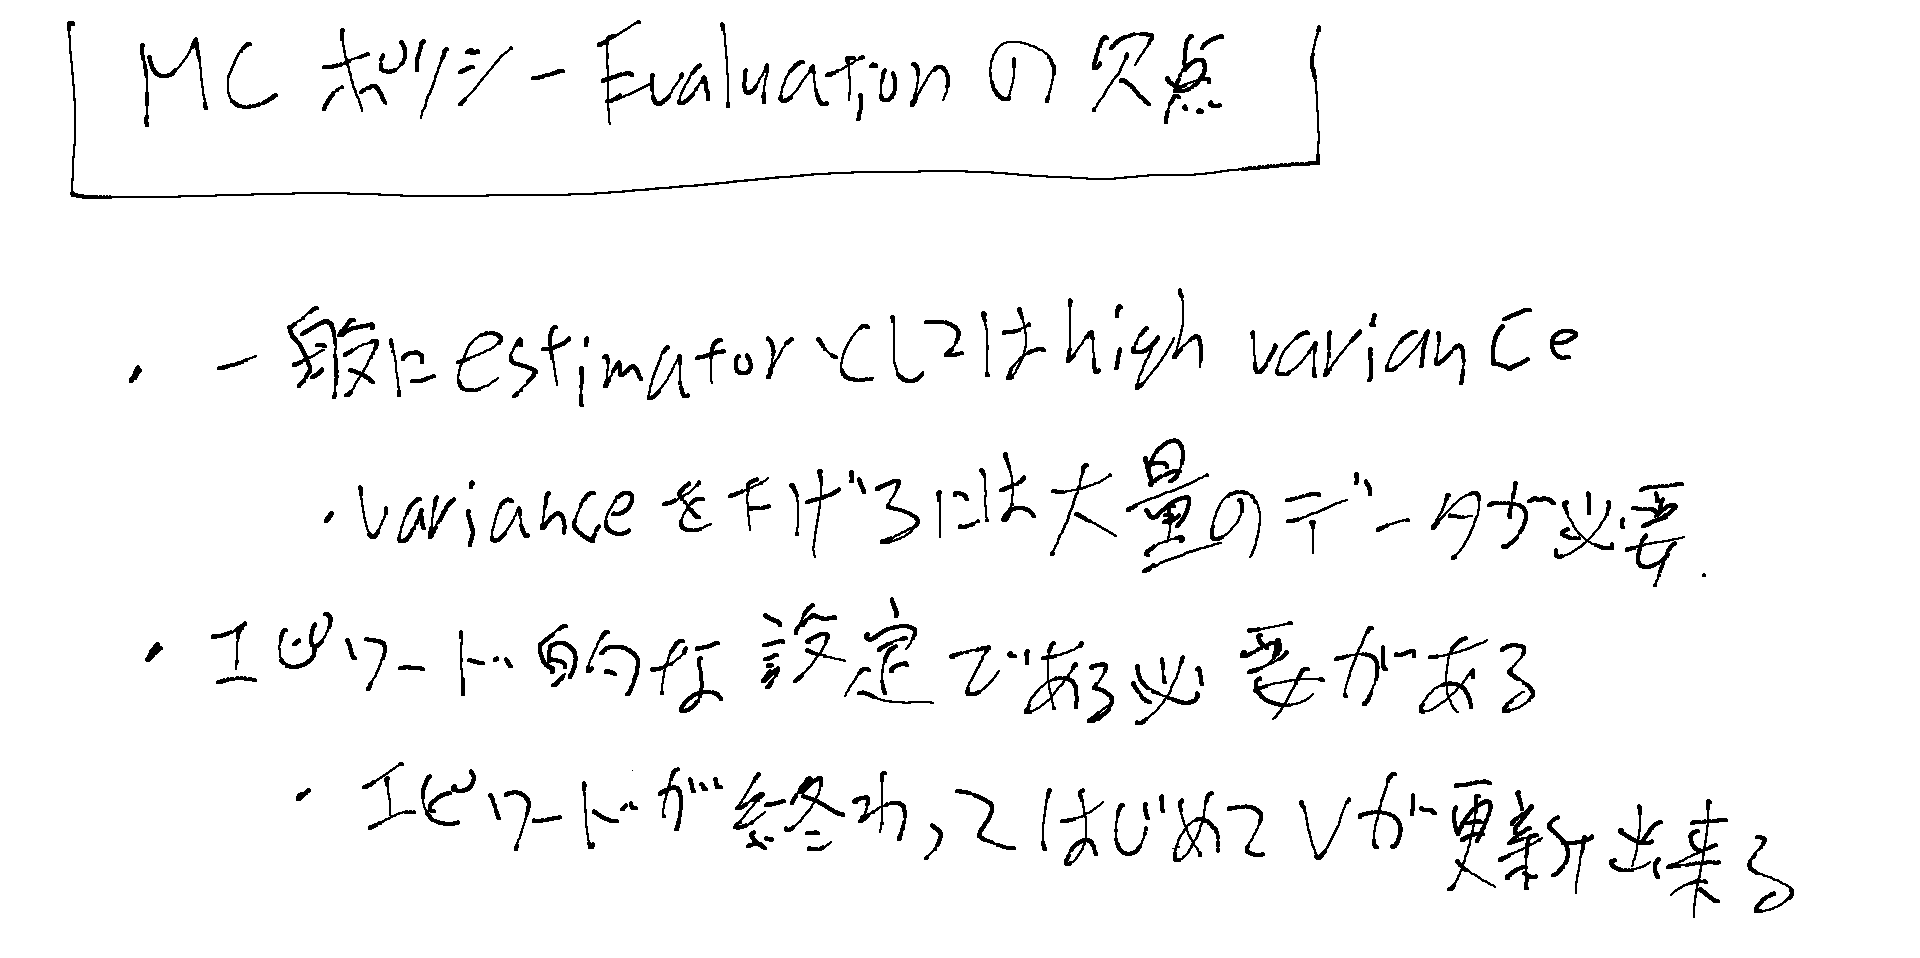
バイアスとバリアンスも参照。TDLearningとも比較したい。
Policy Improvement
ModelFreePolicyImprovementでε-greedyポリシーのMCのPolicy Improvementについて書いてある。