ModelFreePolicyImprovement
Less than 1 minute
ModelFreePolicyImprovement
前回ModelFreePolicyEvaluationをやったので、次にPolicy Improvementを考えたい。
Policy Improvementの難しさ
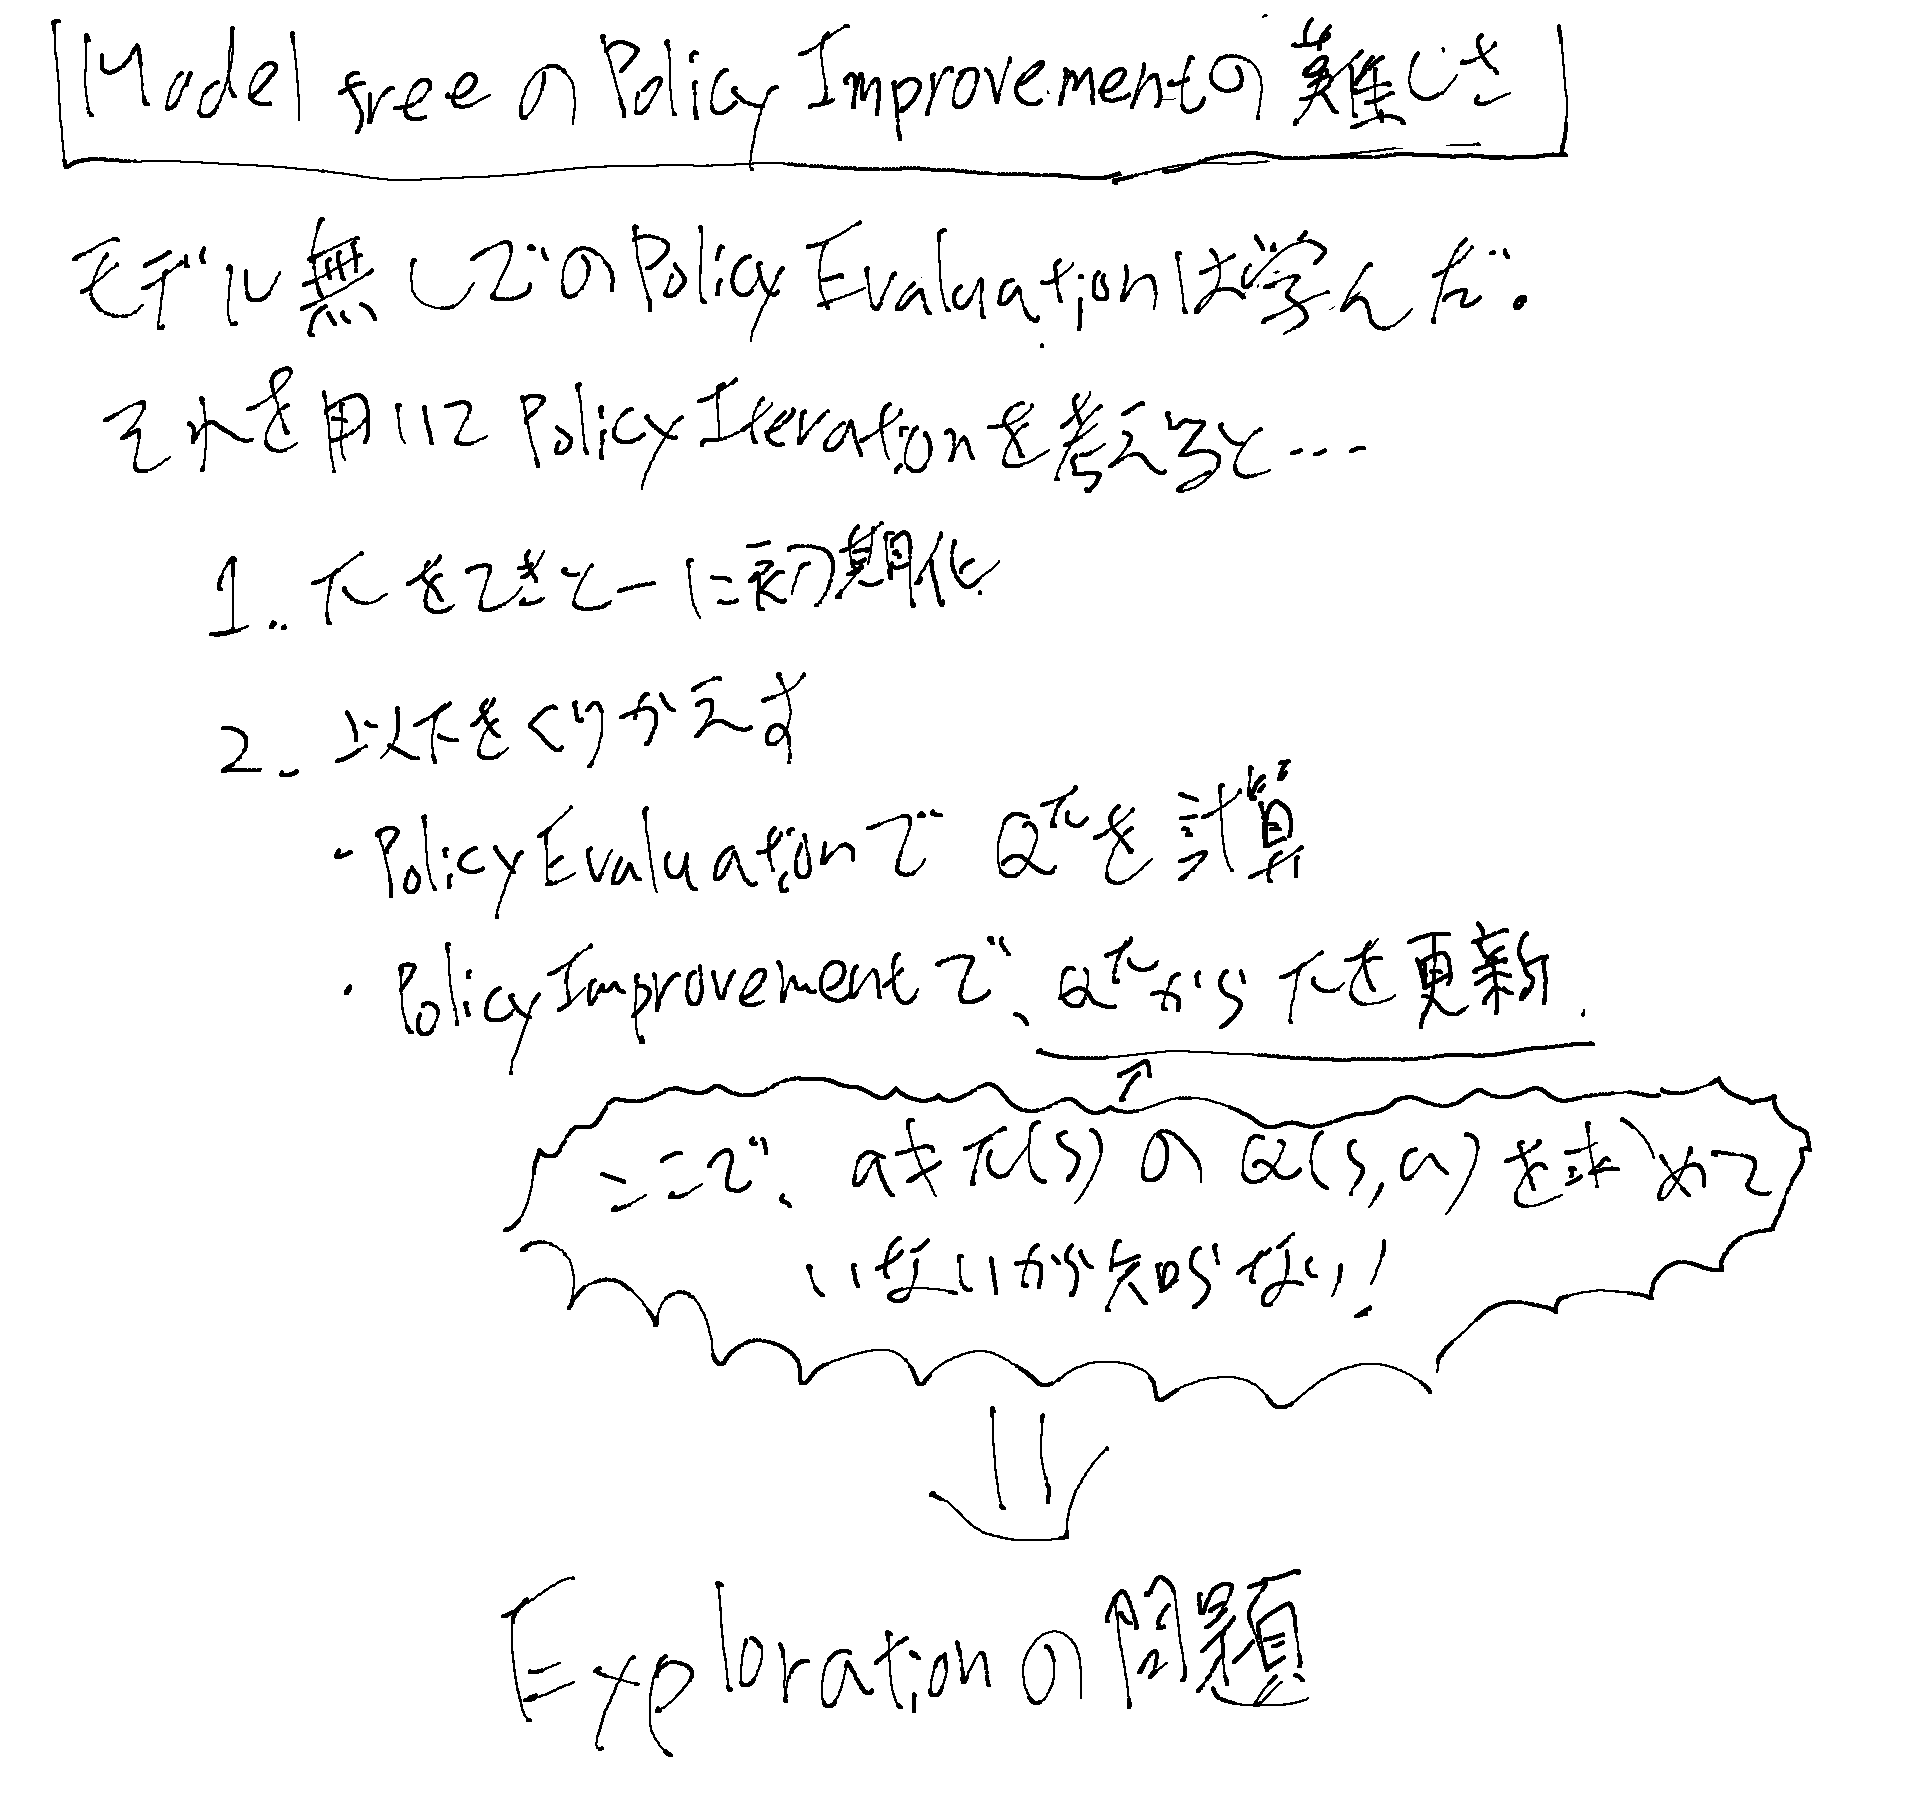
ModelFreePolicyEvaluationでポリシーの良さを評価する事は出来たが、 そのポリシーを改善していく方法を考えるとそんなに簡単では無い。
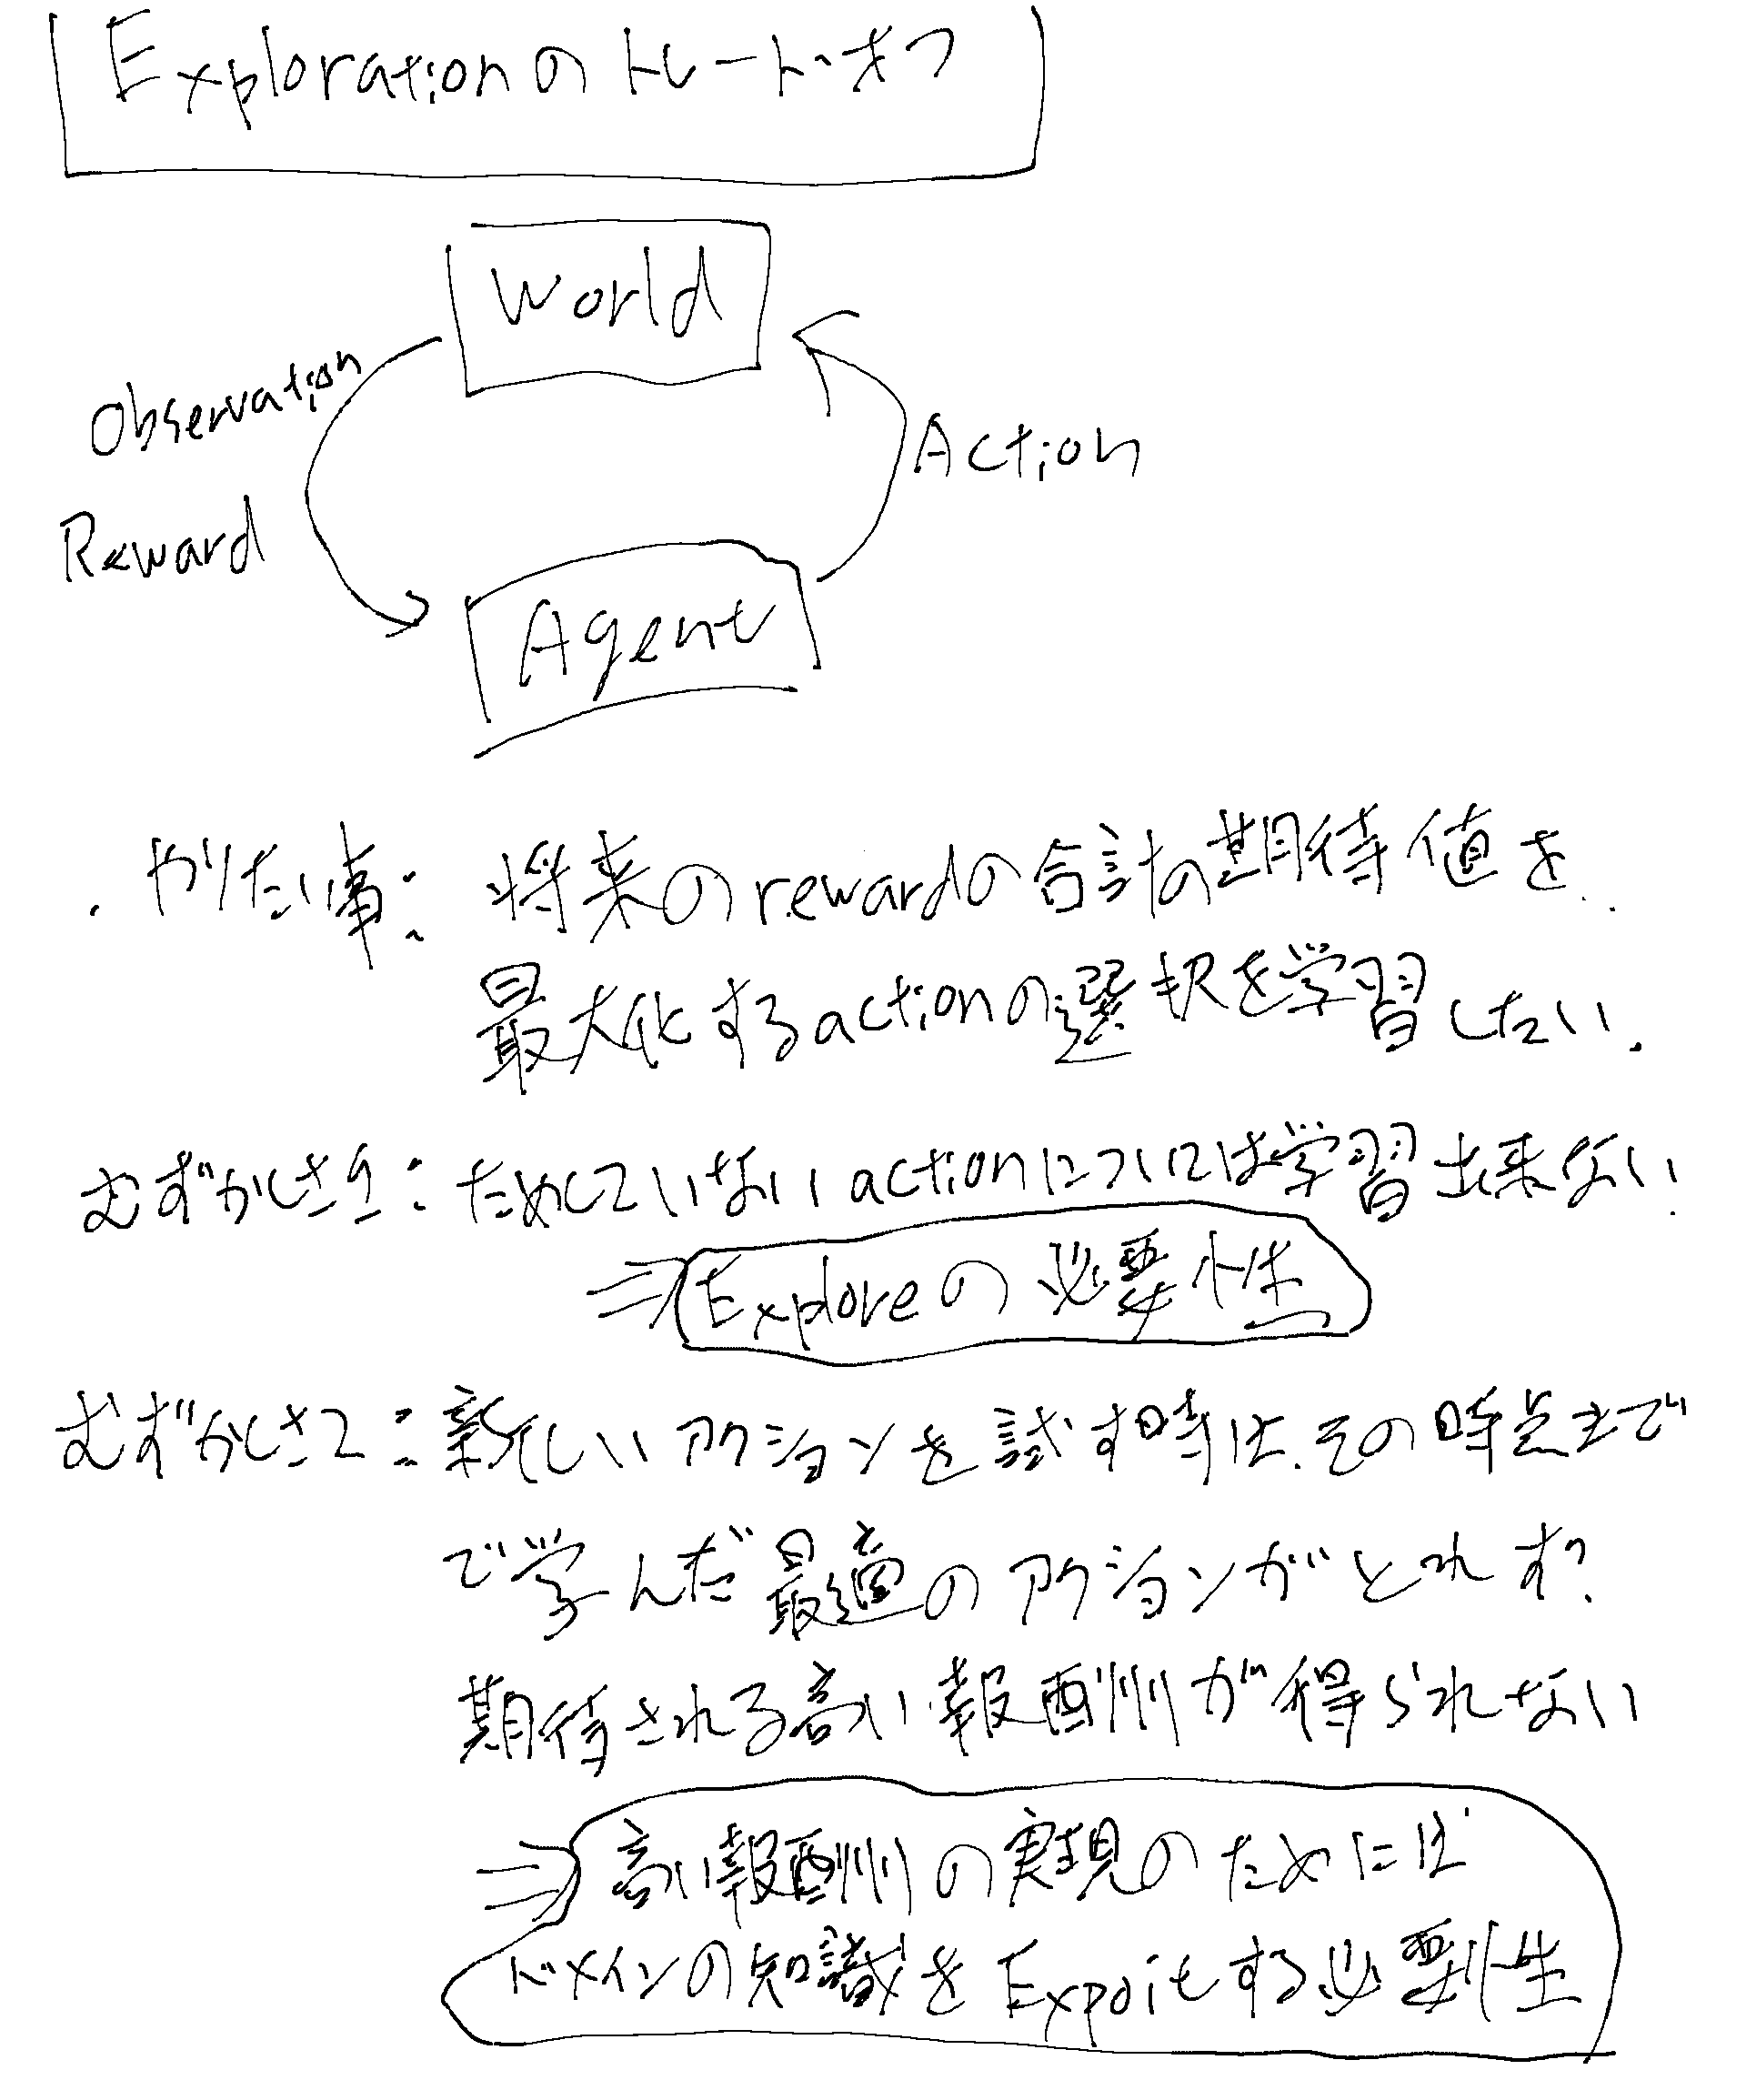
MarkovDecisionProcessの時のPolicy Improvementと同じように考えると、arg maxのQを求めたくなるが、モデルフリーの場合Policy Evaluationで求めたQはまだ試した事が無いactionについては知らないのでarg maxを求められない。
Exploration
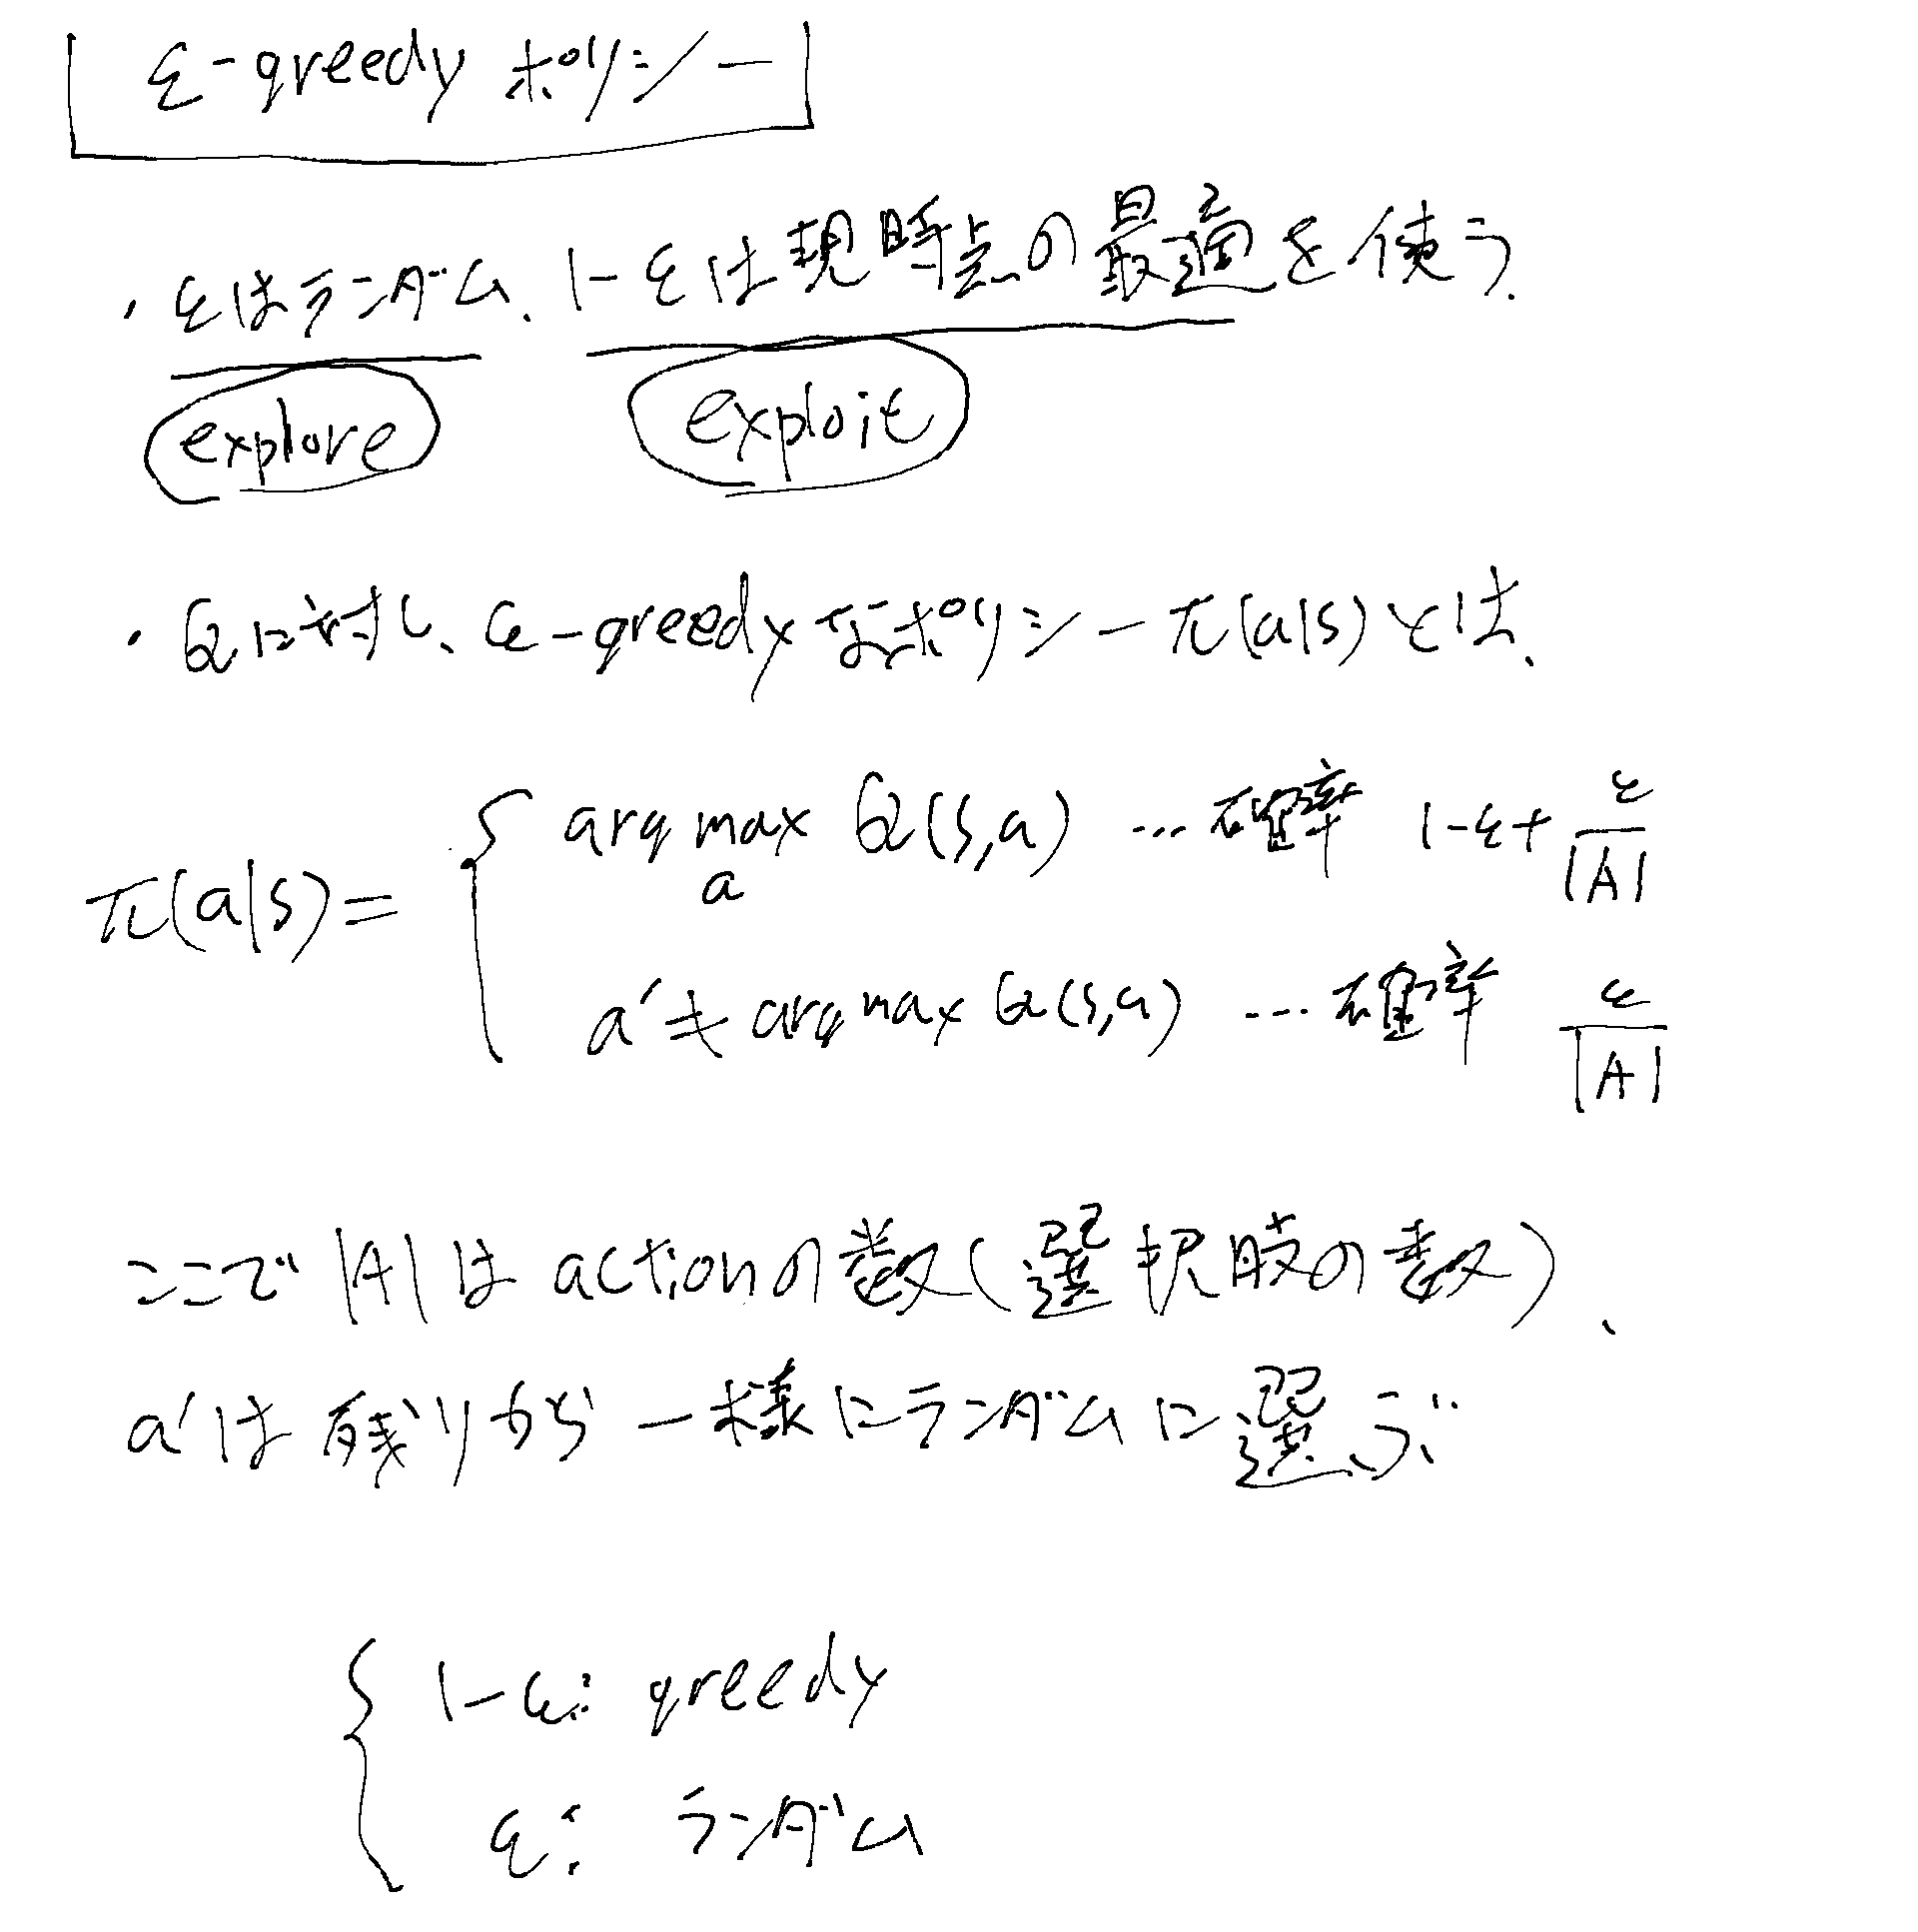
ε-greedyポリシー
ε-greedyポリシーでのPolicy Improvementの性質
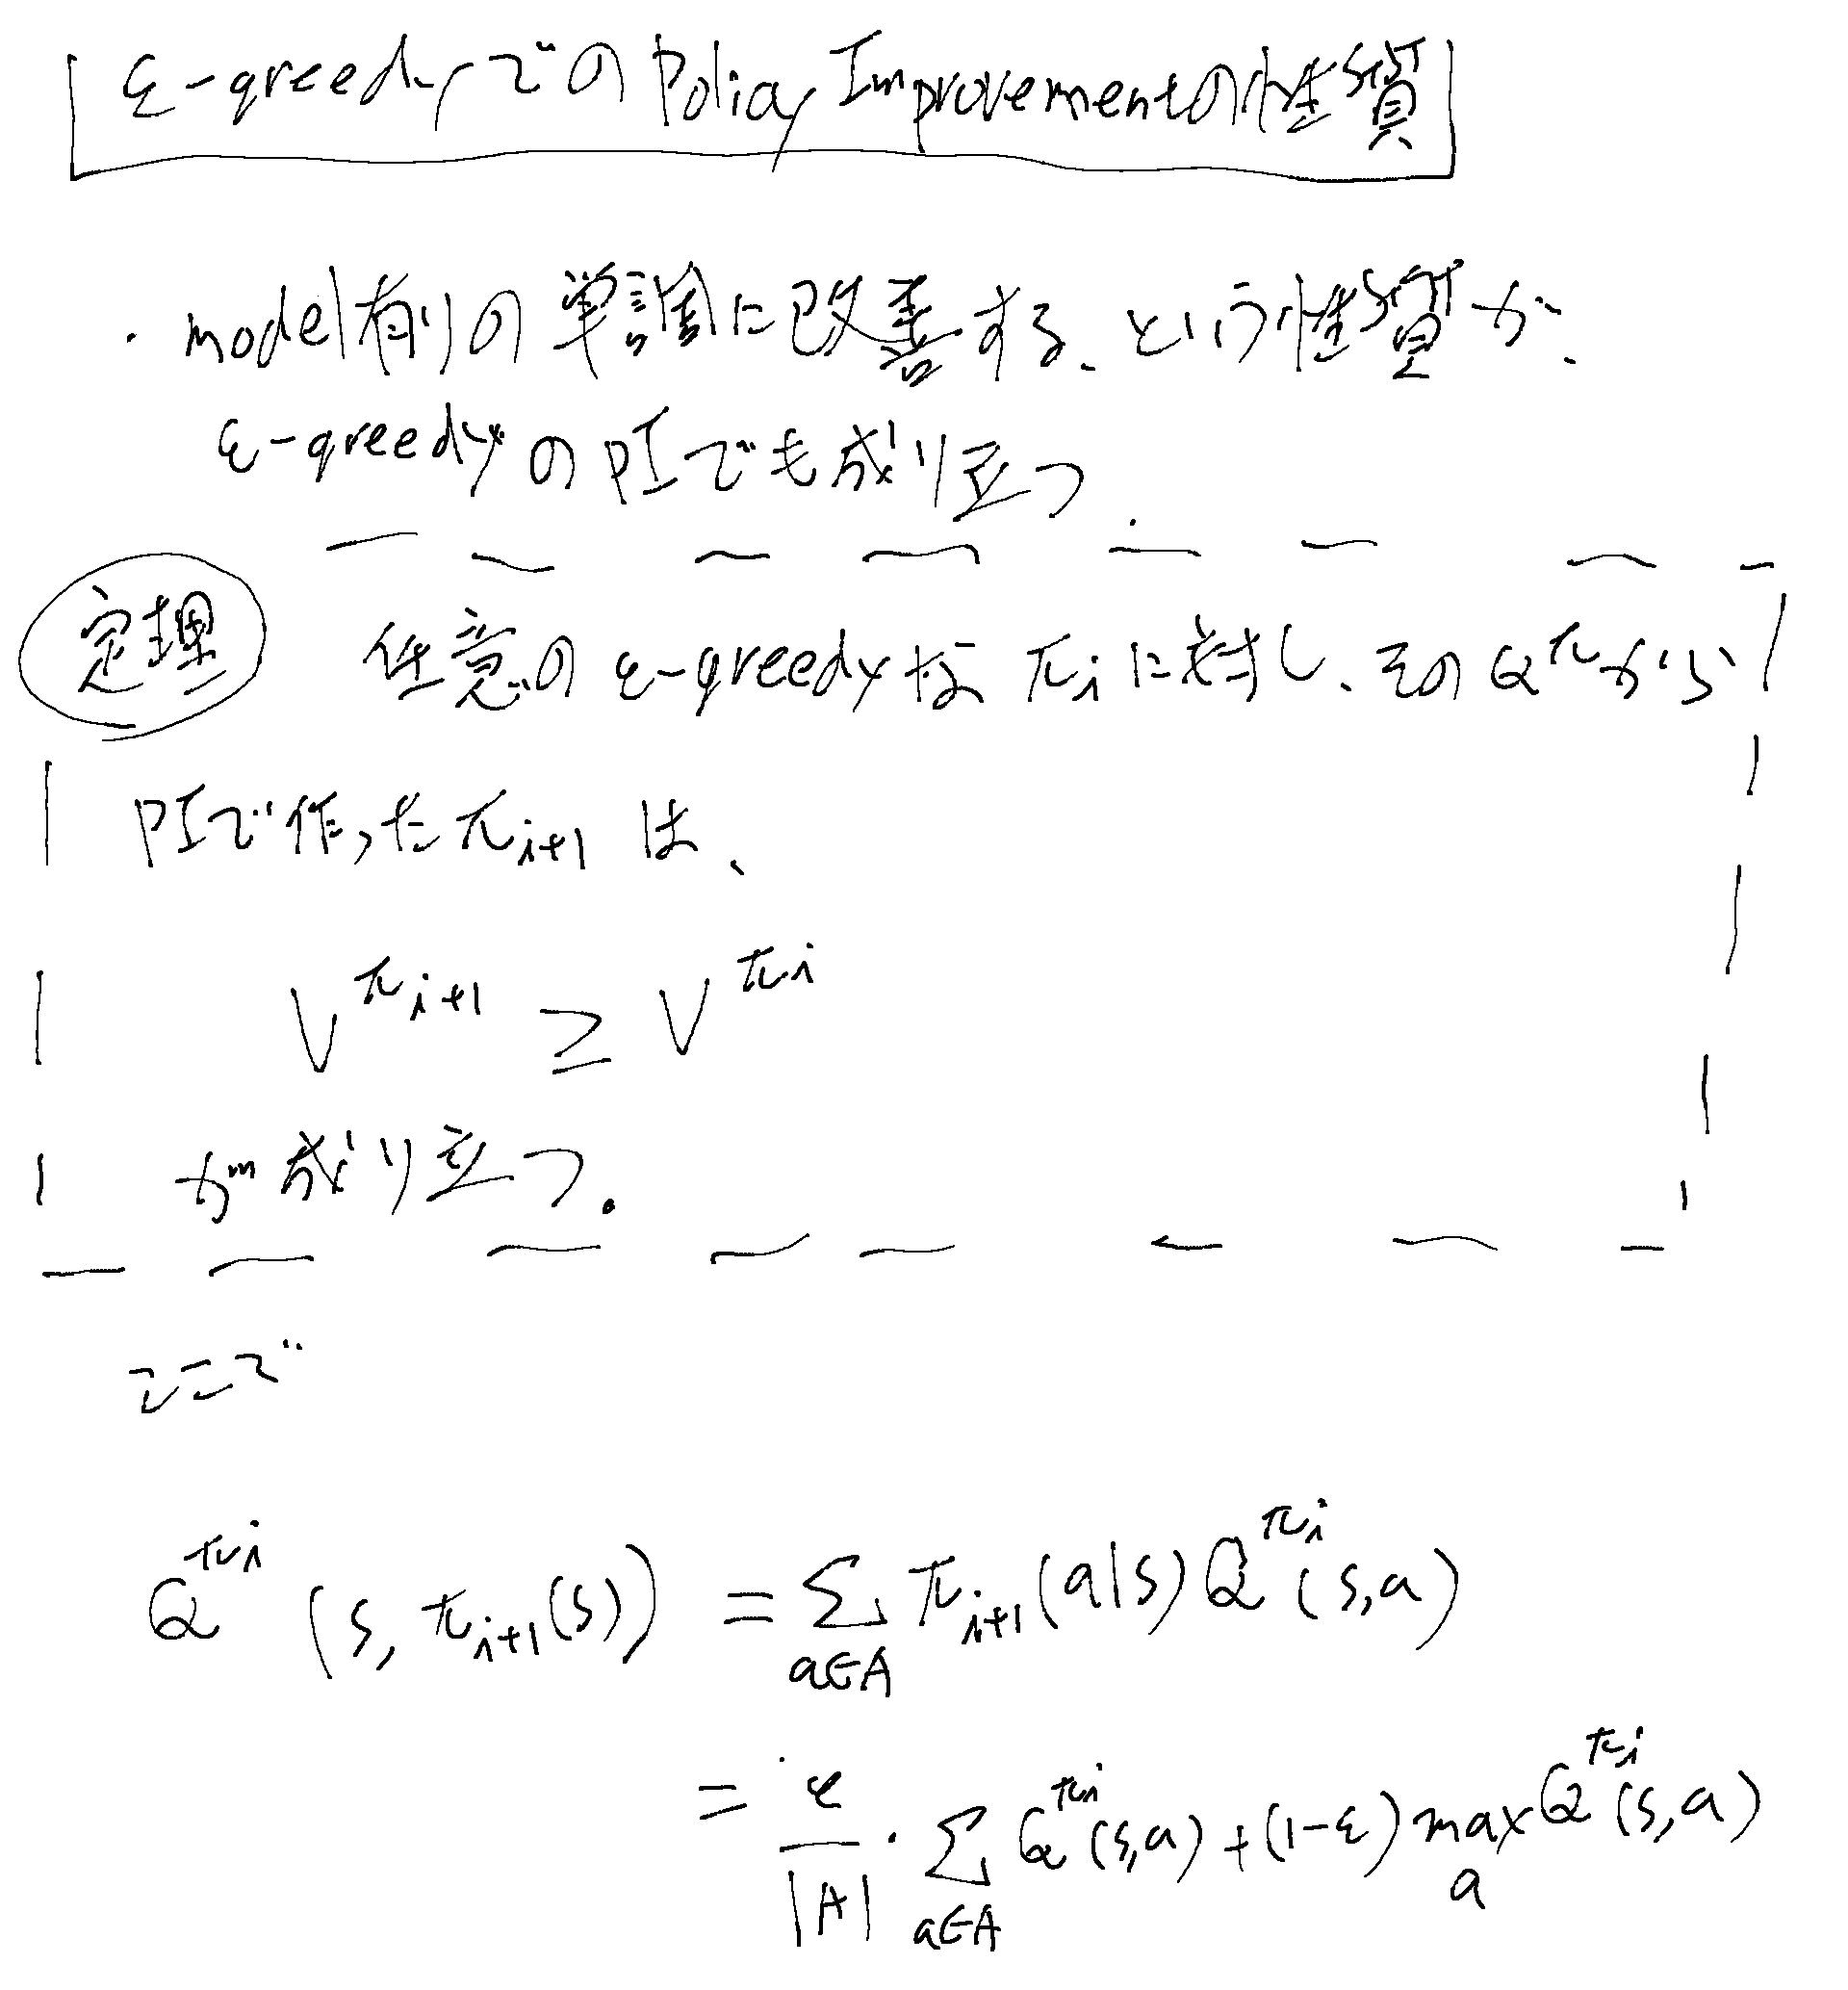
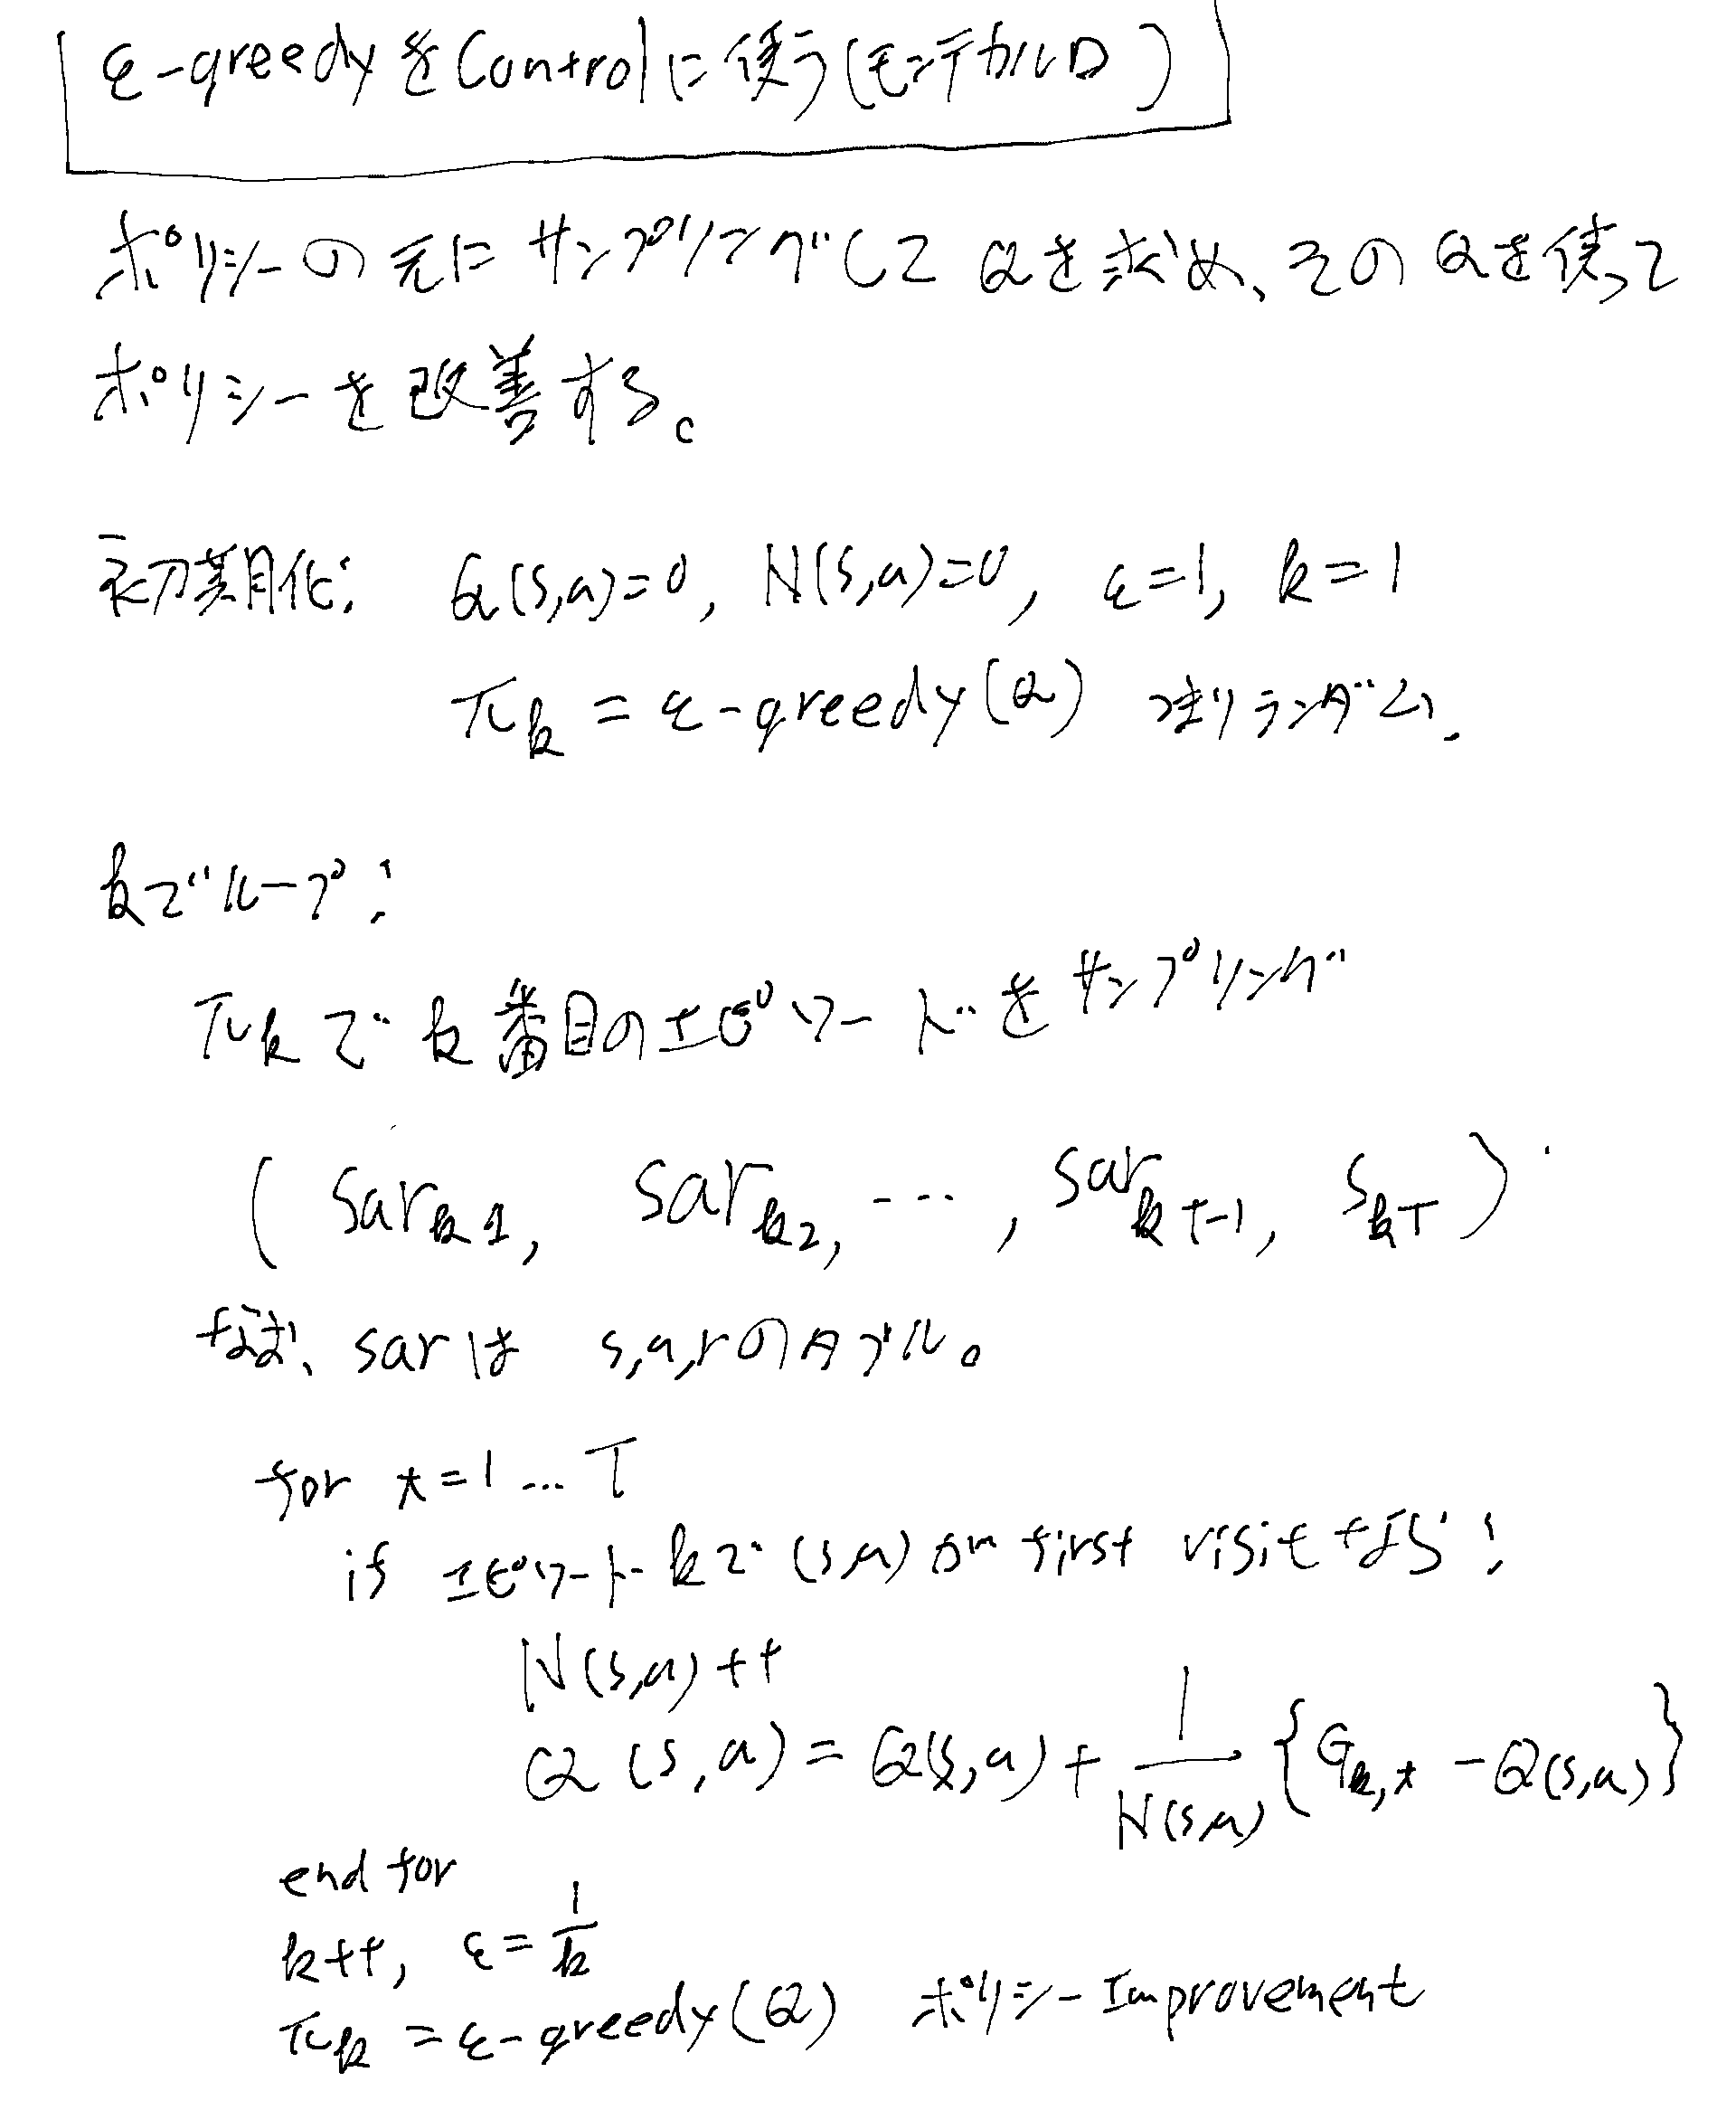
ε-greedyポリシーをControlに使う(MC Control)
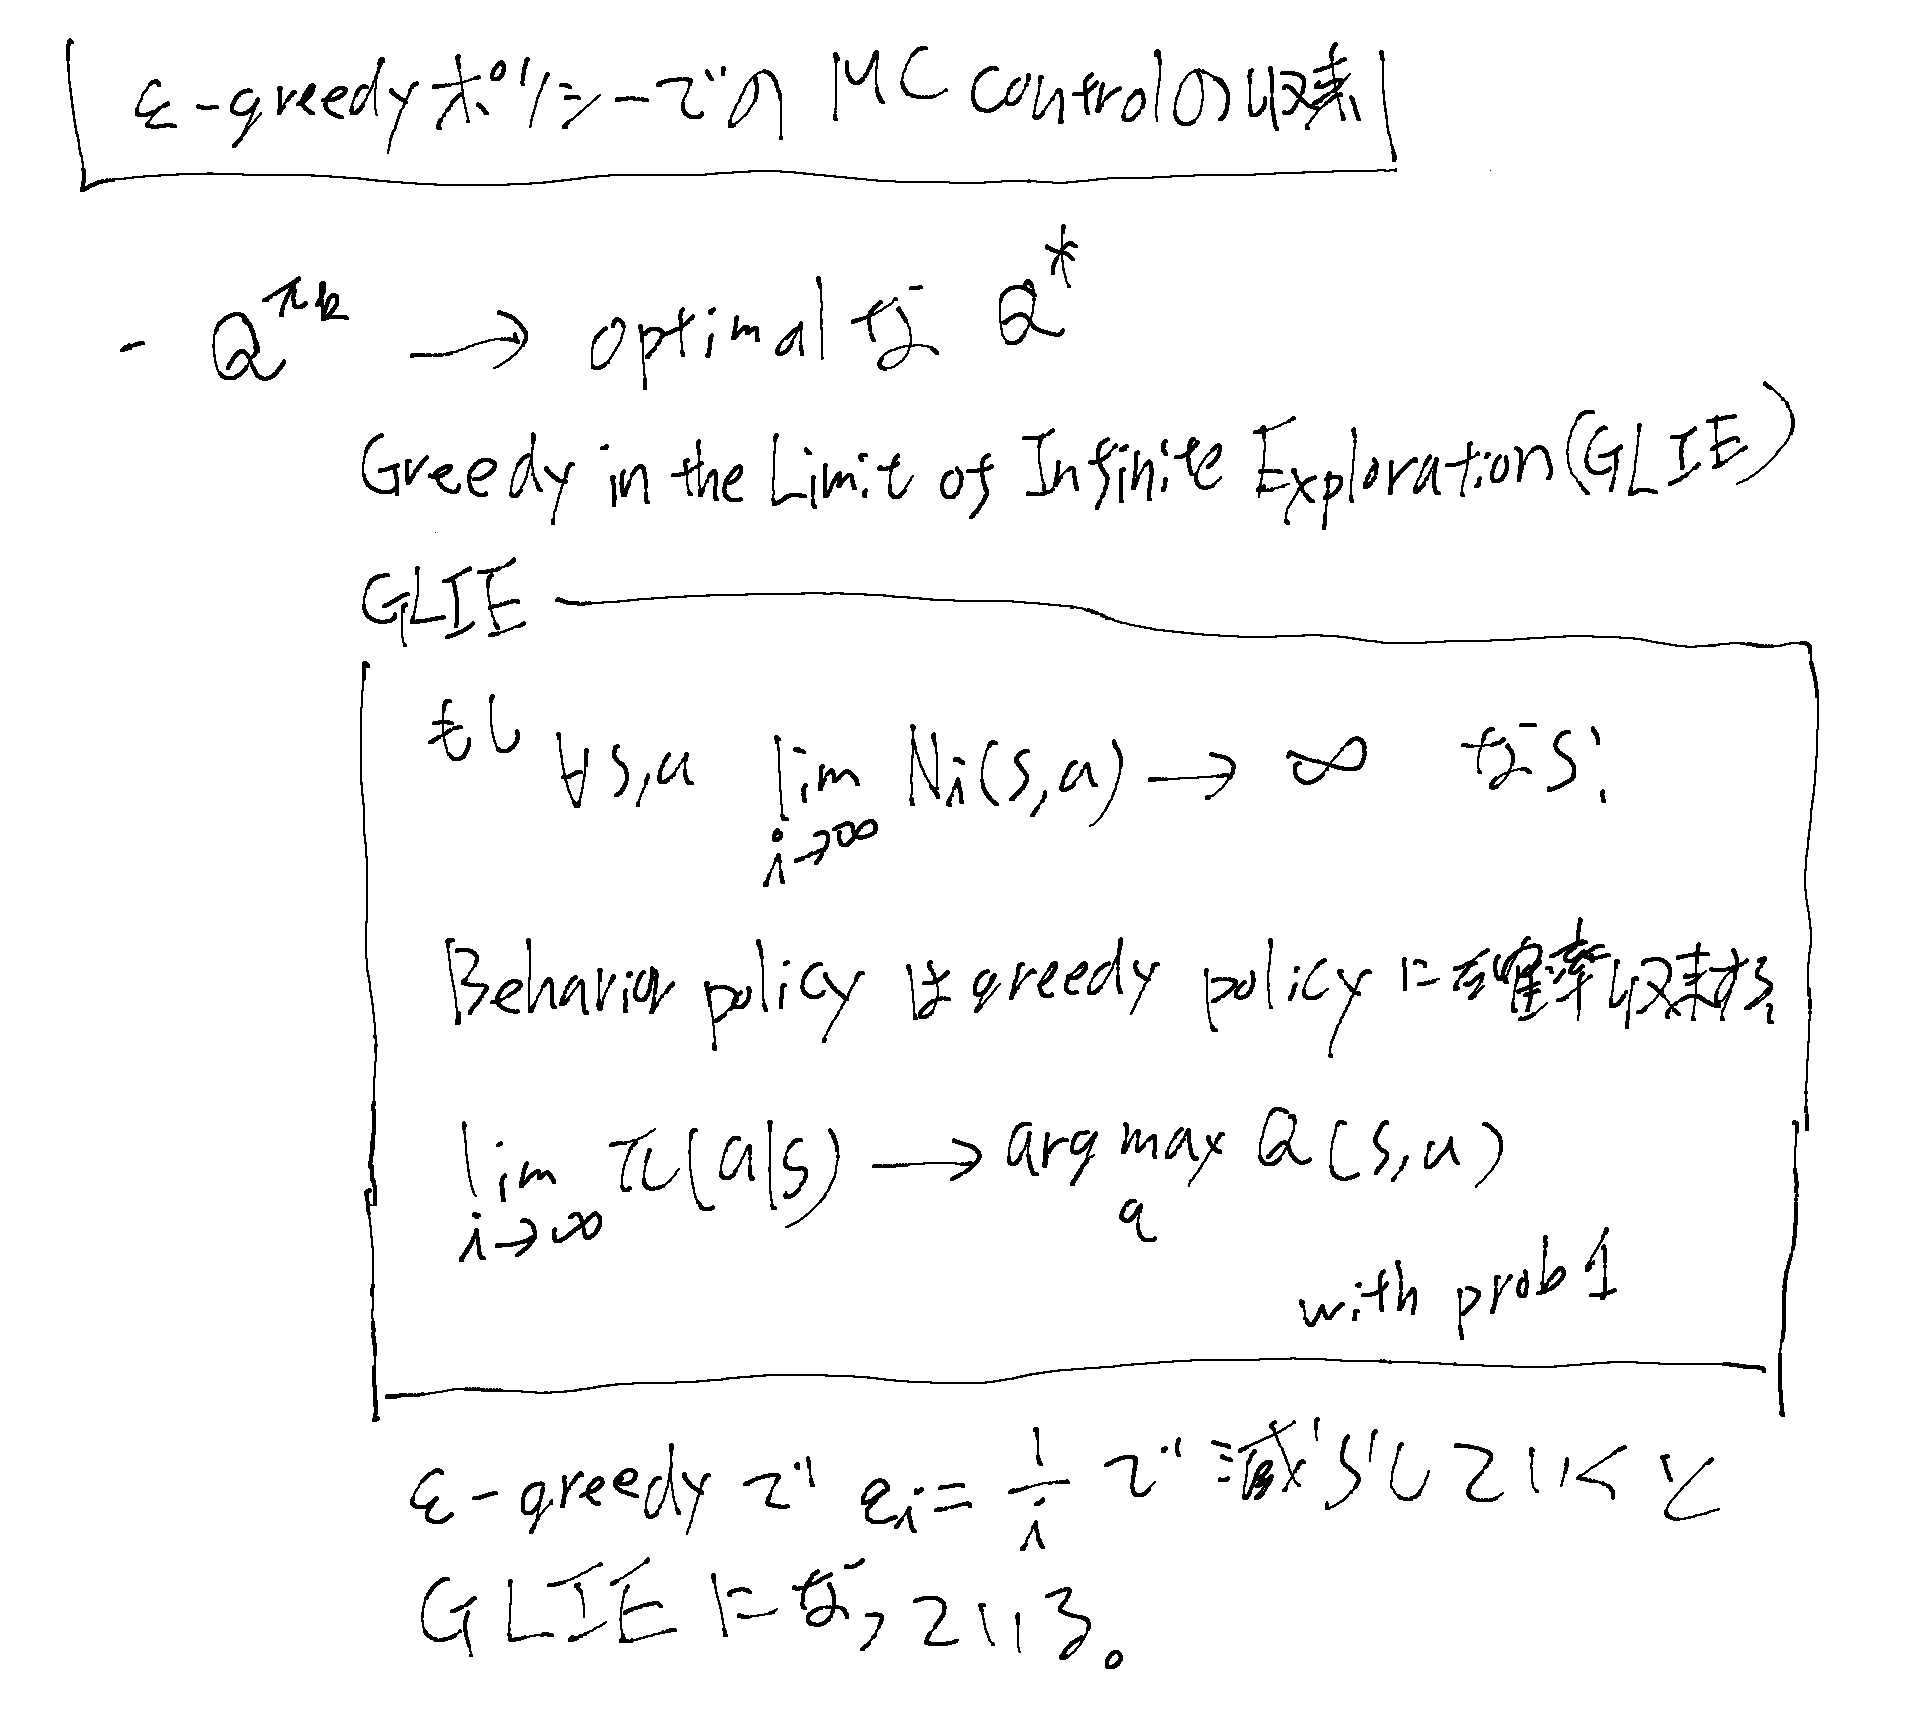
GLIEとε-greedyポリシーでのMC Controlの収束
TDコントロール
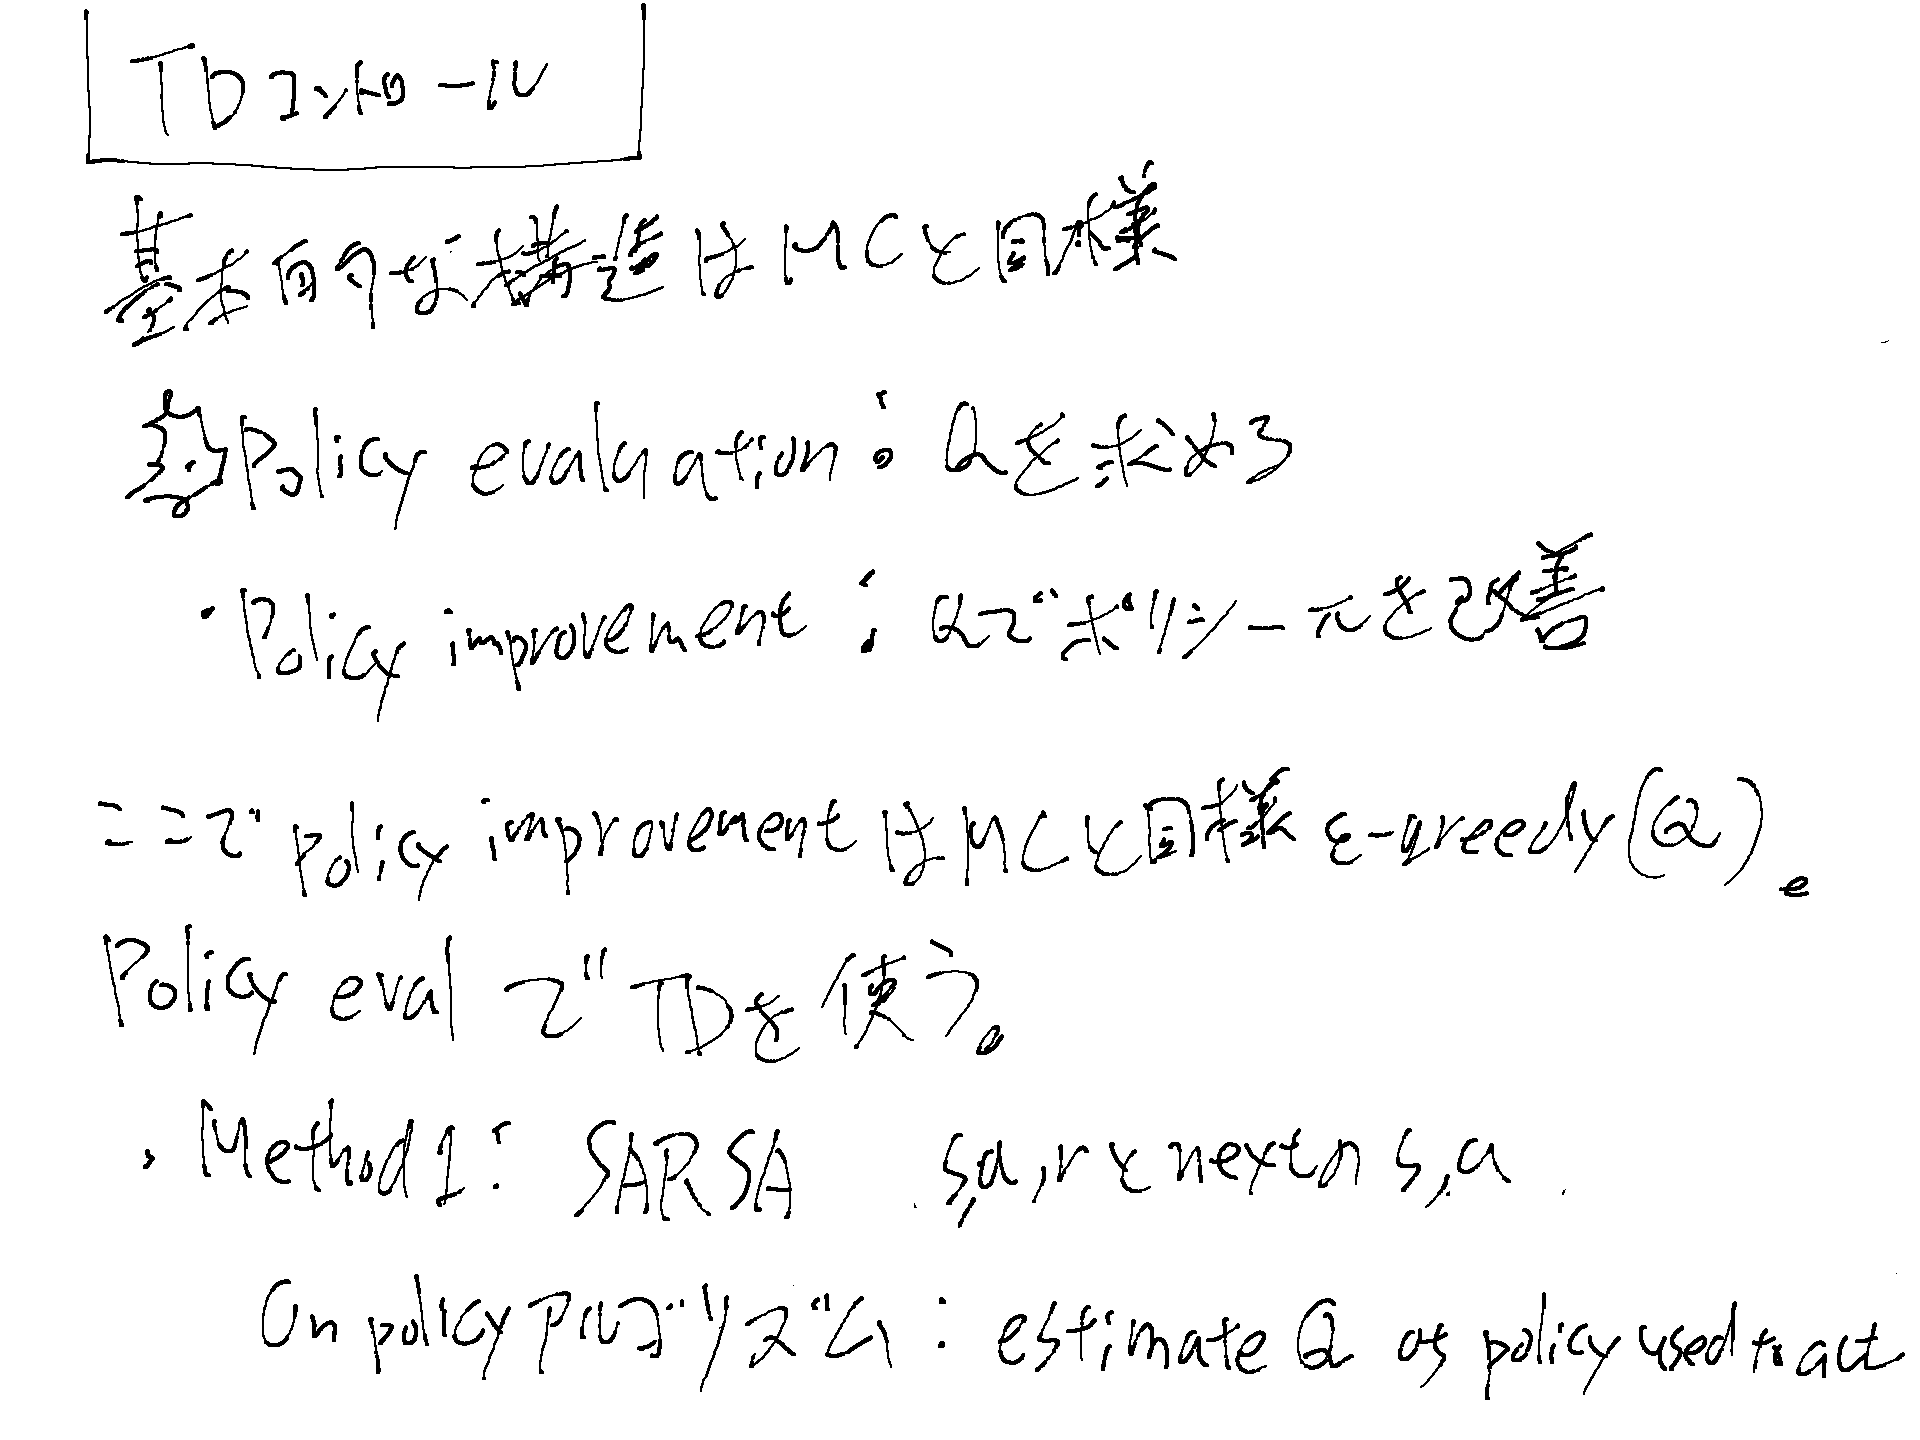
TDLearningではVを推計したが、Qを推計するにはアクションが必要となる。 良く使われるのは以下の二つ。
- SARSA(オンポリシー手法の一つ)
- Q-Learning(オフポリシー手法の一つ)
SARSA
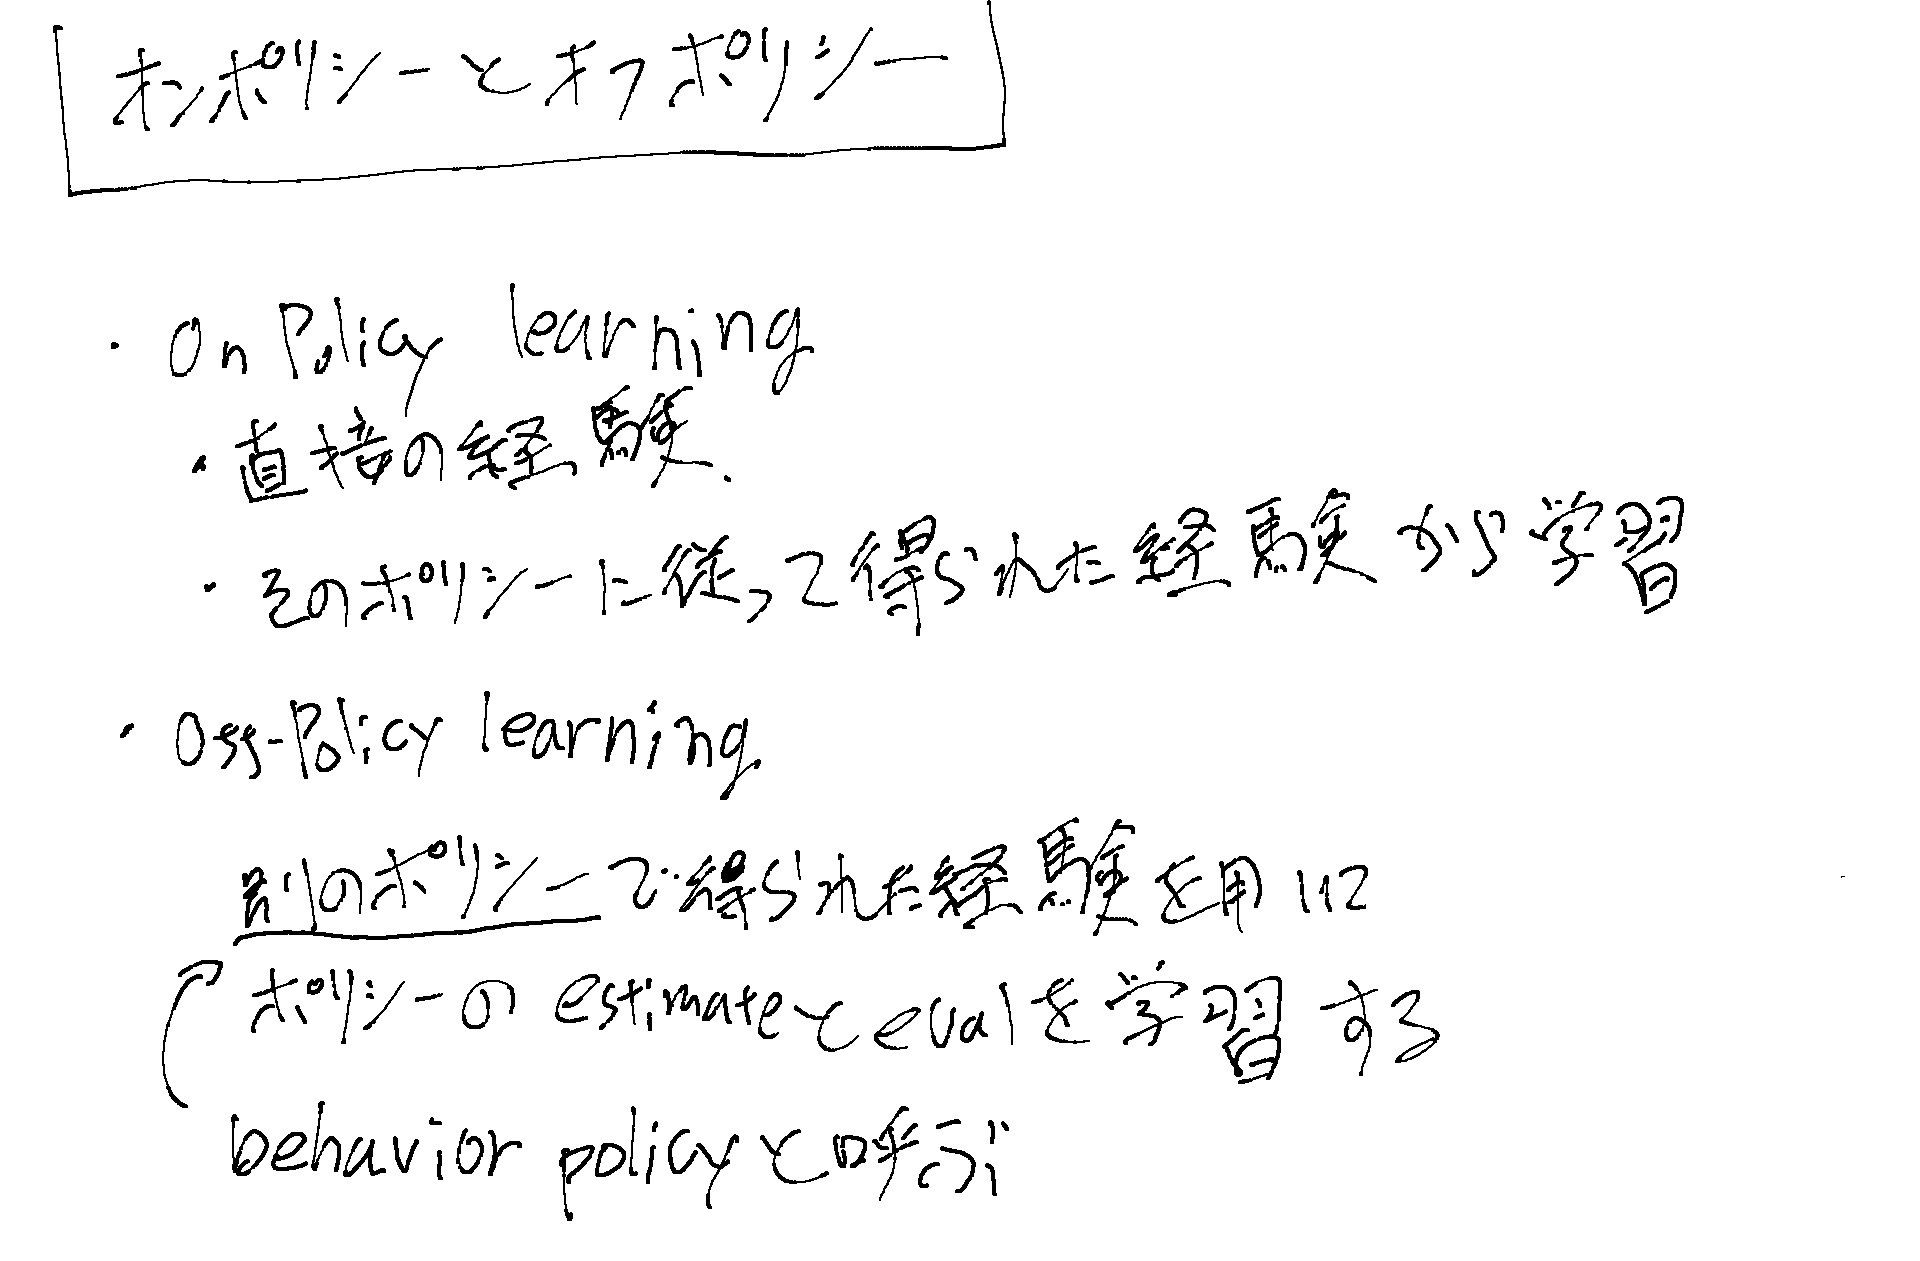
オンポリシーとオフポリシー