Value関数の関数近似
Less than 1 minute
Value関数の関数近似
ModelFreePolicyImprovementより。Value Function ApproximationでVFA。
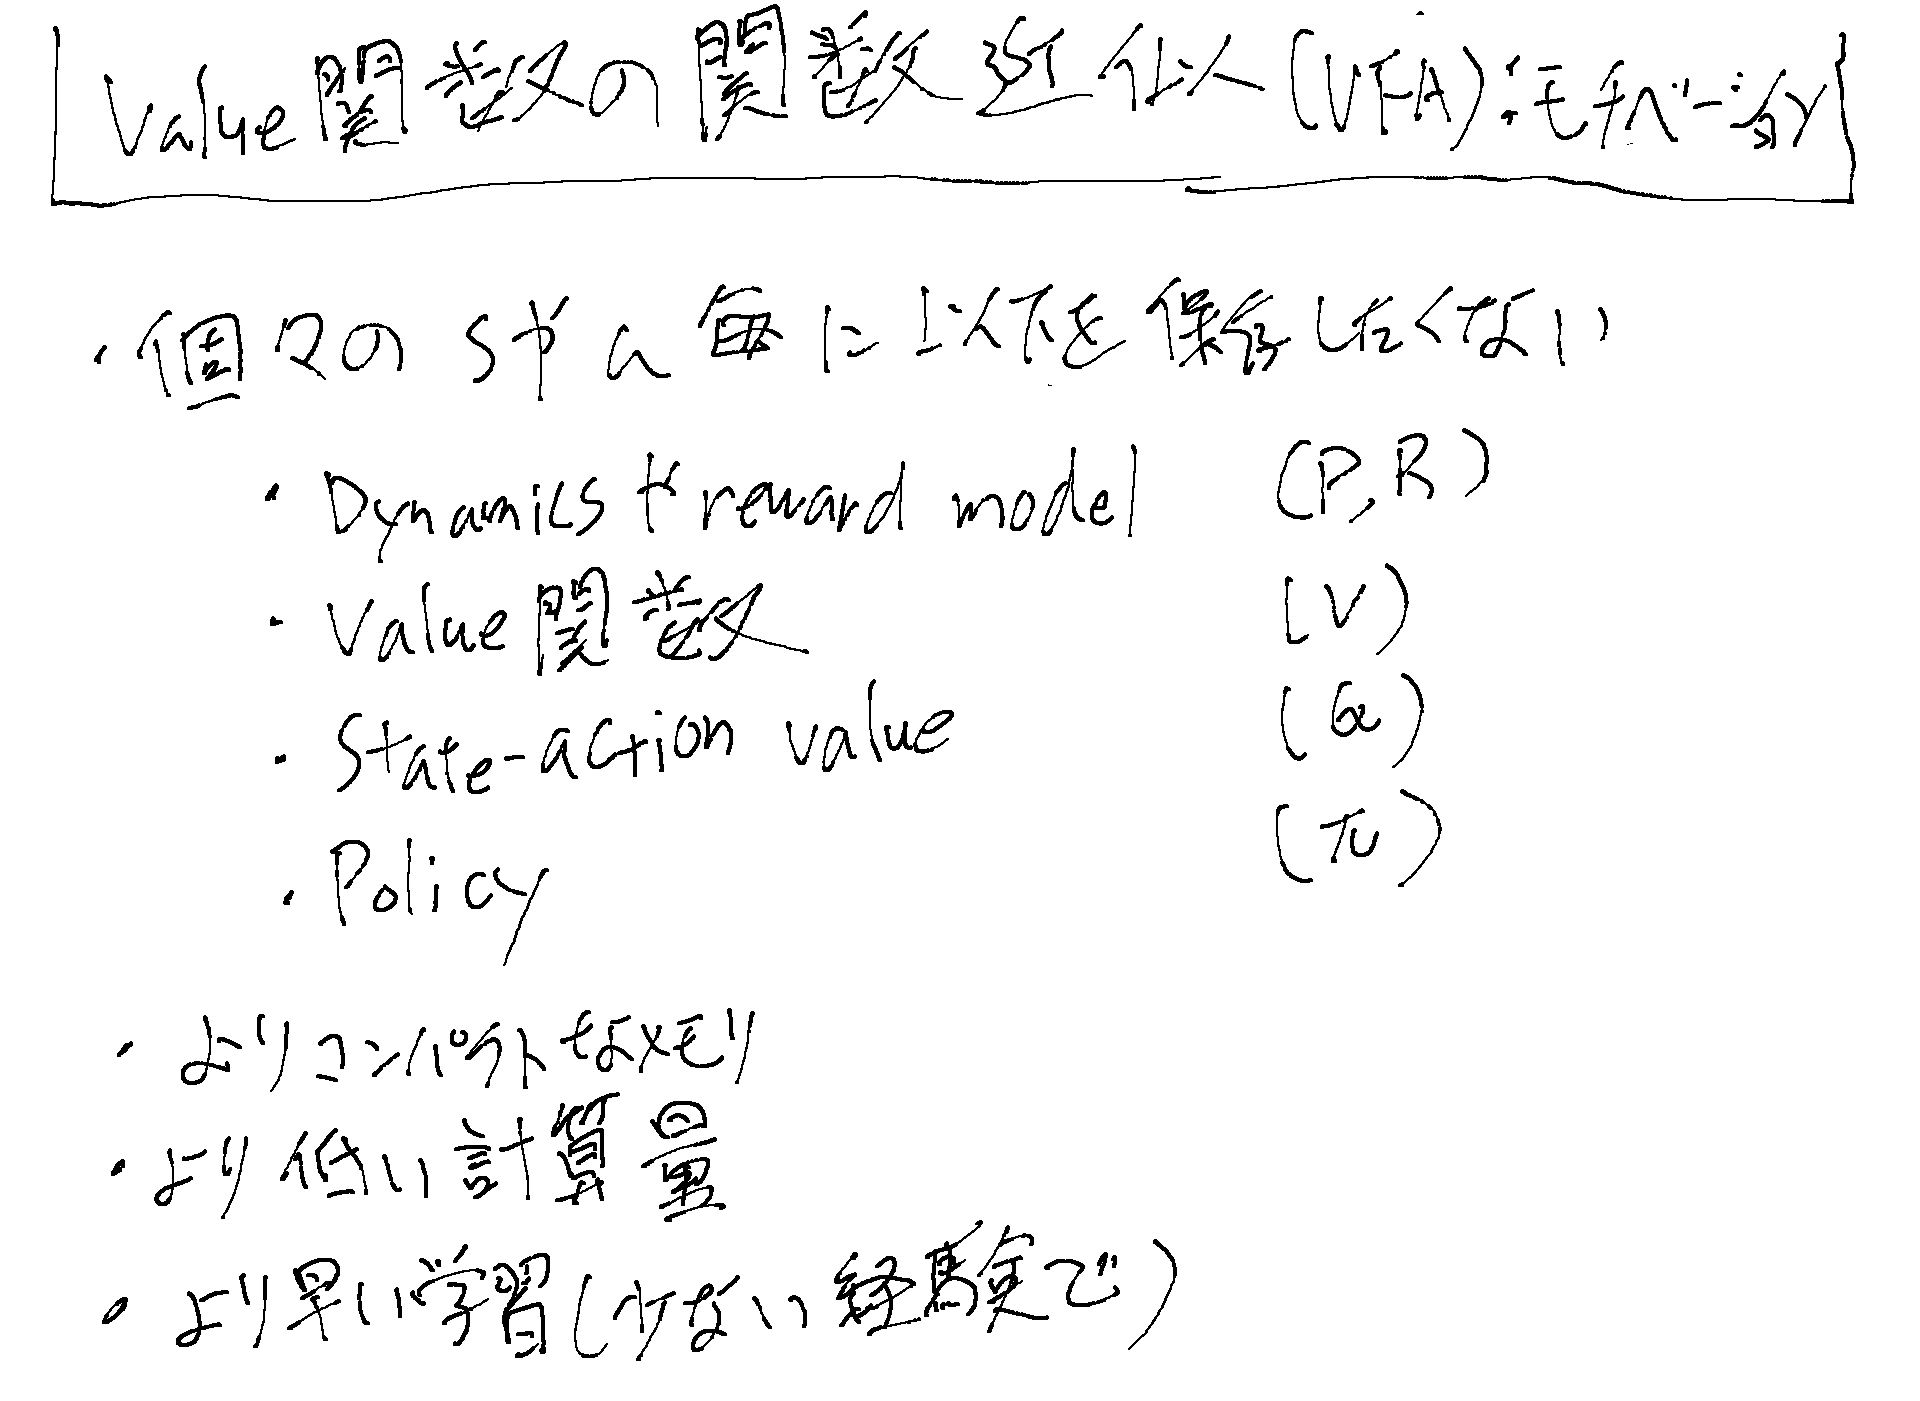
モチベーション
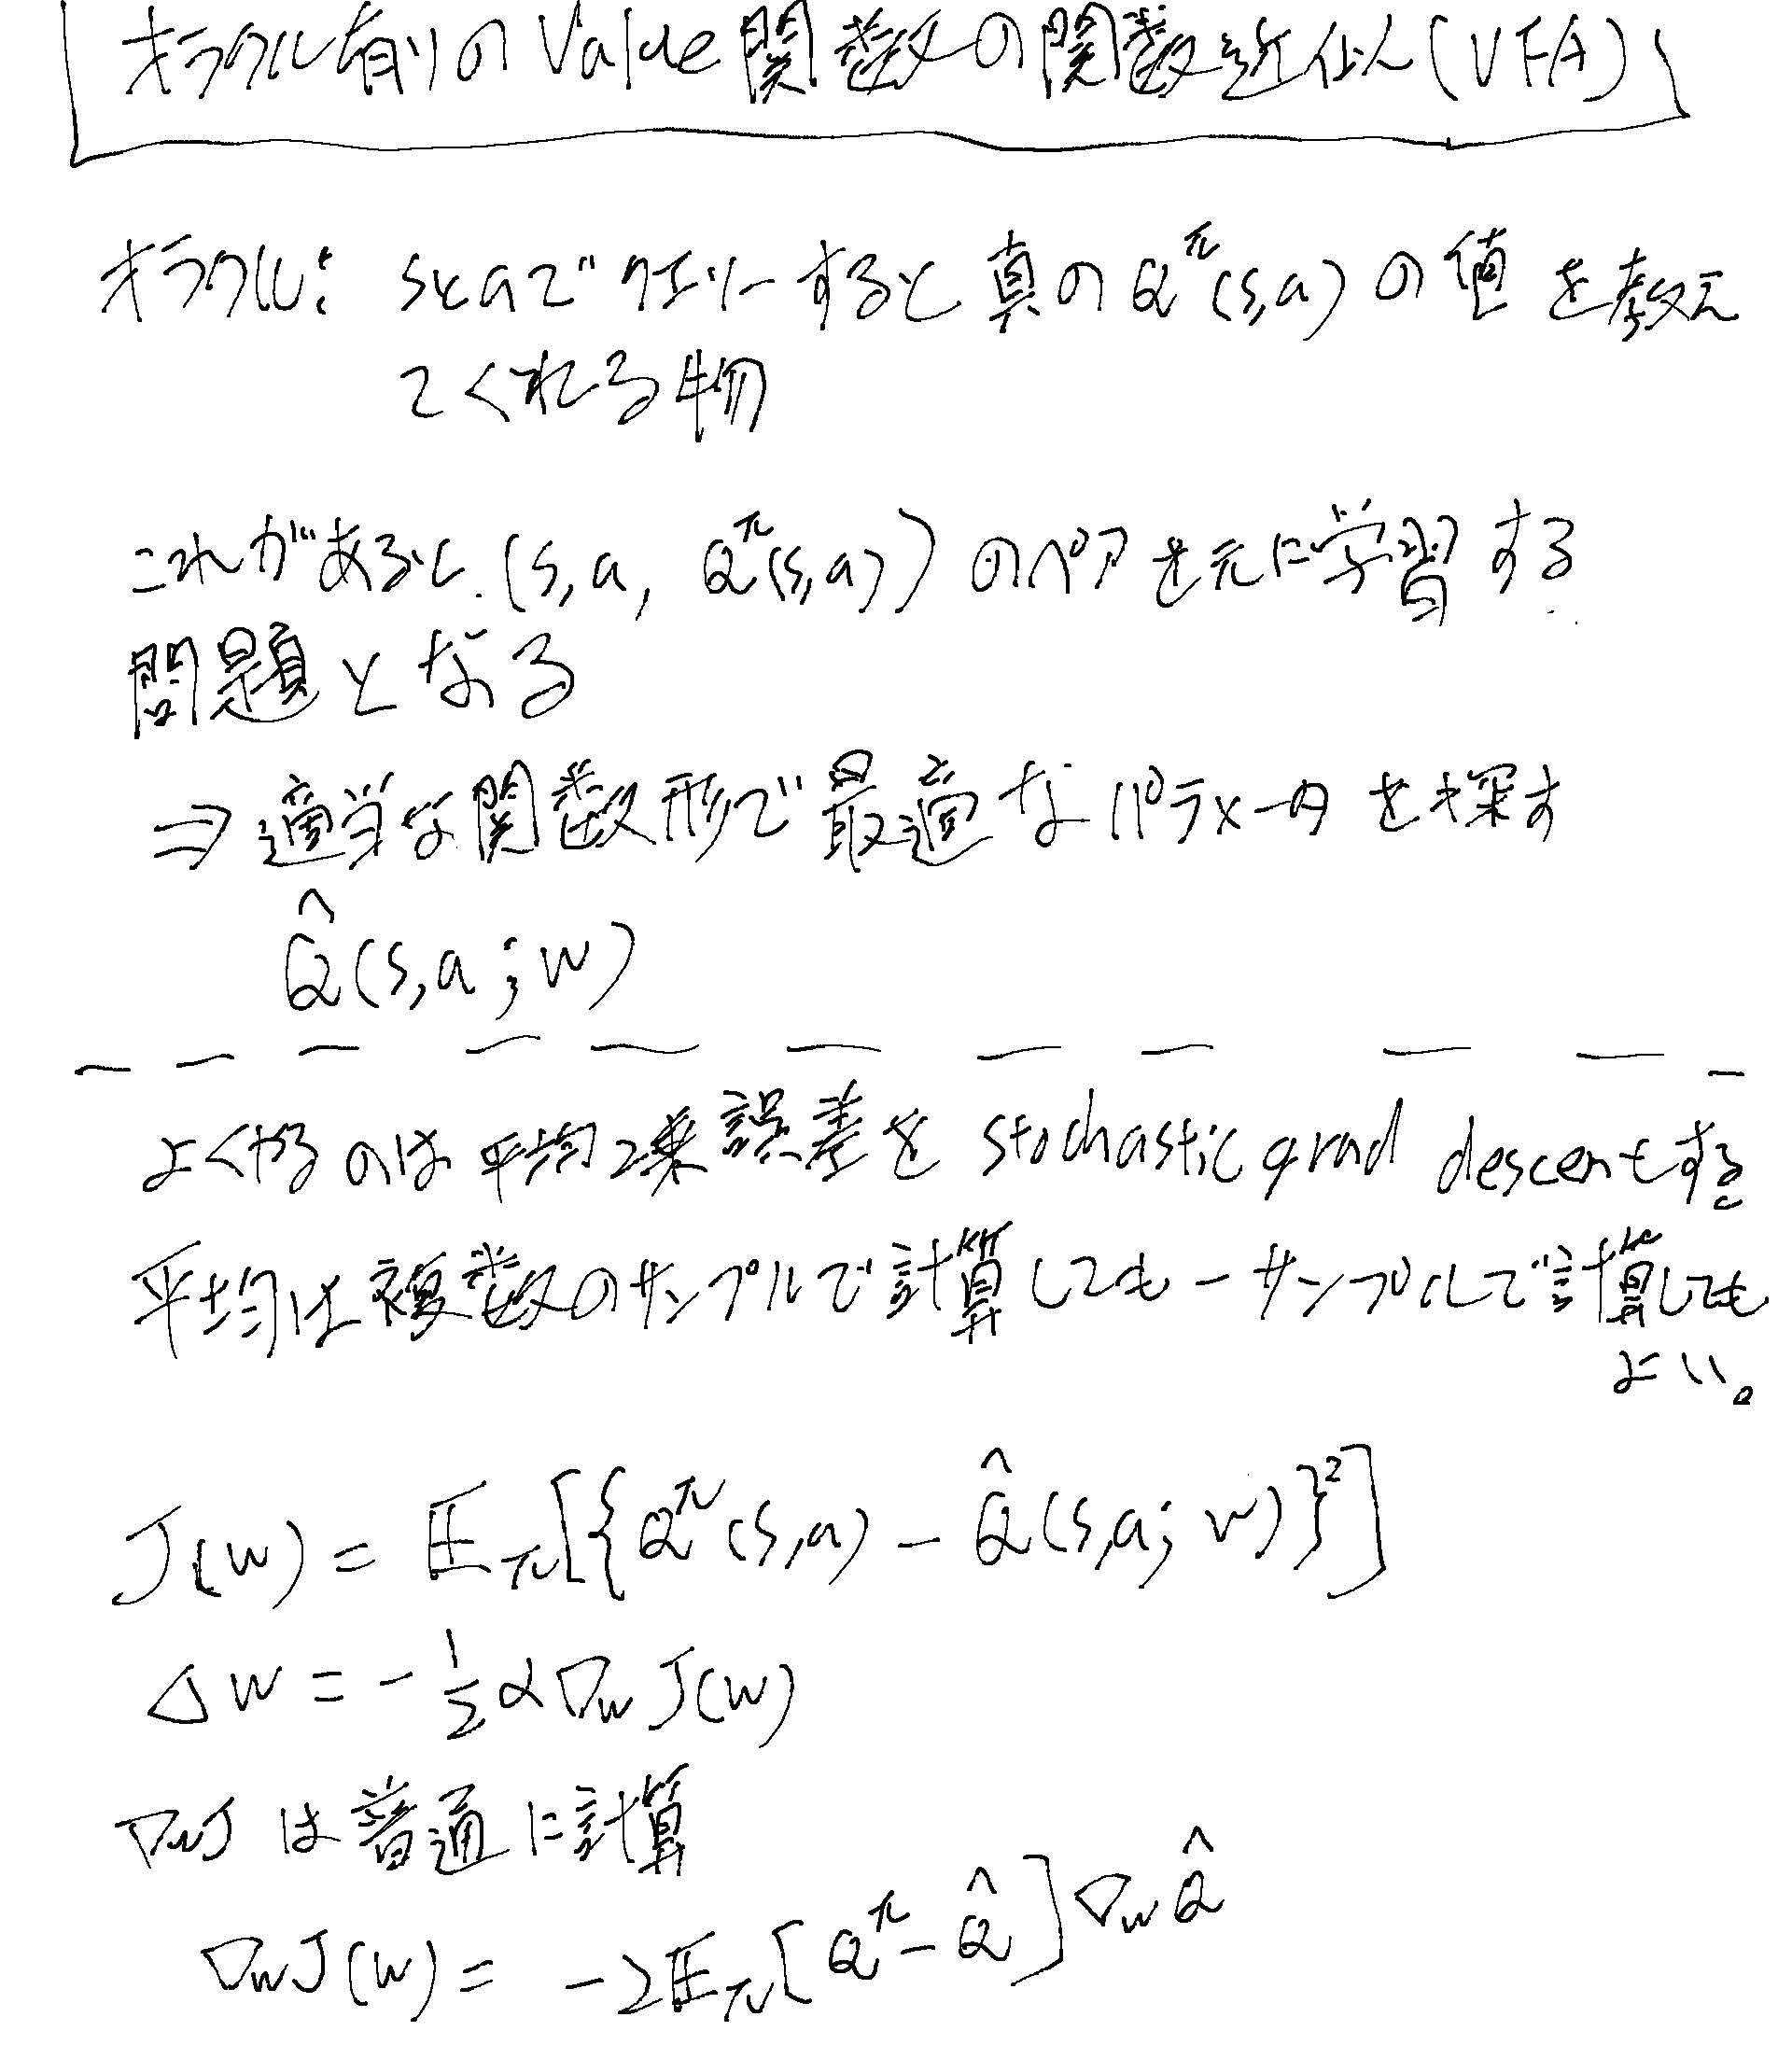
オラクルありのケース
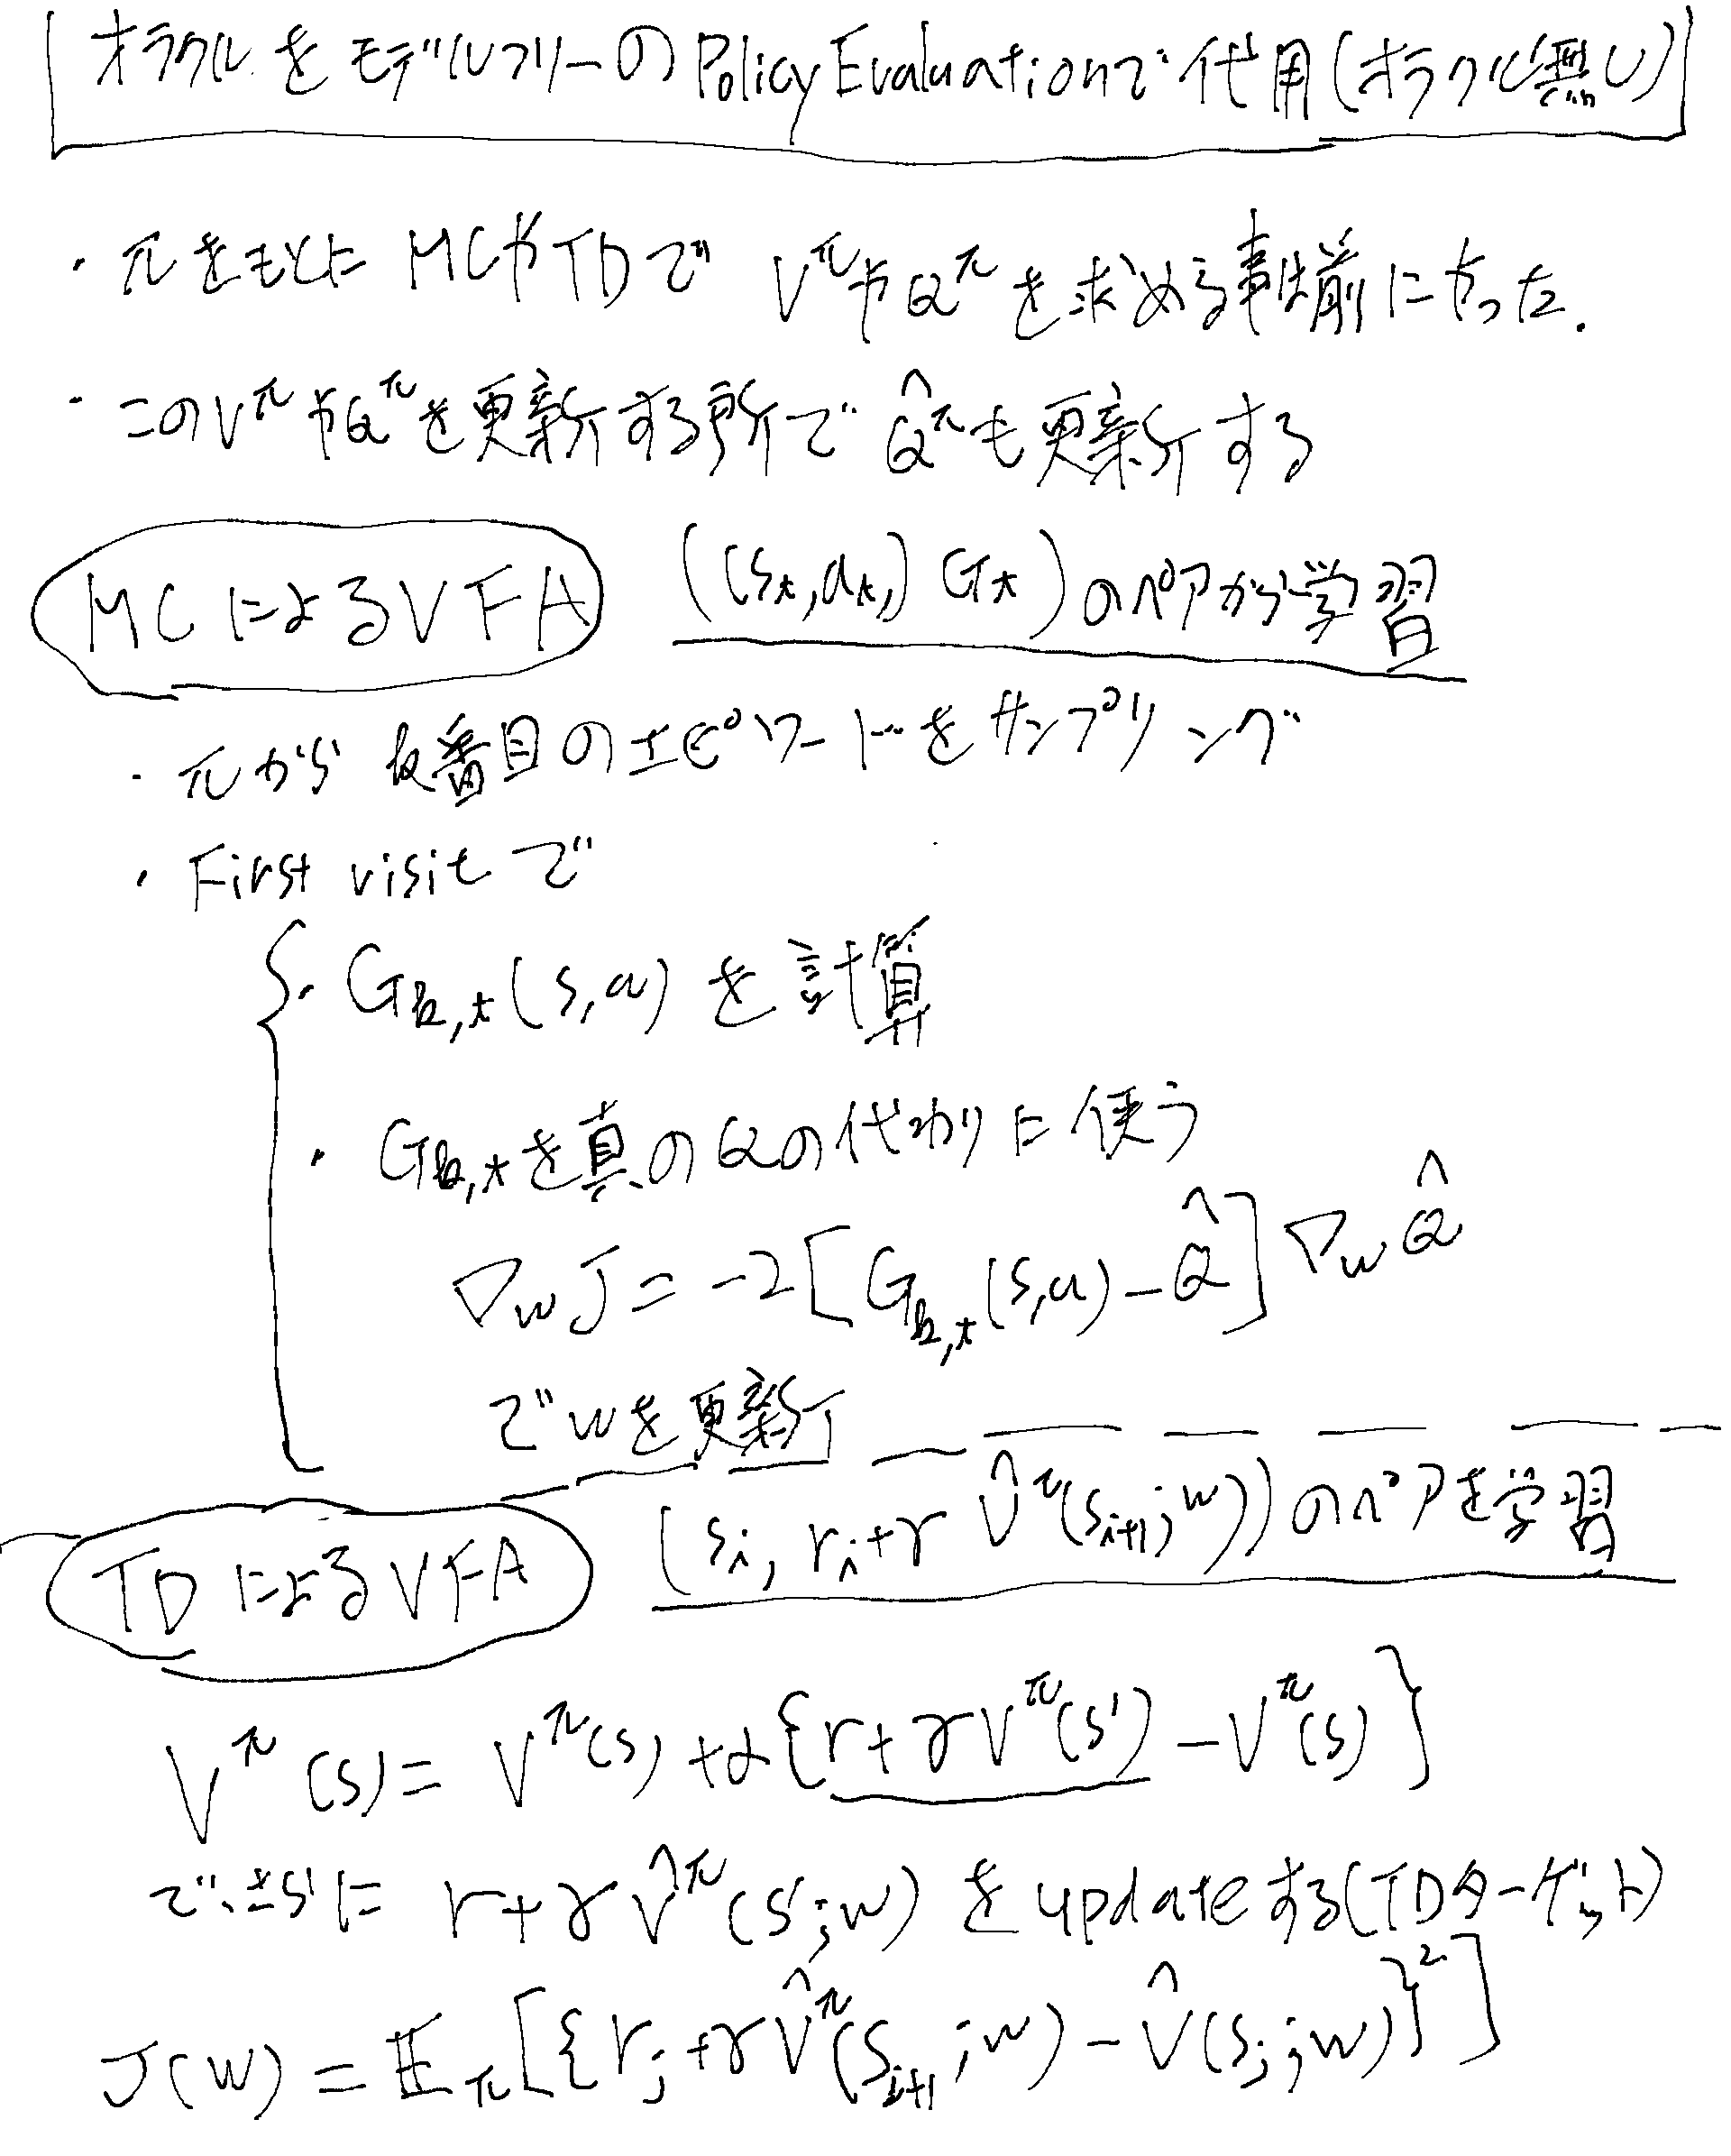
オラクルをModel FreeのPolicy Evaluationで代用
ModelFreePolicyEvaluationでやったMCとTDをオラクルの代わりに使う。
TDでVFAする時にQでは無くVを学習しているのは、TDのケースではTD targetsの作り方にMCよりも自由度があっていろいろなケースが考えられるので、 まずはVを学習する話をしている。
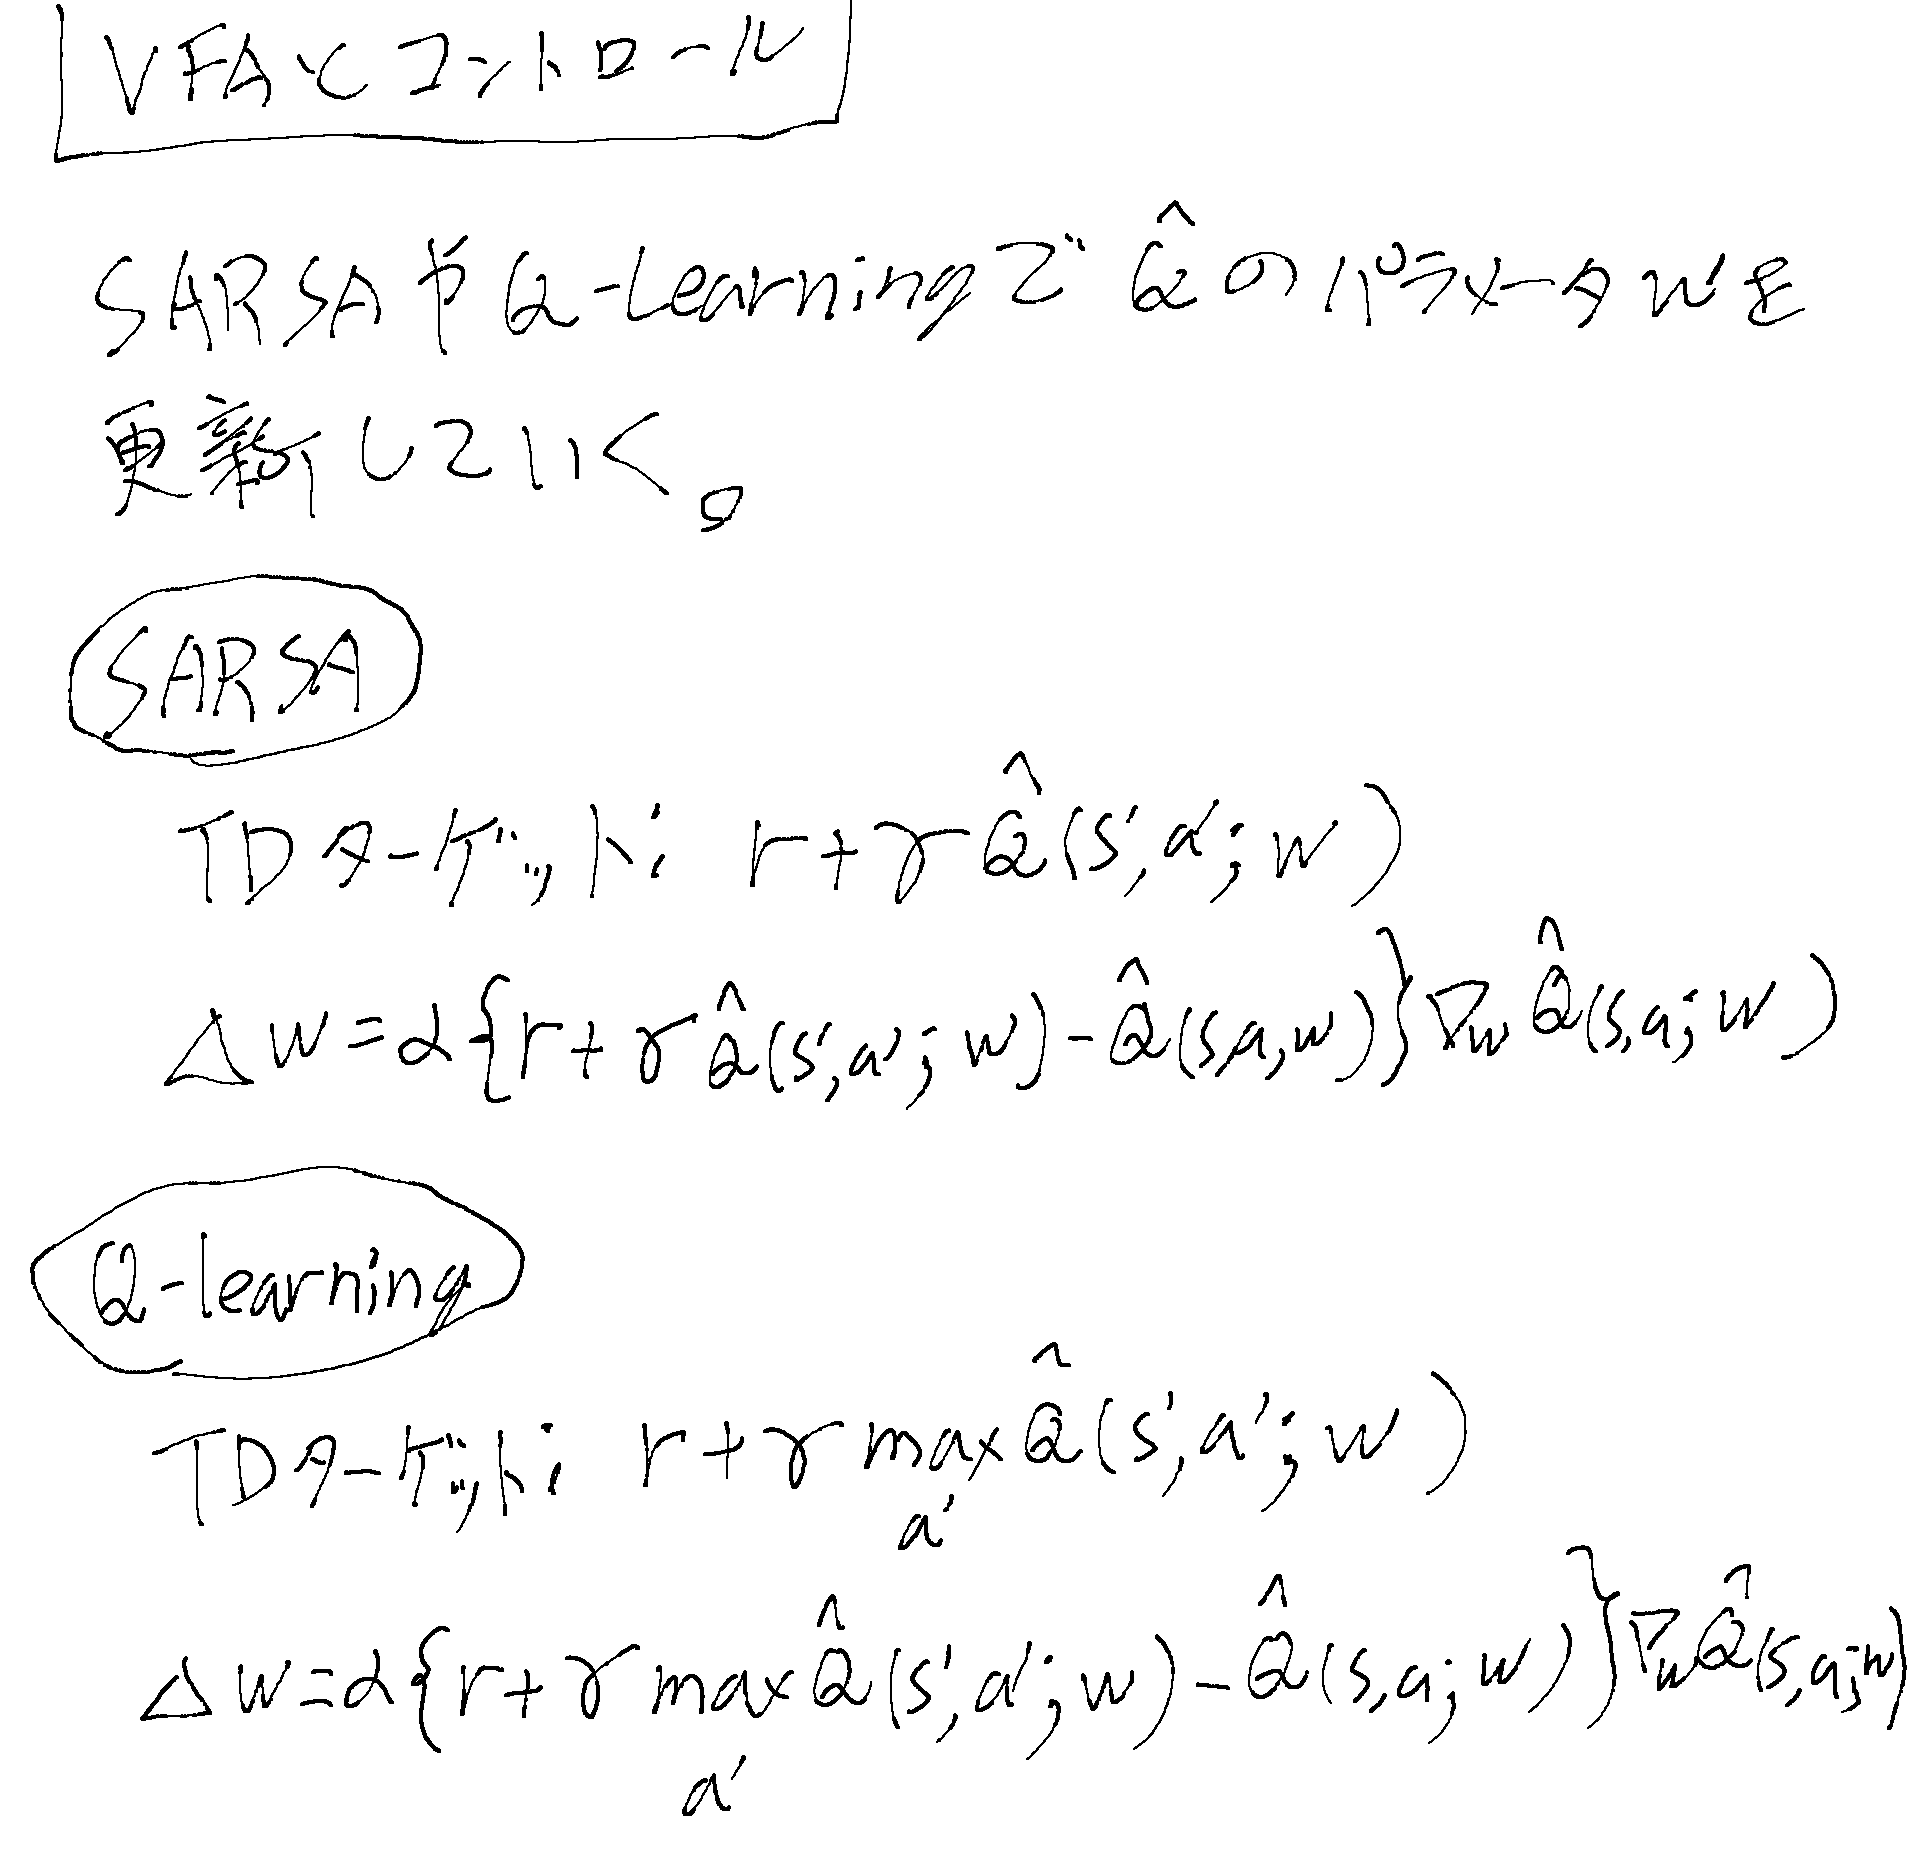
VFAとコントロール
SARSAやQLearningでTDターゲットを作り、通常のMSEの最小化で更新していく。
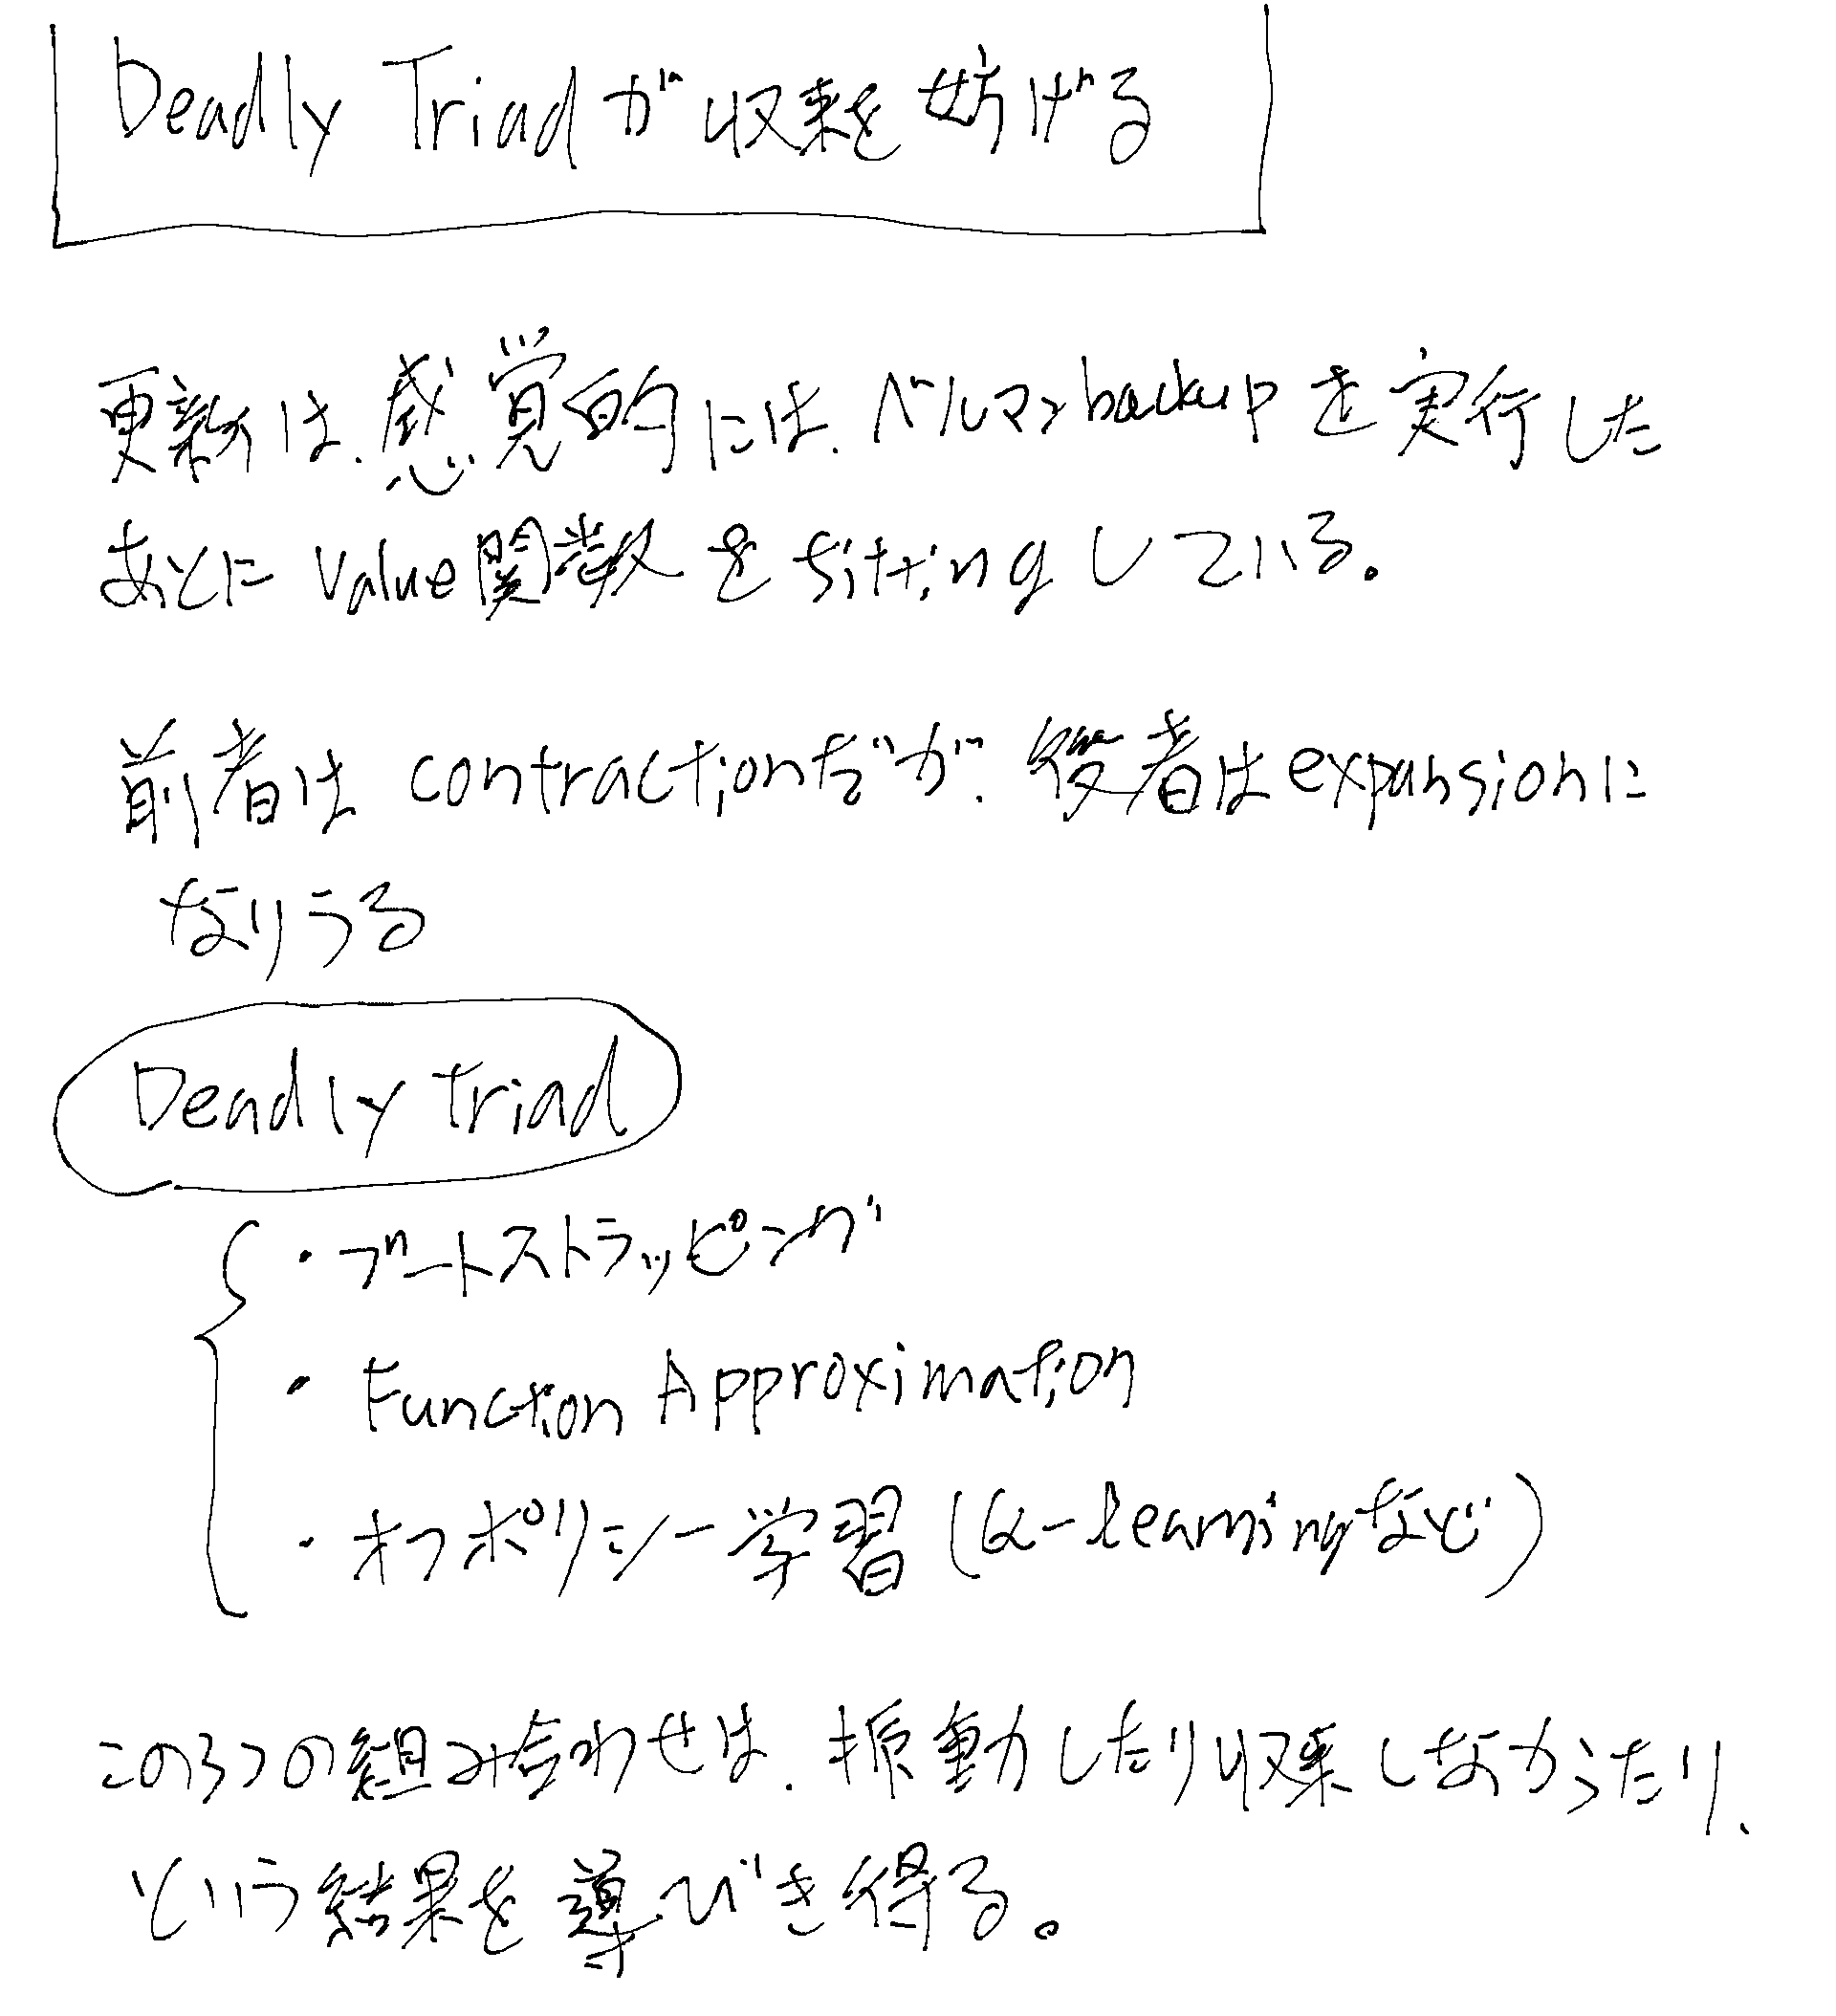
Deadly Triadが収束を妨げる