MarkovDecisionProcess
MarkovDecisionProcess
強化学習で良く扱う過程。マルコフ性については強化学習の用語定義参照。
- Stanford CS234 Reinforcement Learning I Introduction to Reinforcement Learning I 2024 I Lecture 1 - YouTube
- Stanford CS234 Reinforcement Learning I Tabular MDP Planning I 2024 I Lecture 2 - YouTube
MDPの定義
強化学習の用語定義にあるSequential Decision Processのうち、マルコフassumptionの成り立つもの。
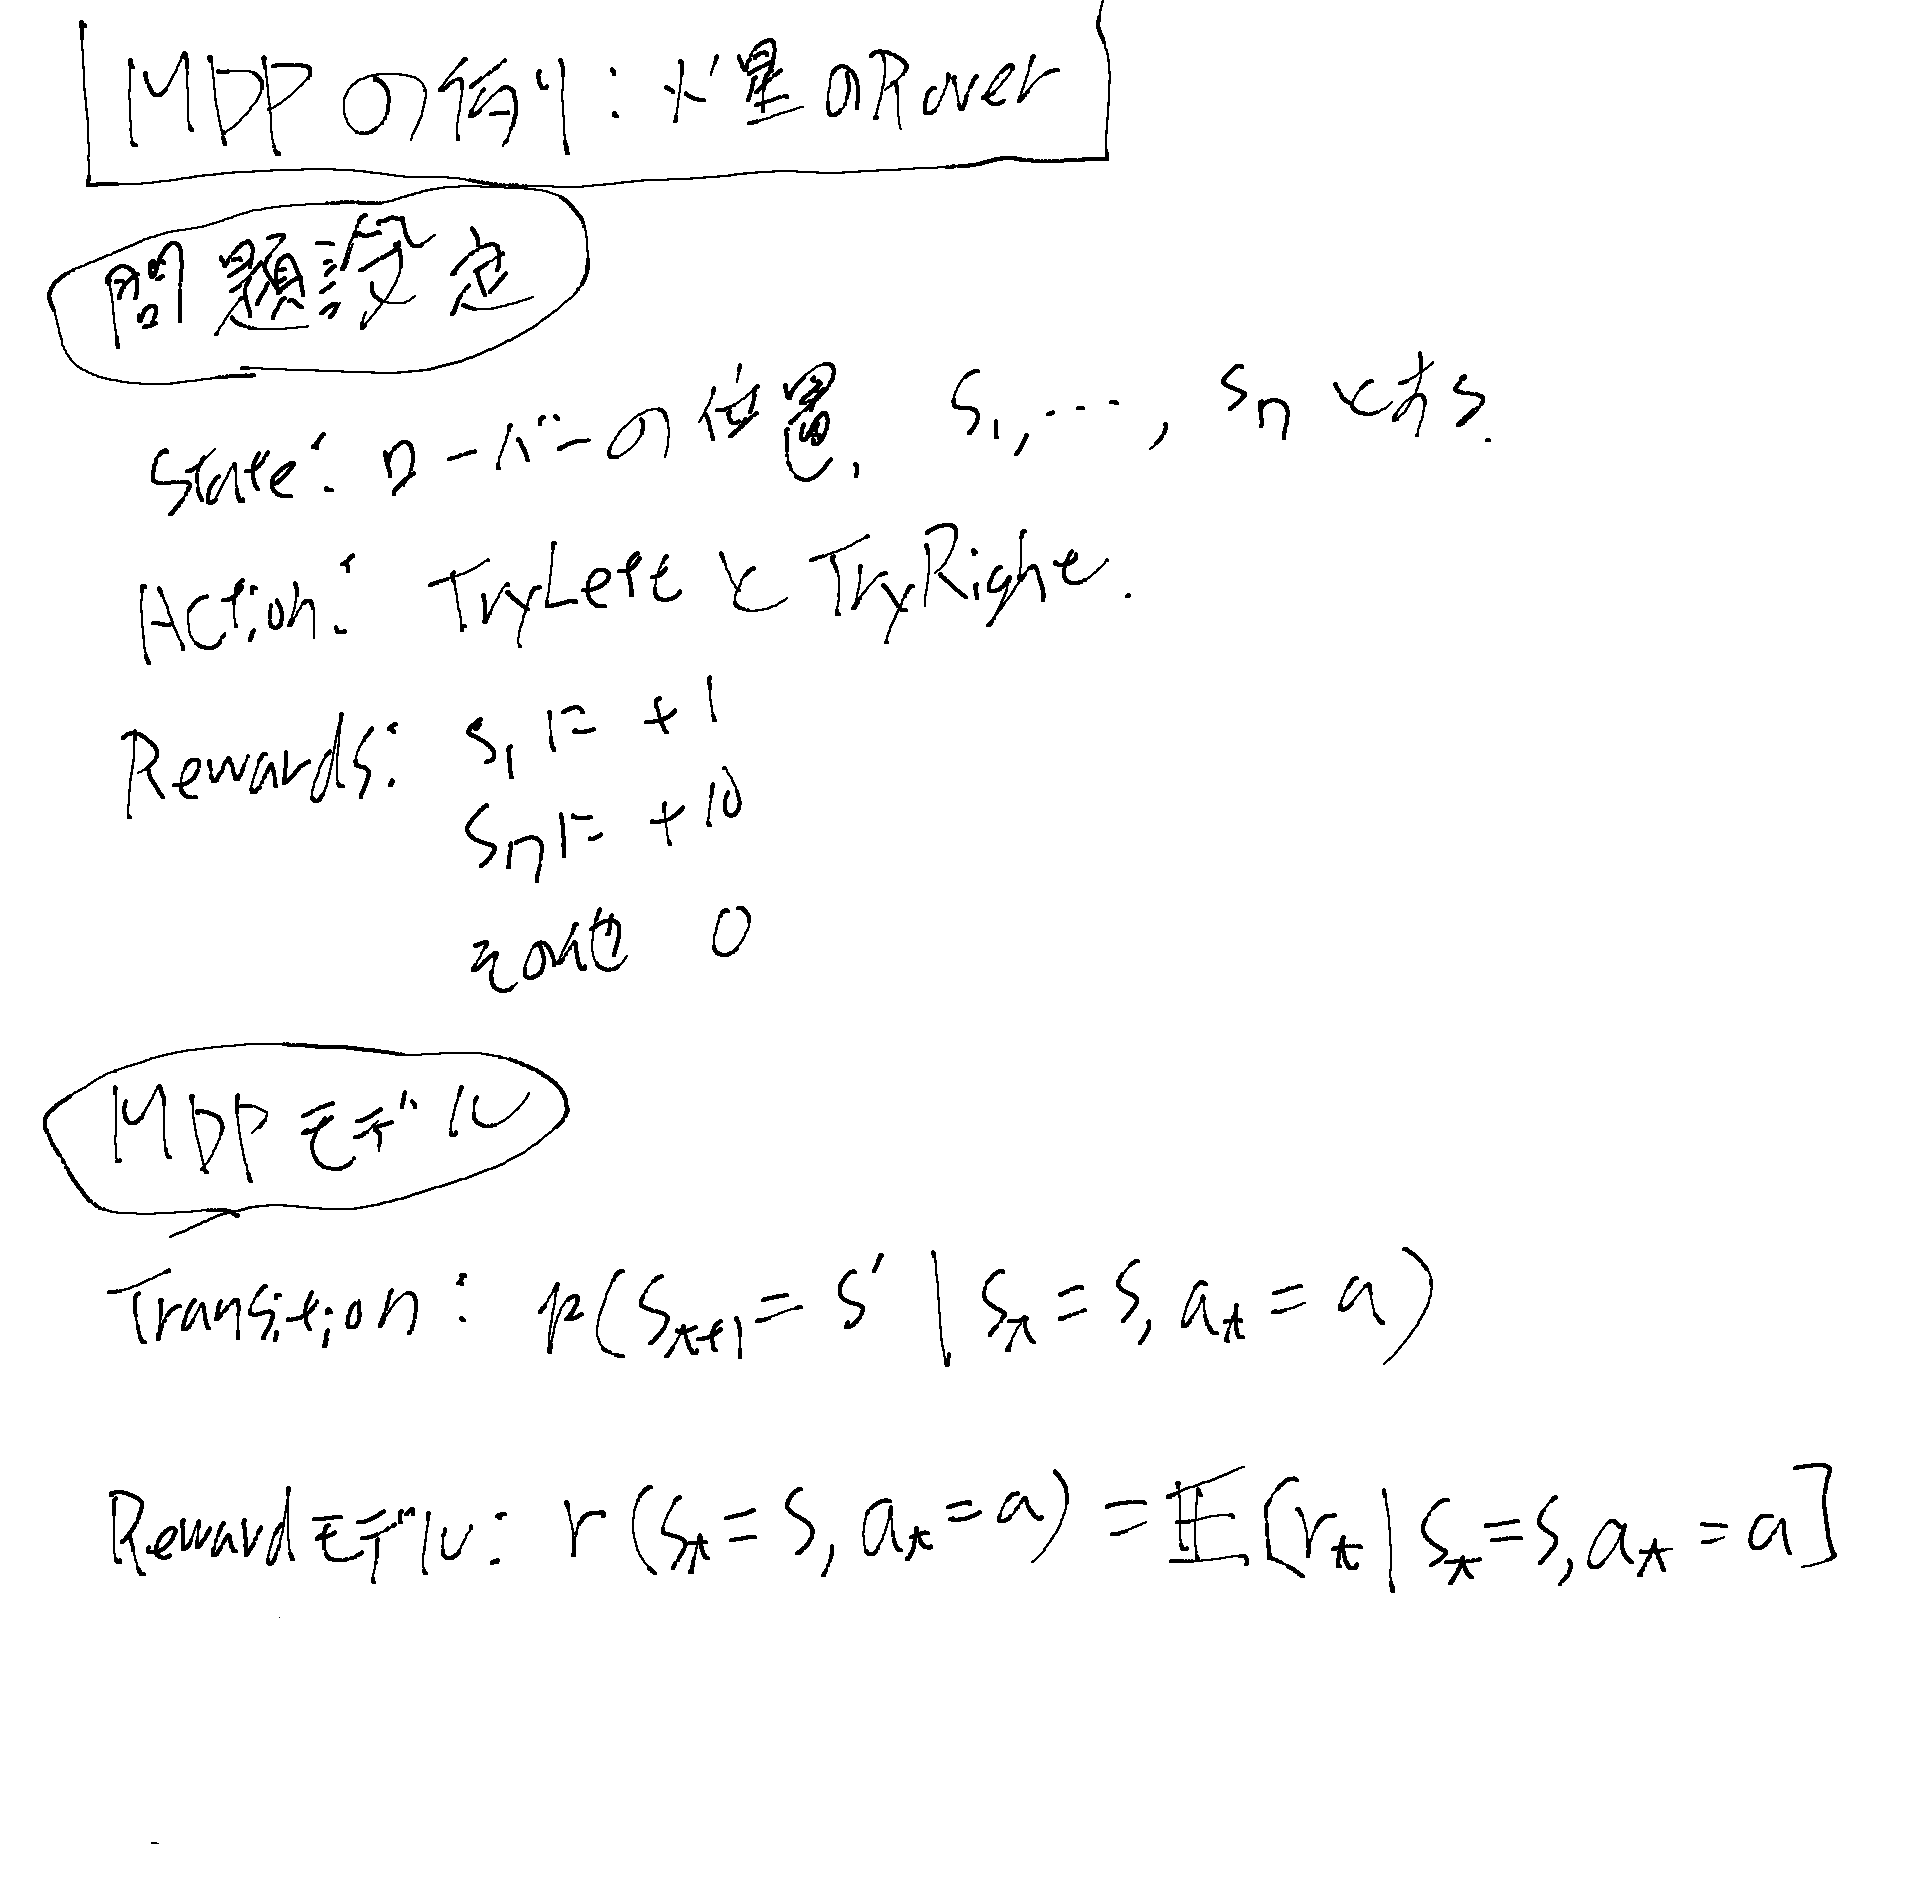
MDPの例
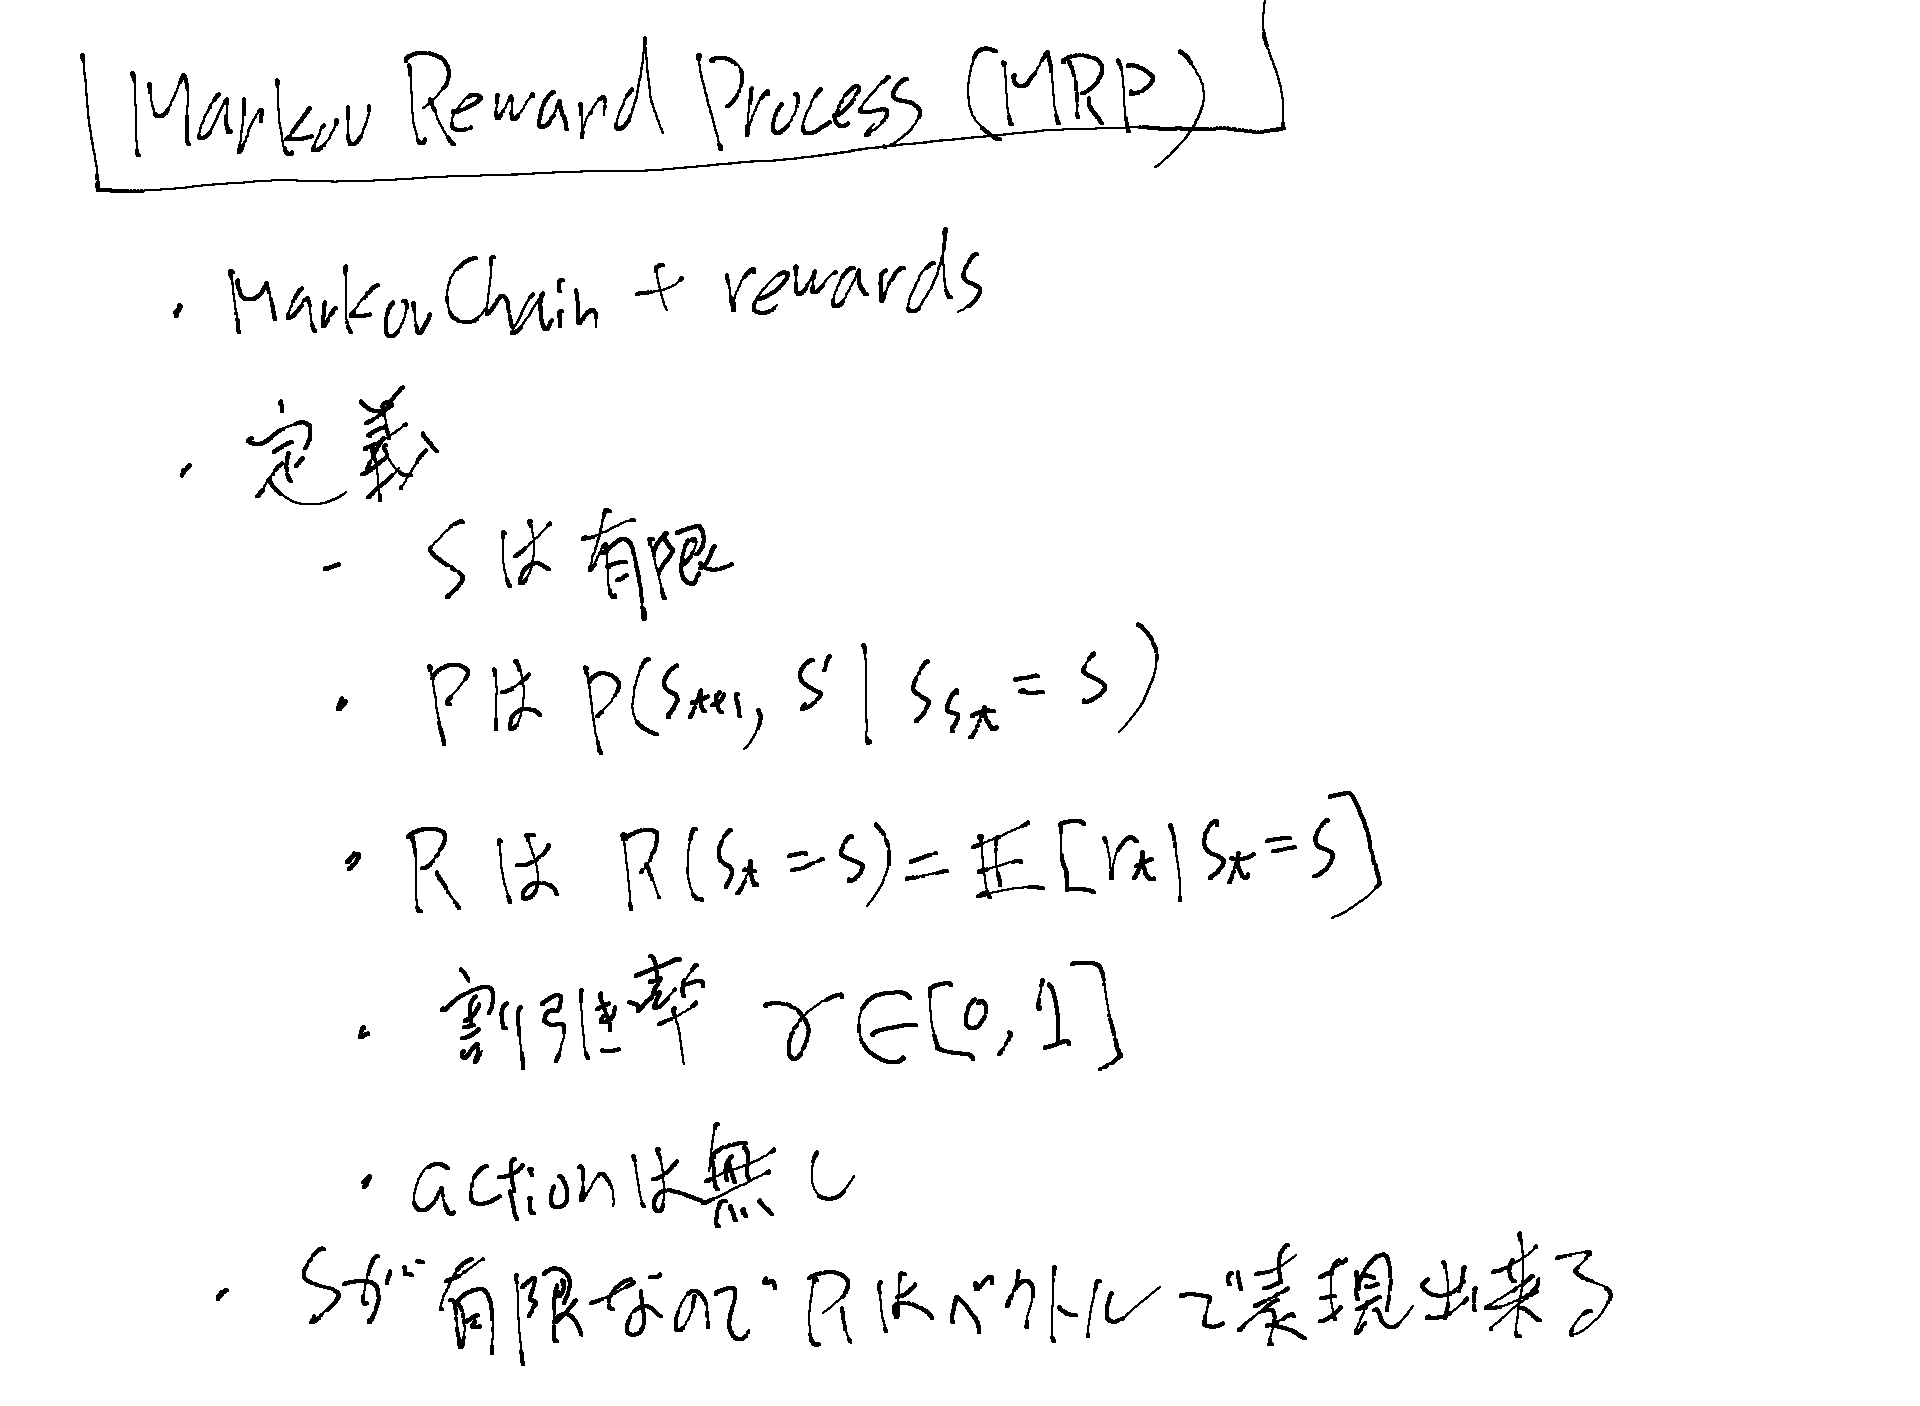
Markov Reward Process (MRP)
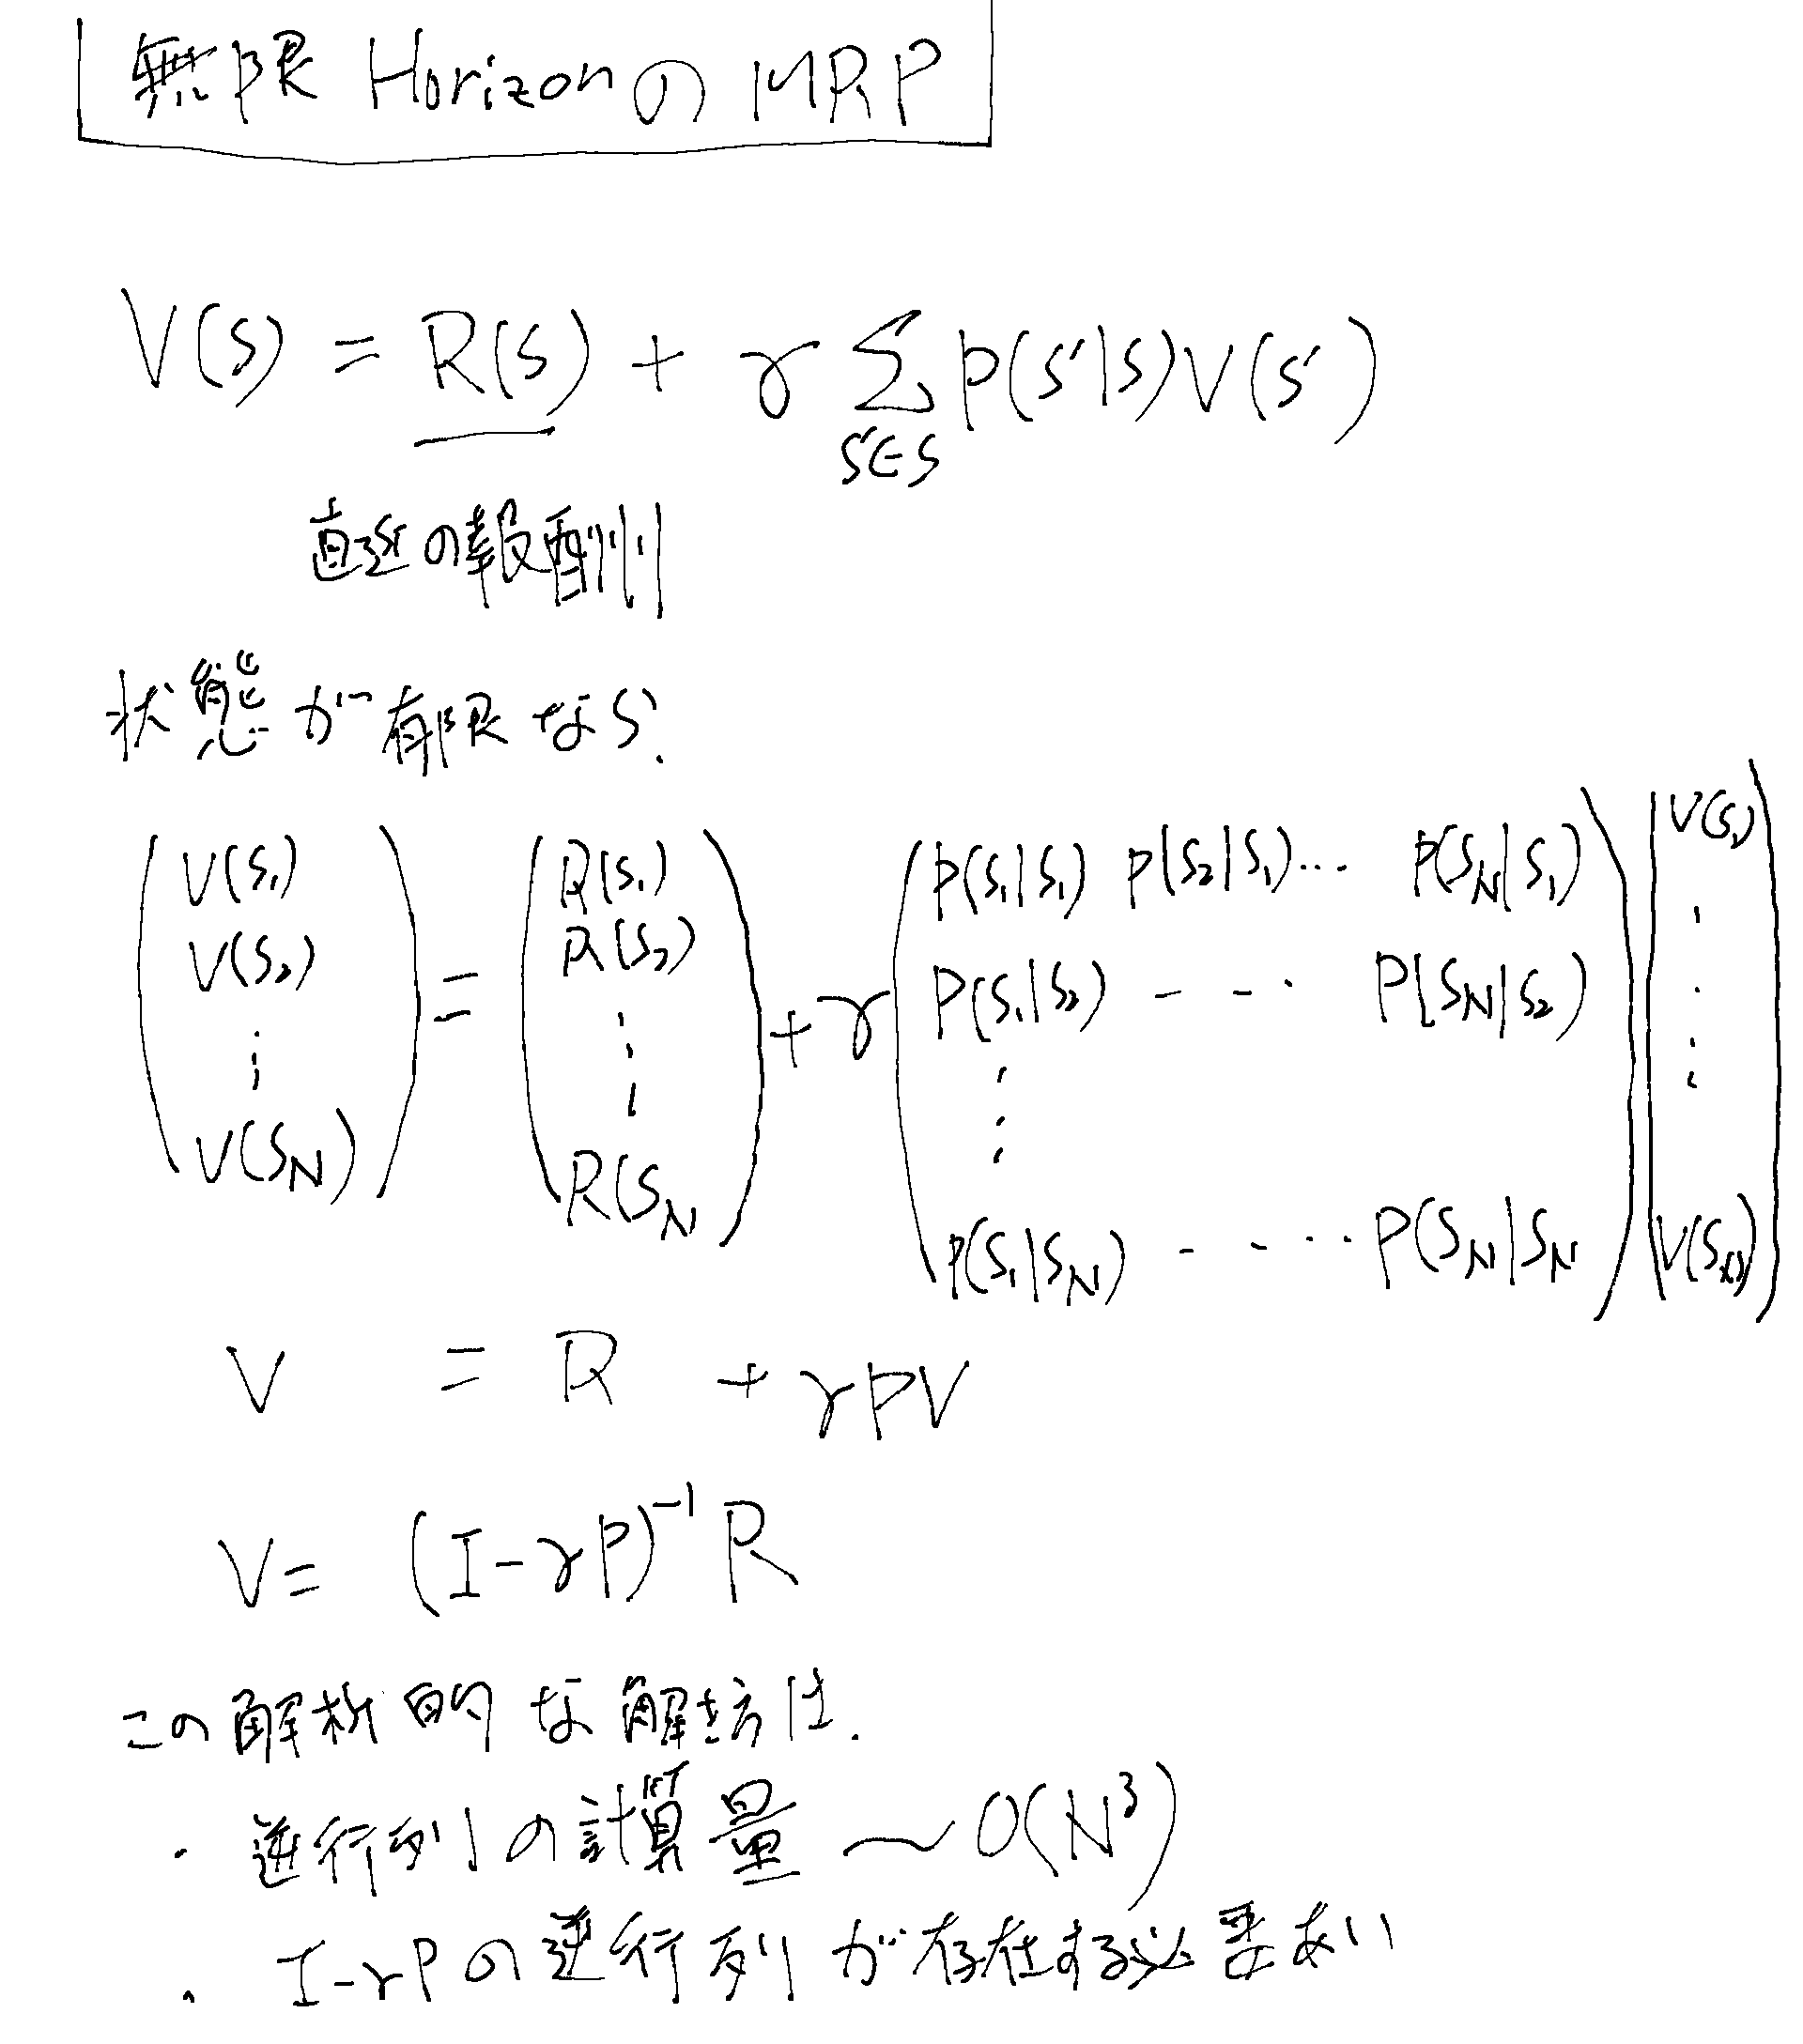
無限地平でのMRP
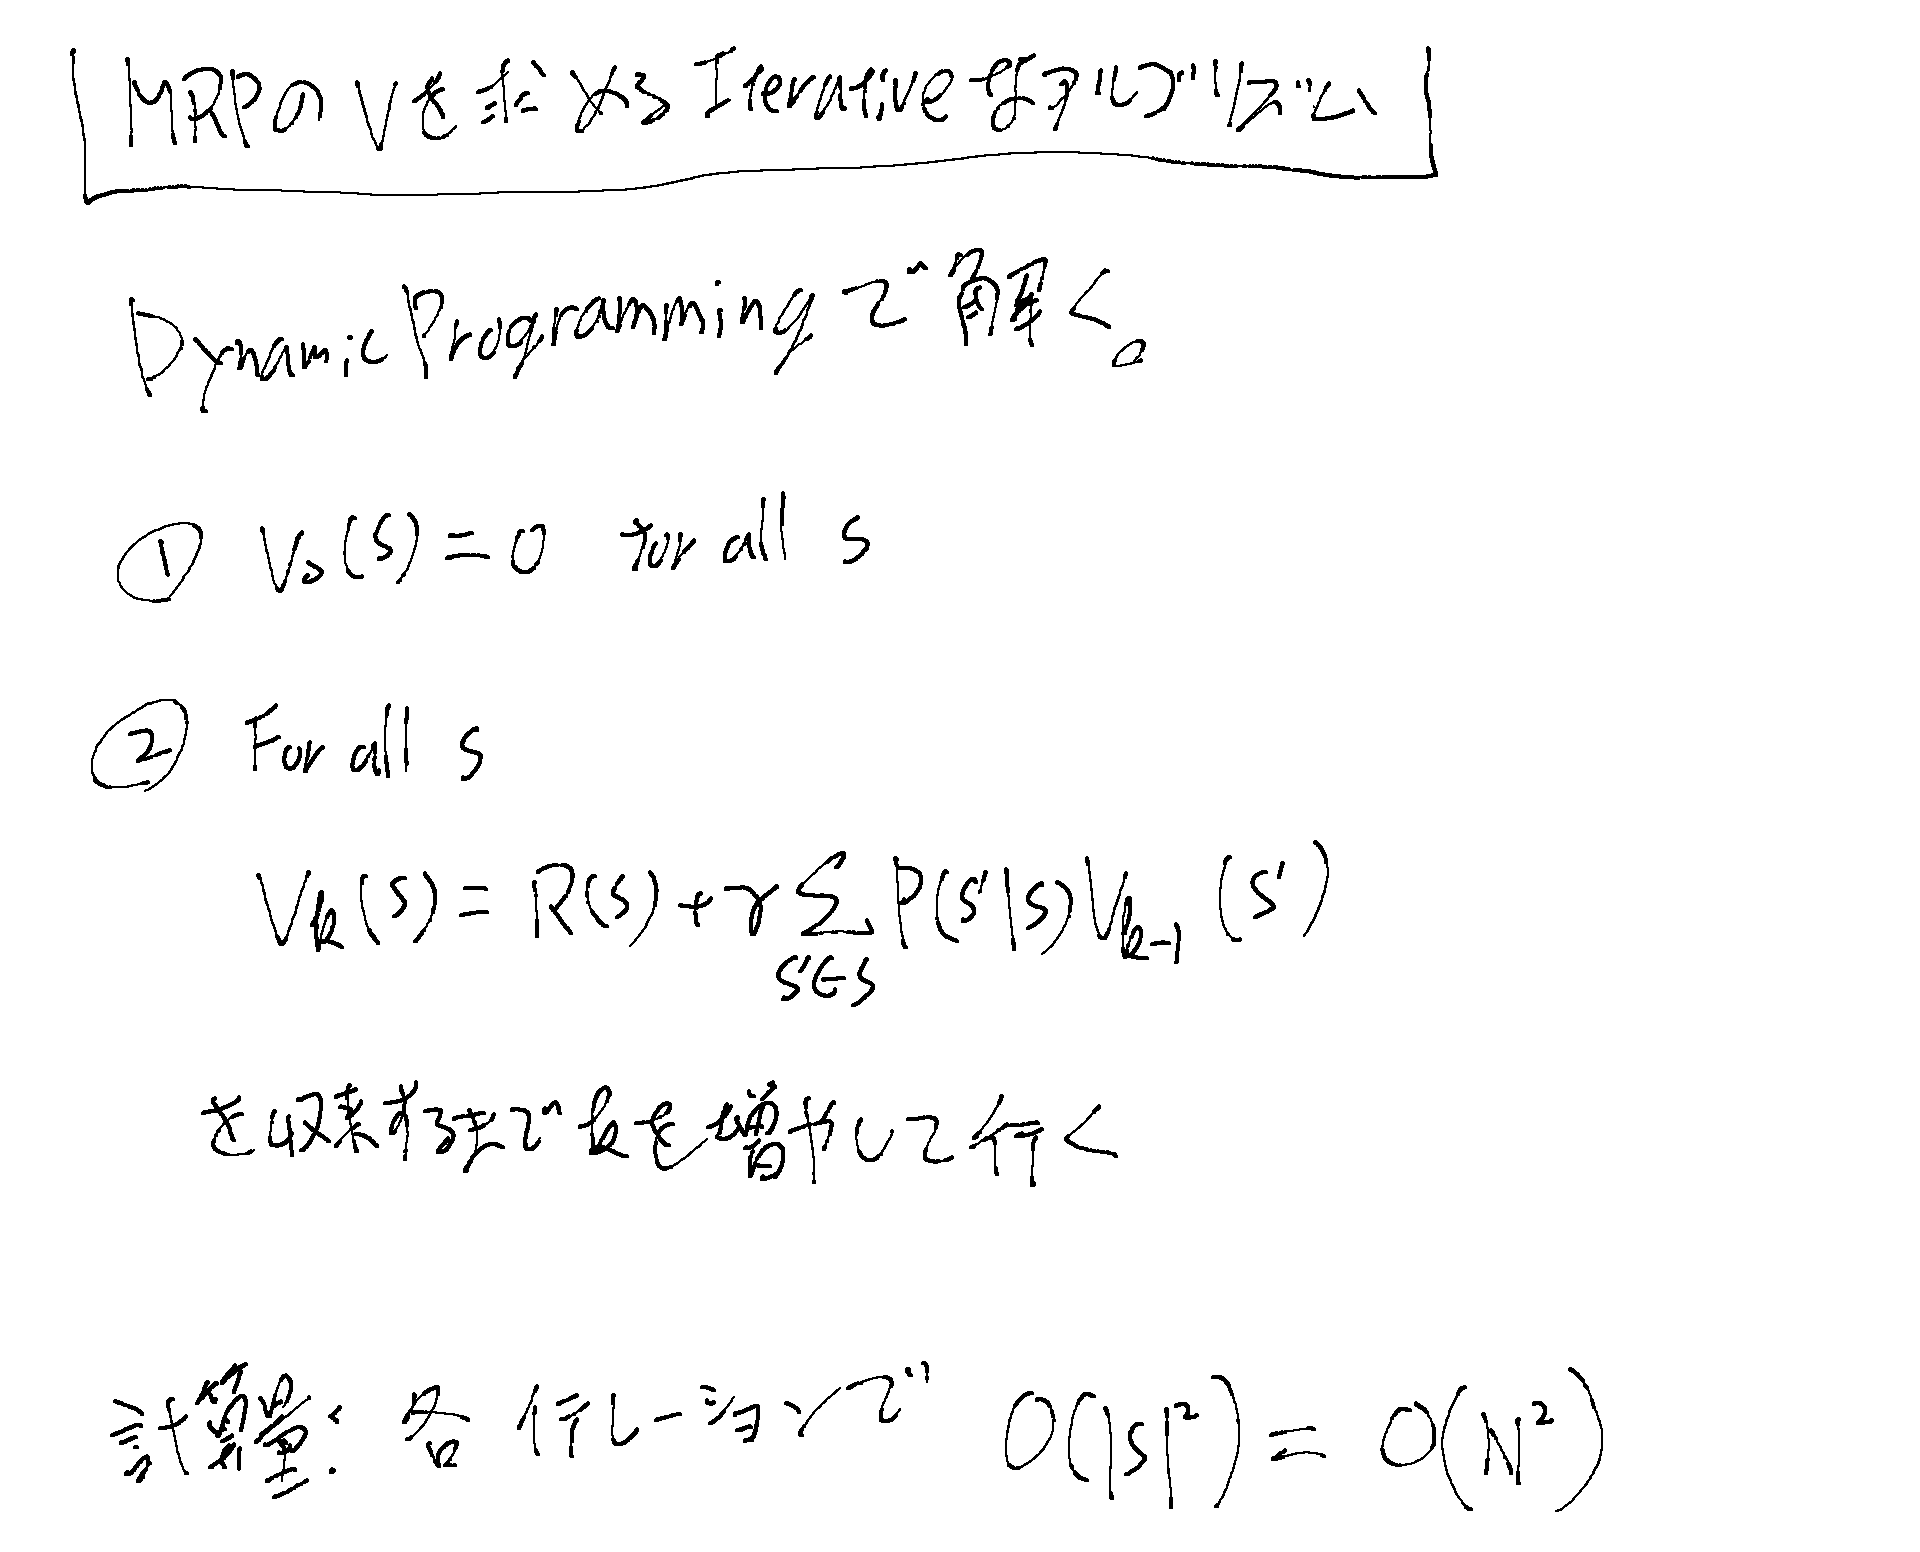
Vを求める(DPによるiterativeな算出)
Value State関数を求める。Value関数。
無限地平のMDP
MRPはMDP+actionなので前のMRPの続きとしてMDPを考える。
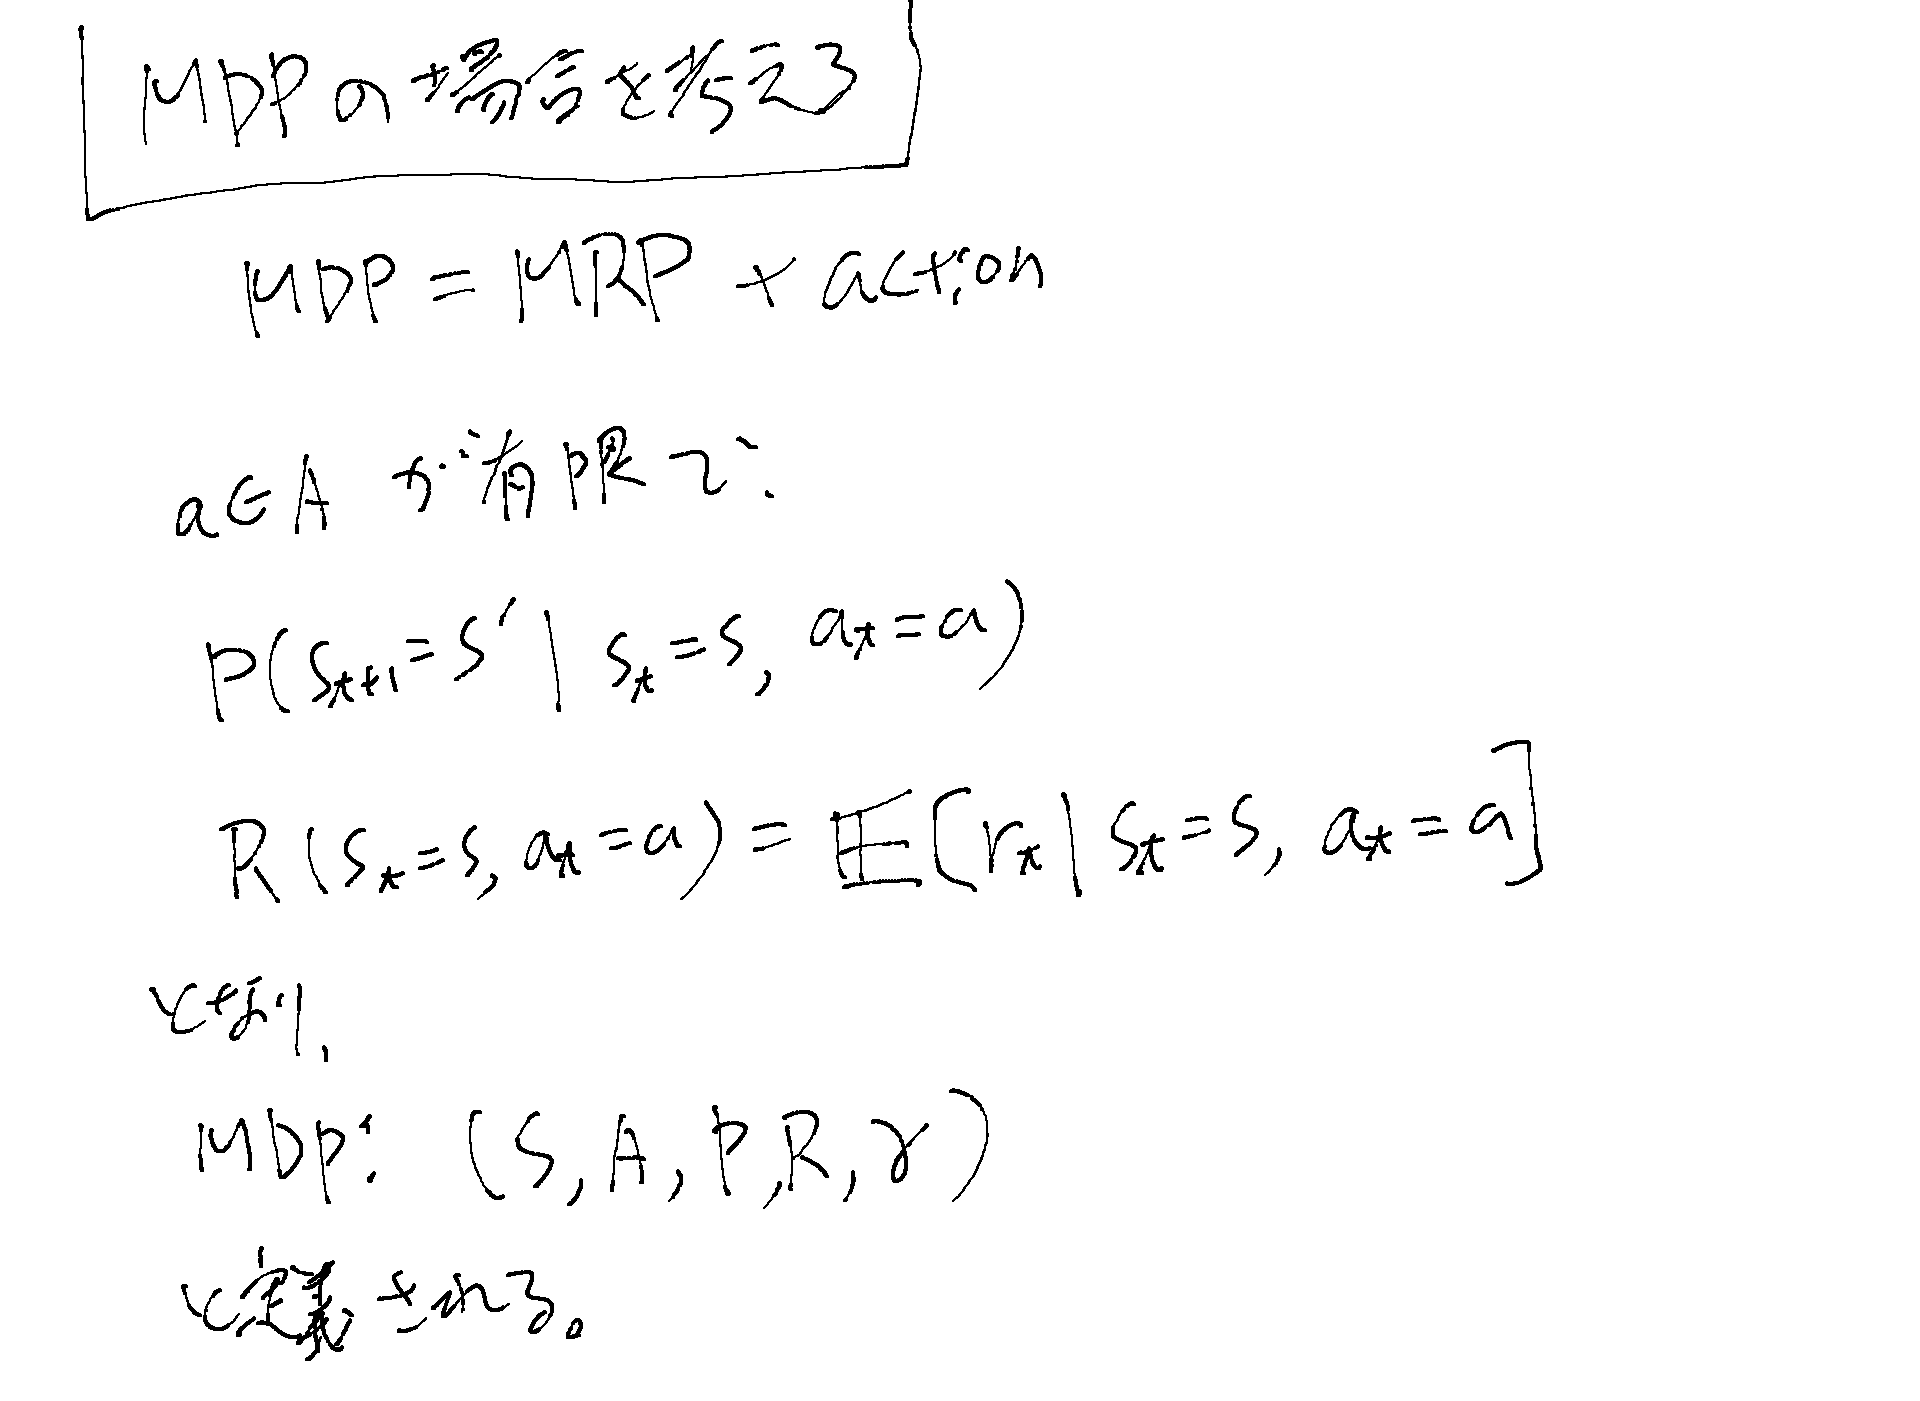
ポリシーを足すとMRPになる
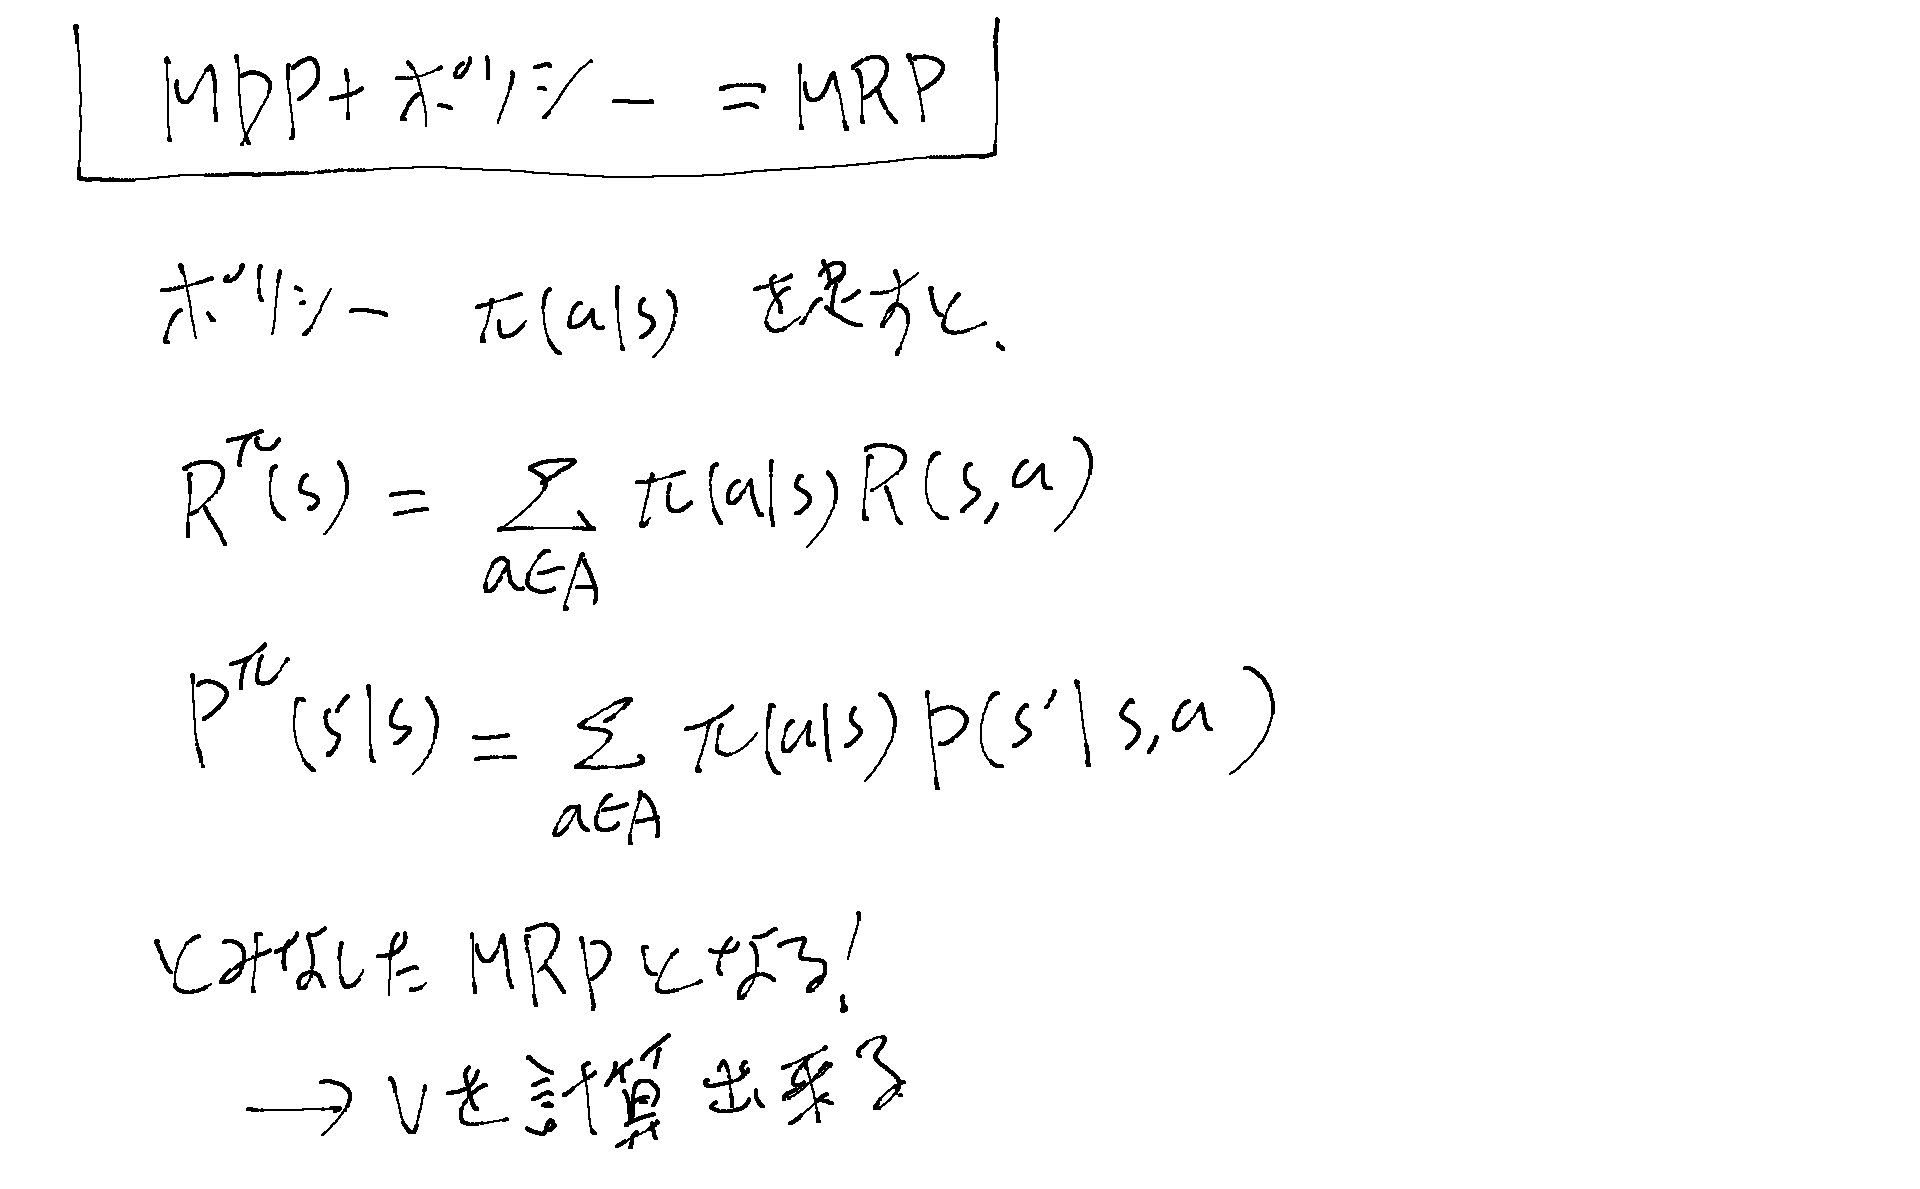
ポリシーを足すとRとPにそれを取り込む事が出来て、そうしたRとPを持つMRPと考える事が出来る。 すろと先に見たVの算出方法が使える。
ポリシーの評価
あるポリシーがどのくらい良いものか、という事を評価するには、Vを求めれば良い。
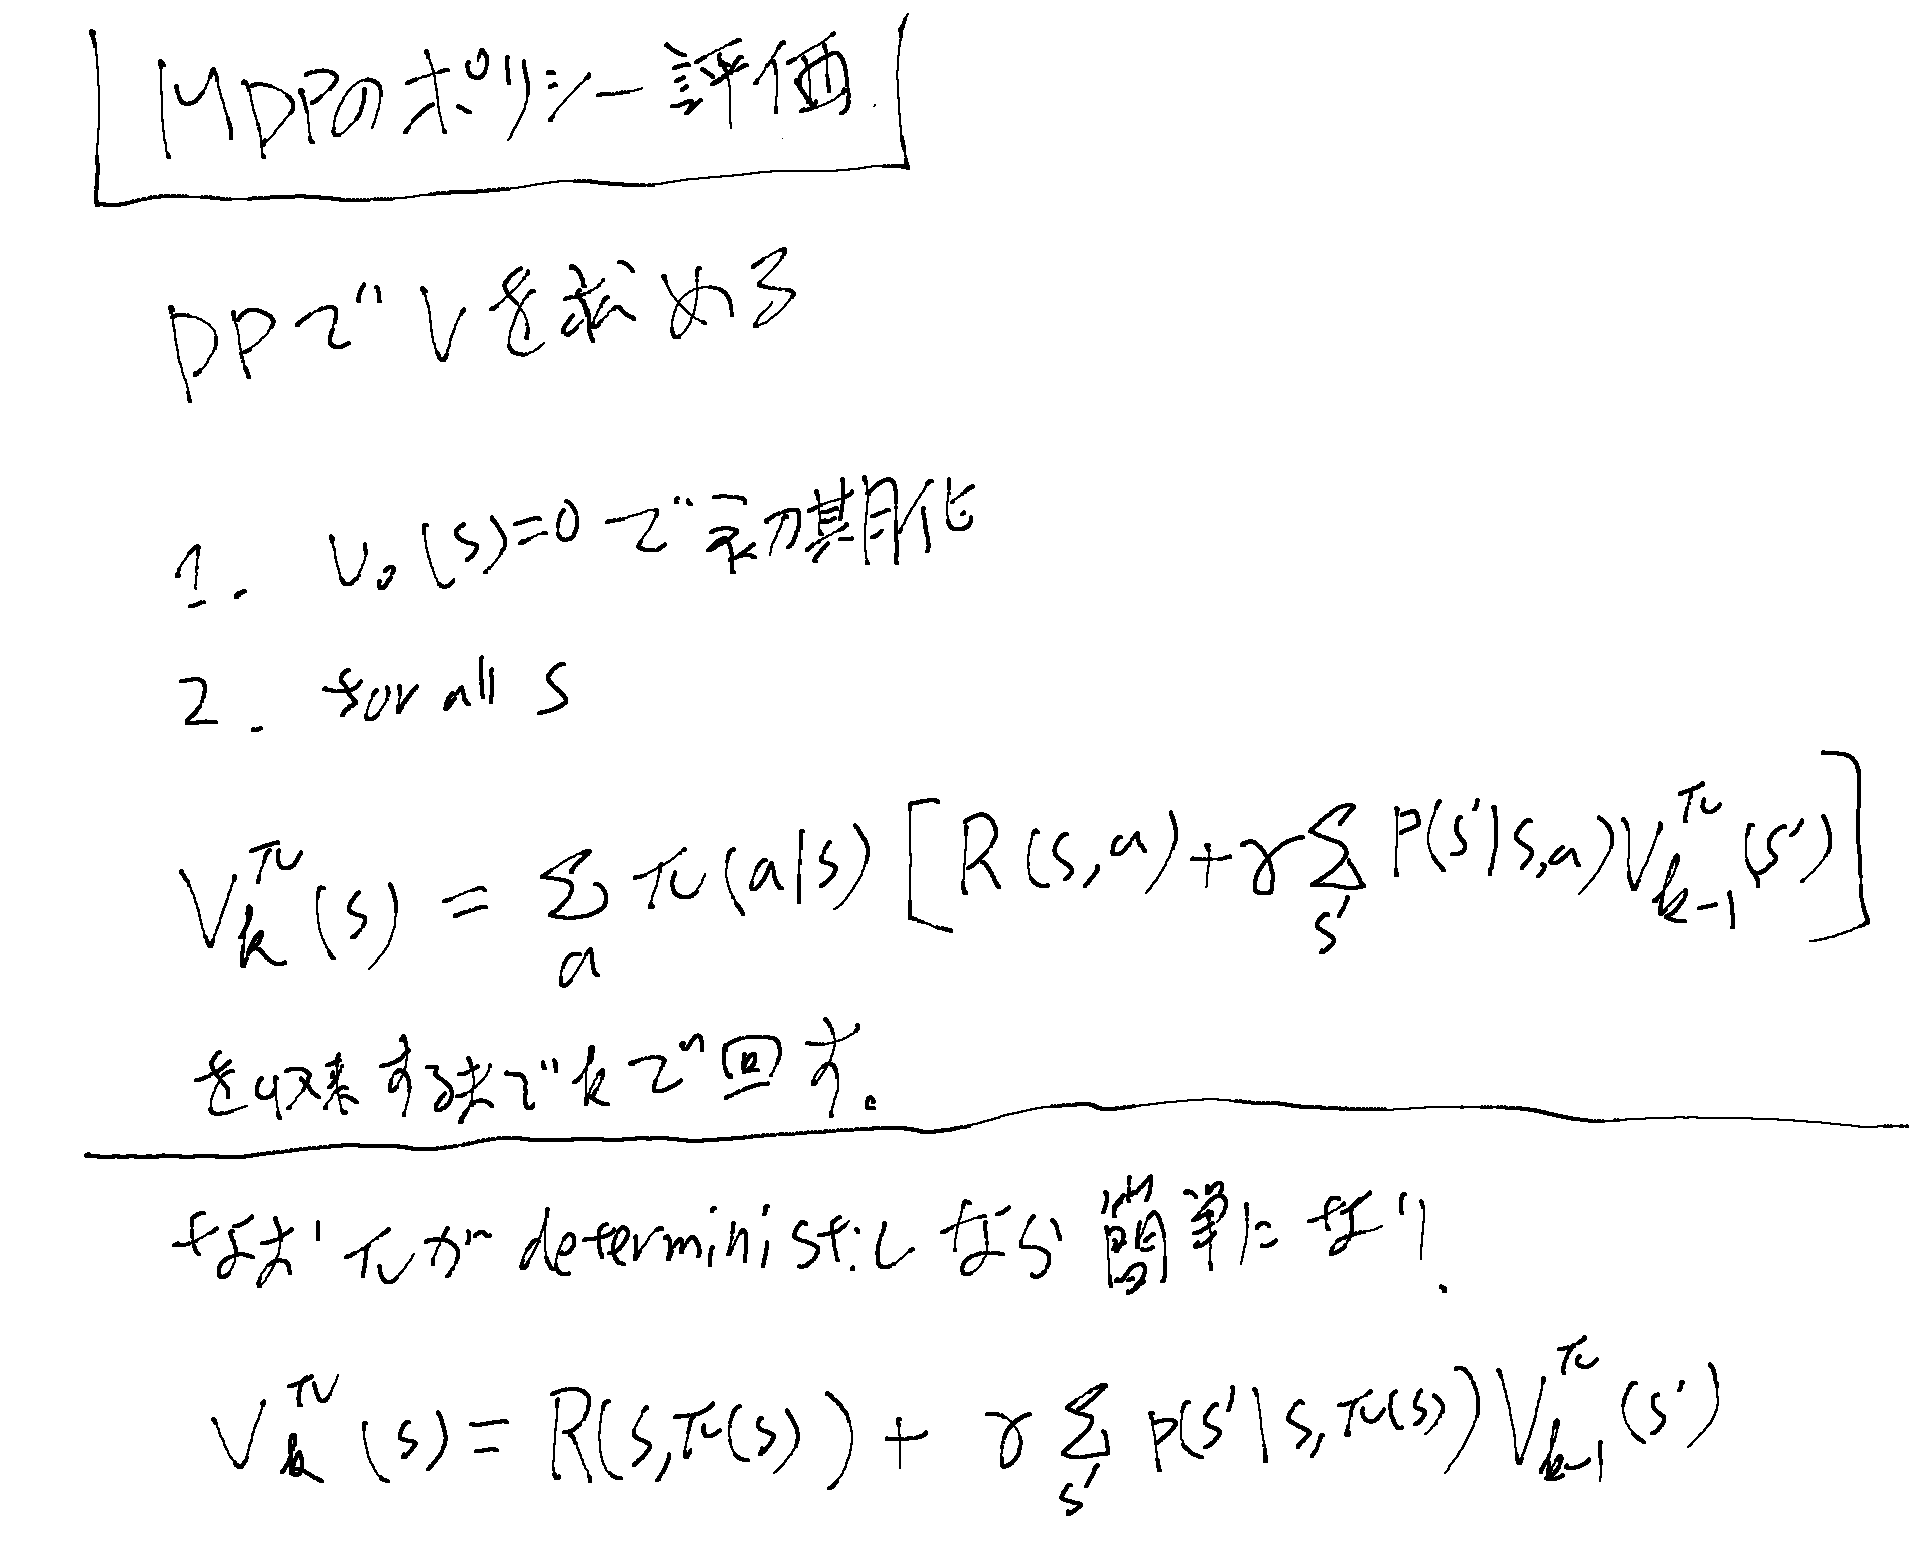
最適なポリシーを求める(MDP Control)ための前準備
あるポリシーがどのくらい良いか、という評価の方法は分かった。 次に最適なポリシーを探索する方法を考える。
実際の計算に入る前に、以下の二つの事実を考慮に入れておくと良い(後で証明する)
無限地平のMDPでは、
- 最適なVがユニークに存在する
- 最適なポリシーはdeterministicになる。
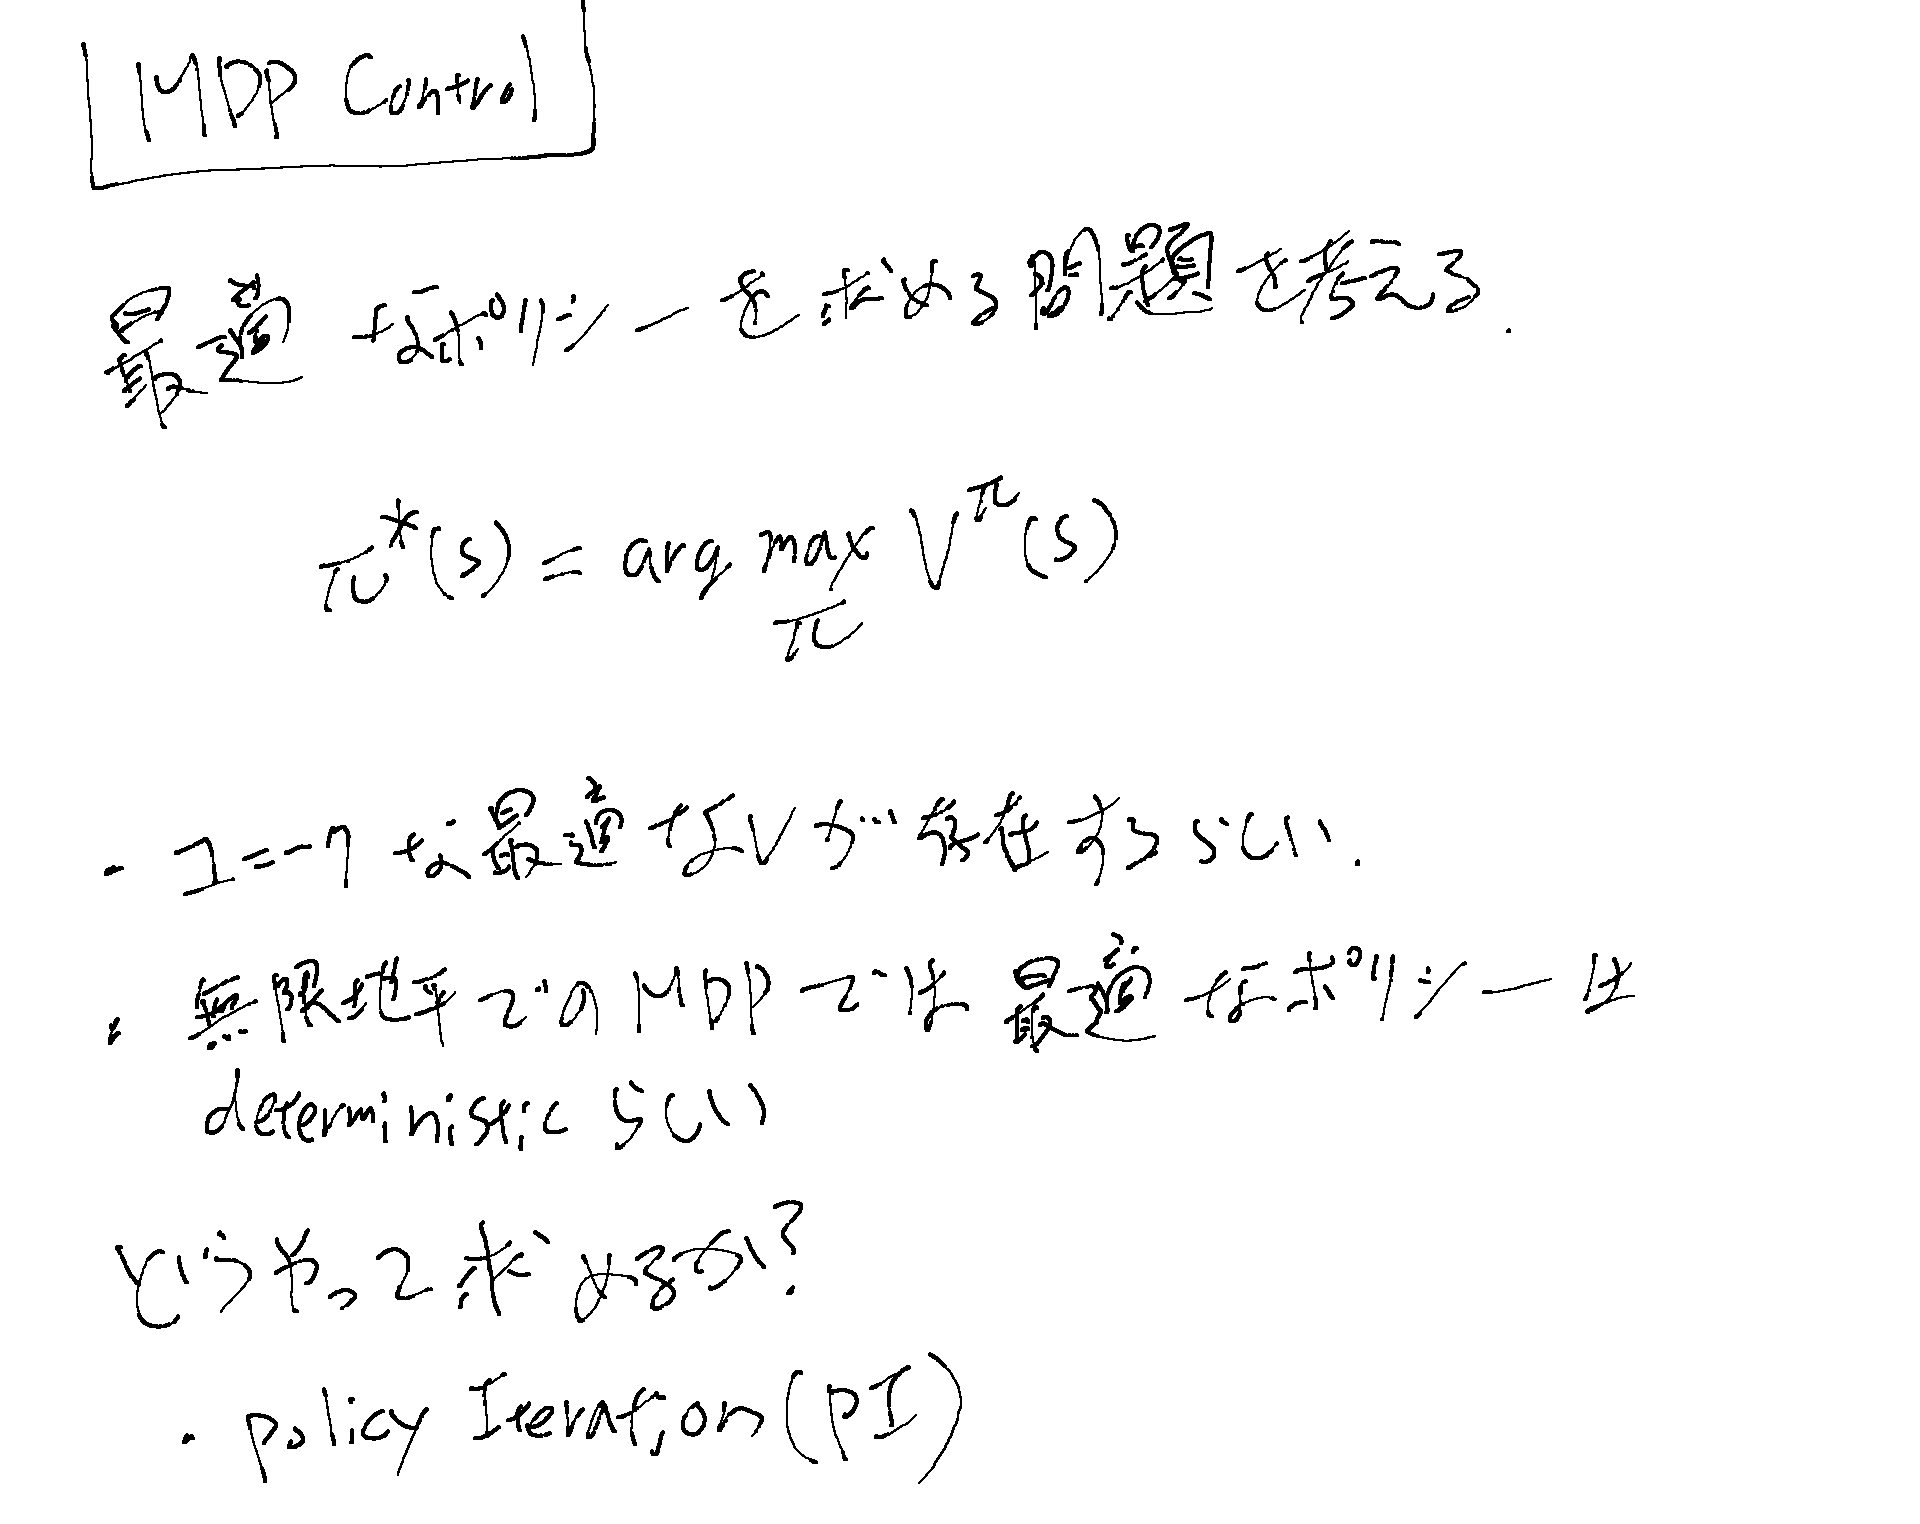
Policy Iteration(PI)
最適なポリシーをPIで求める。
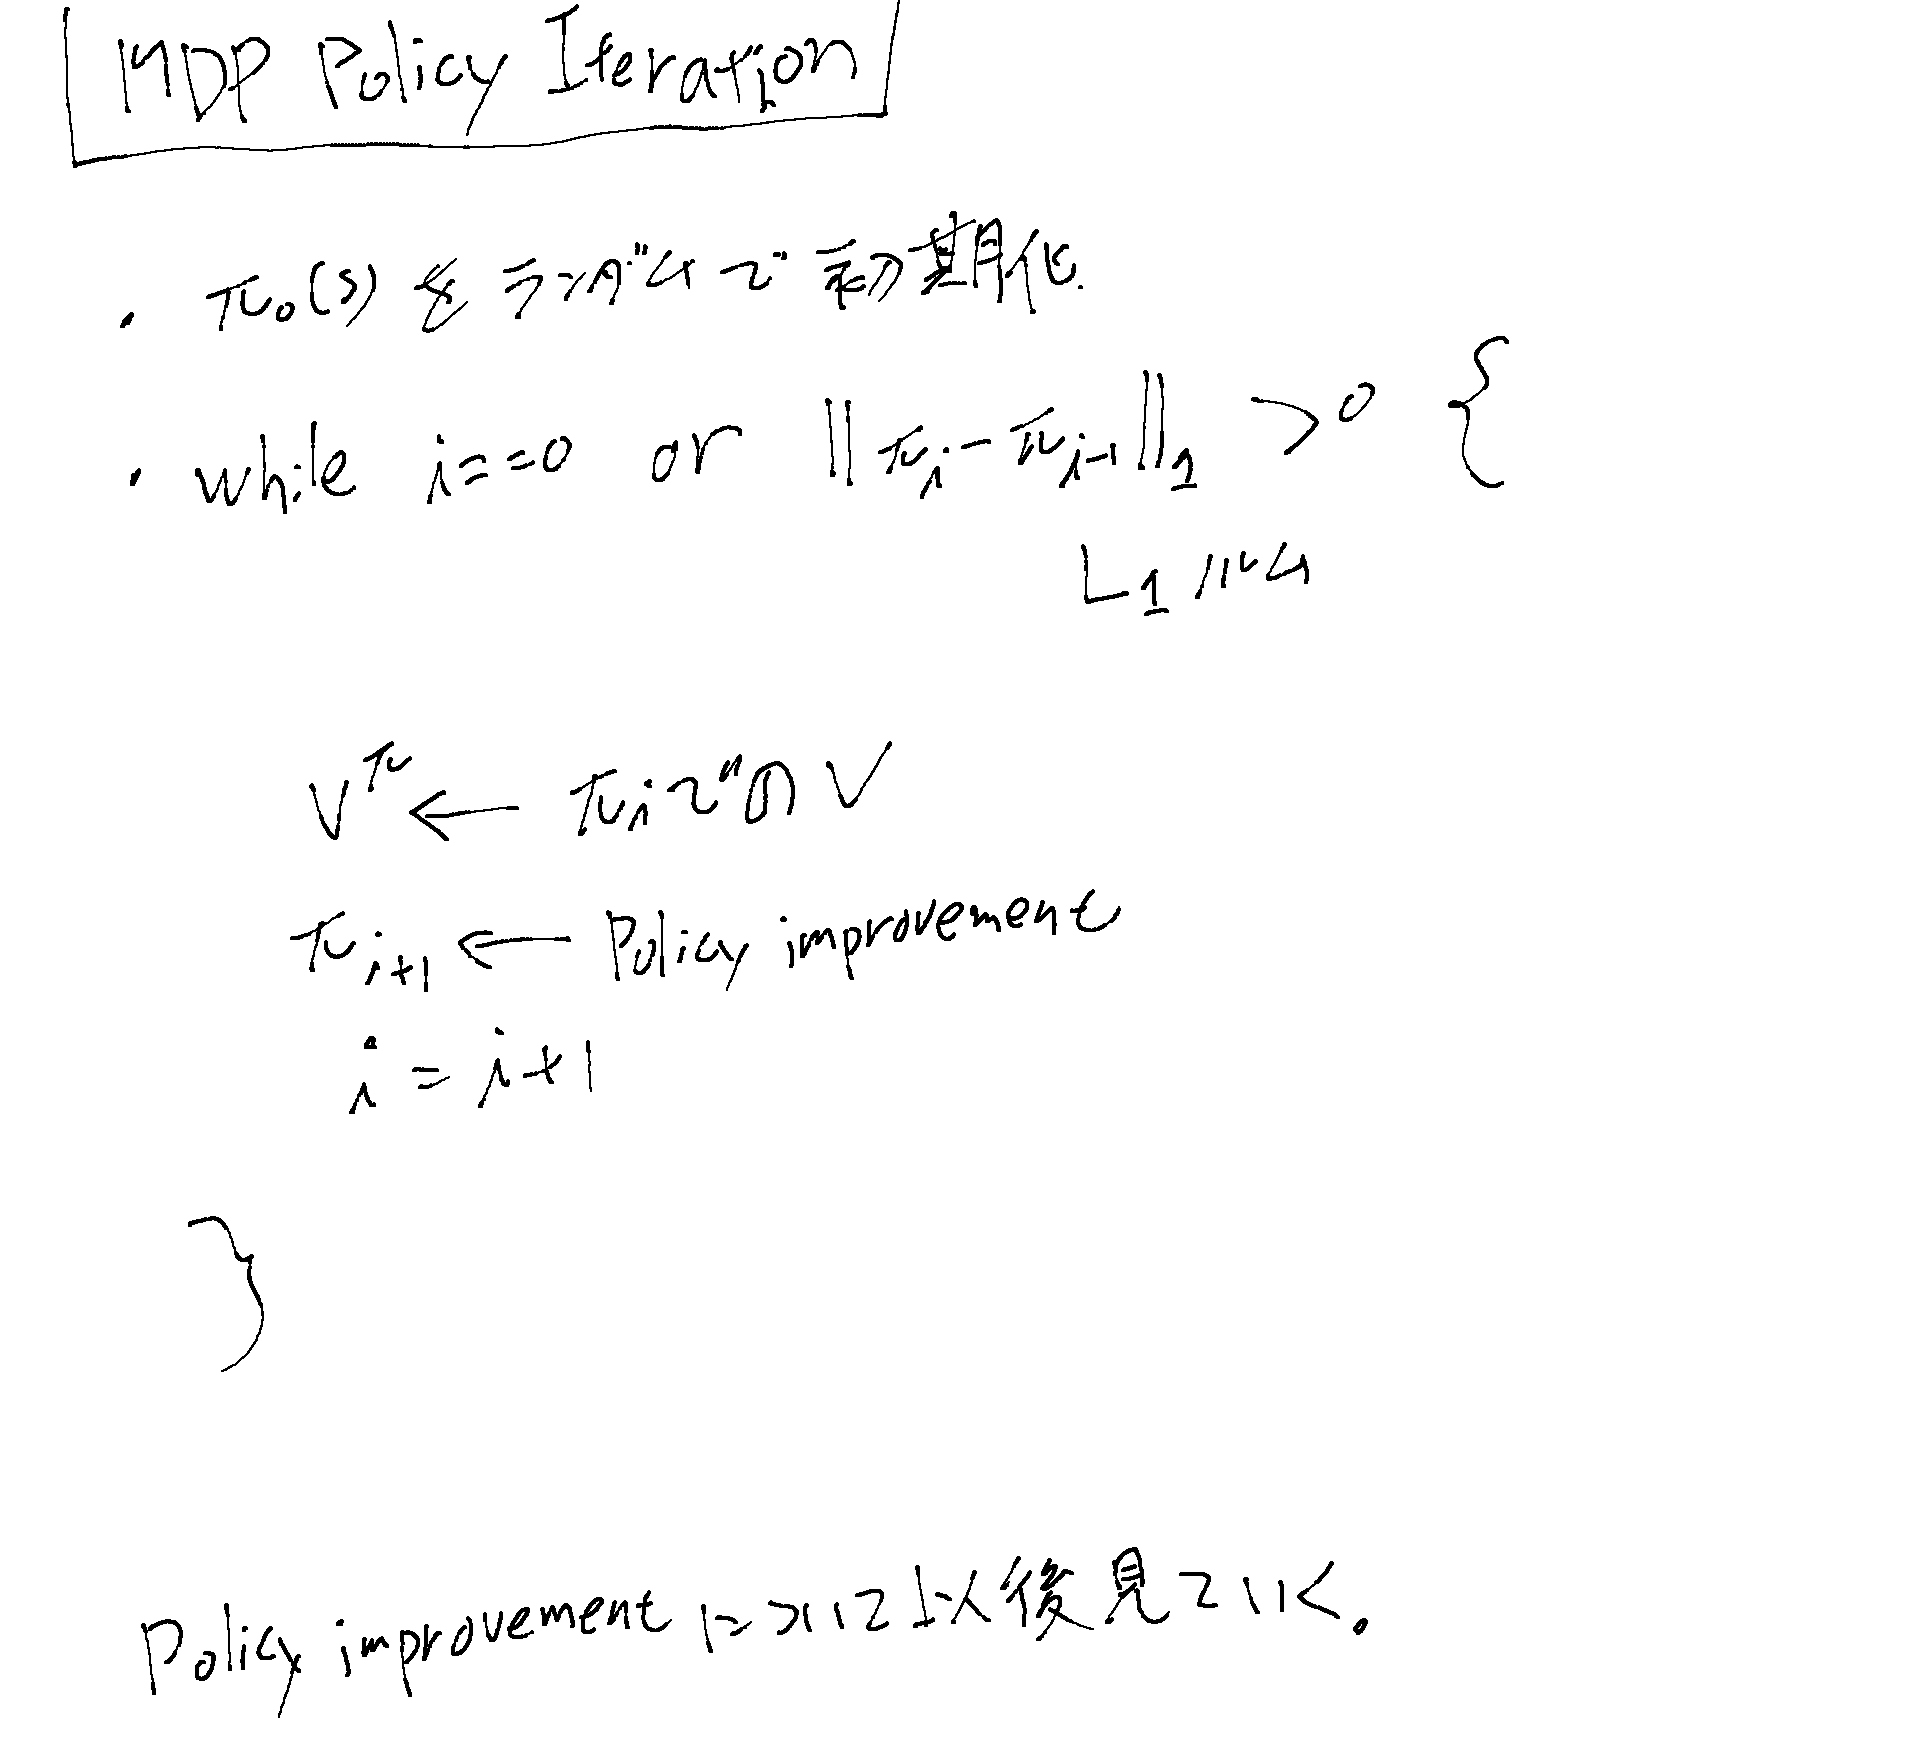
このPolicy improvementについて以下に見ていく。
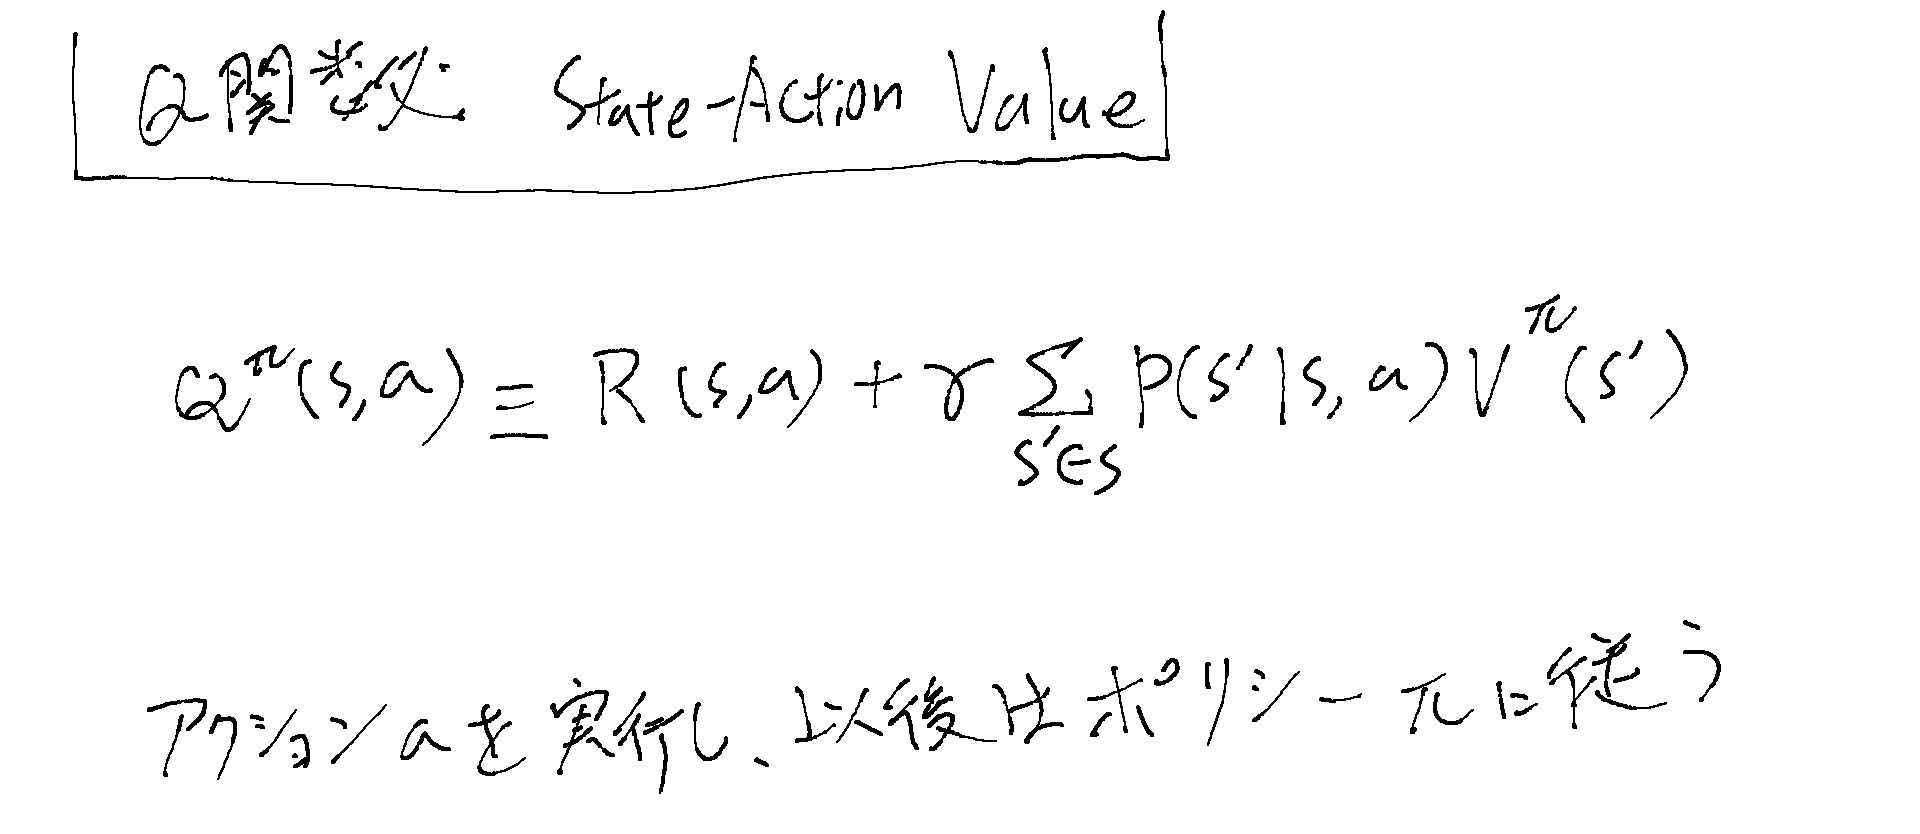
Q関数
Policy Improvementの手順
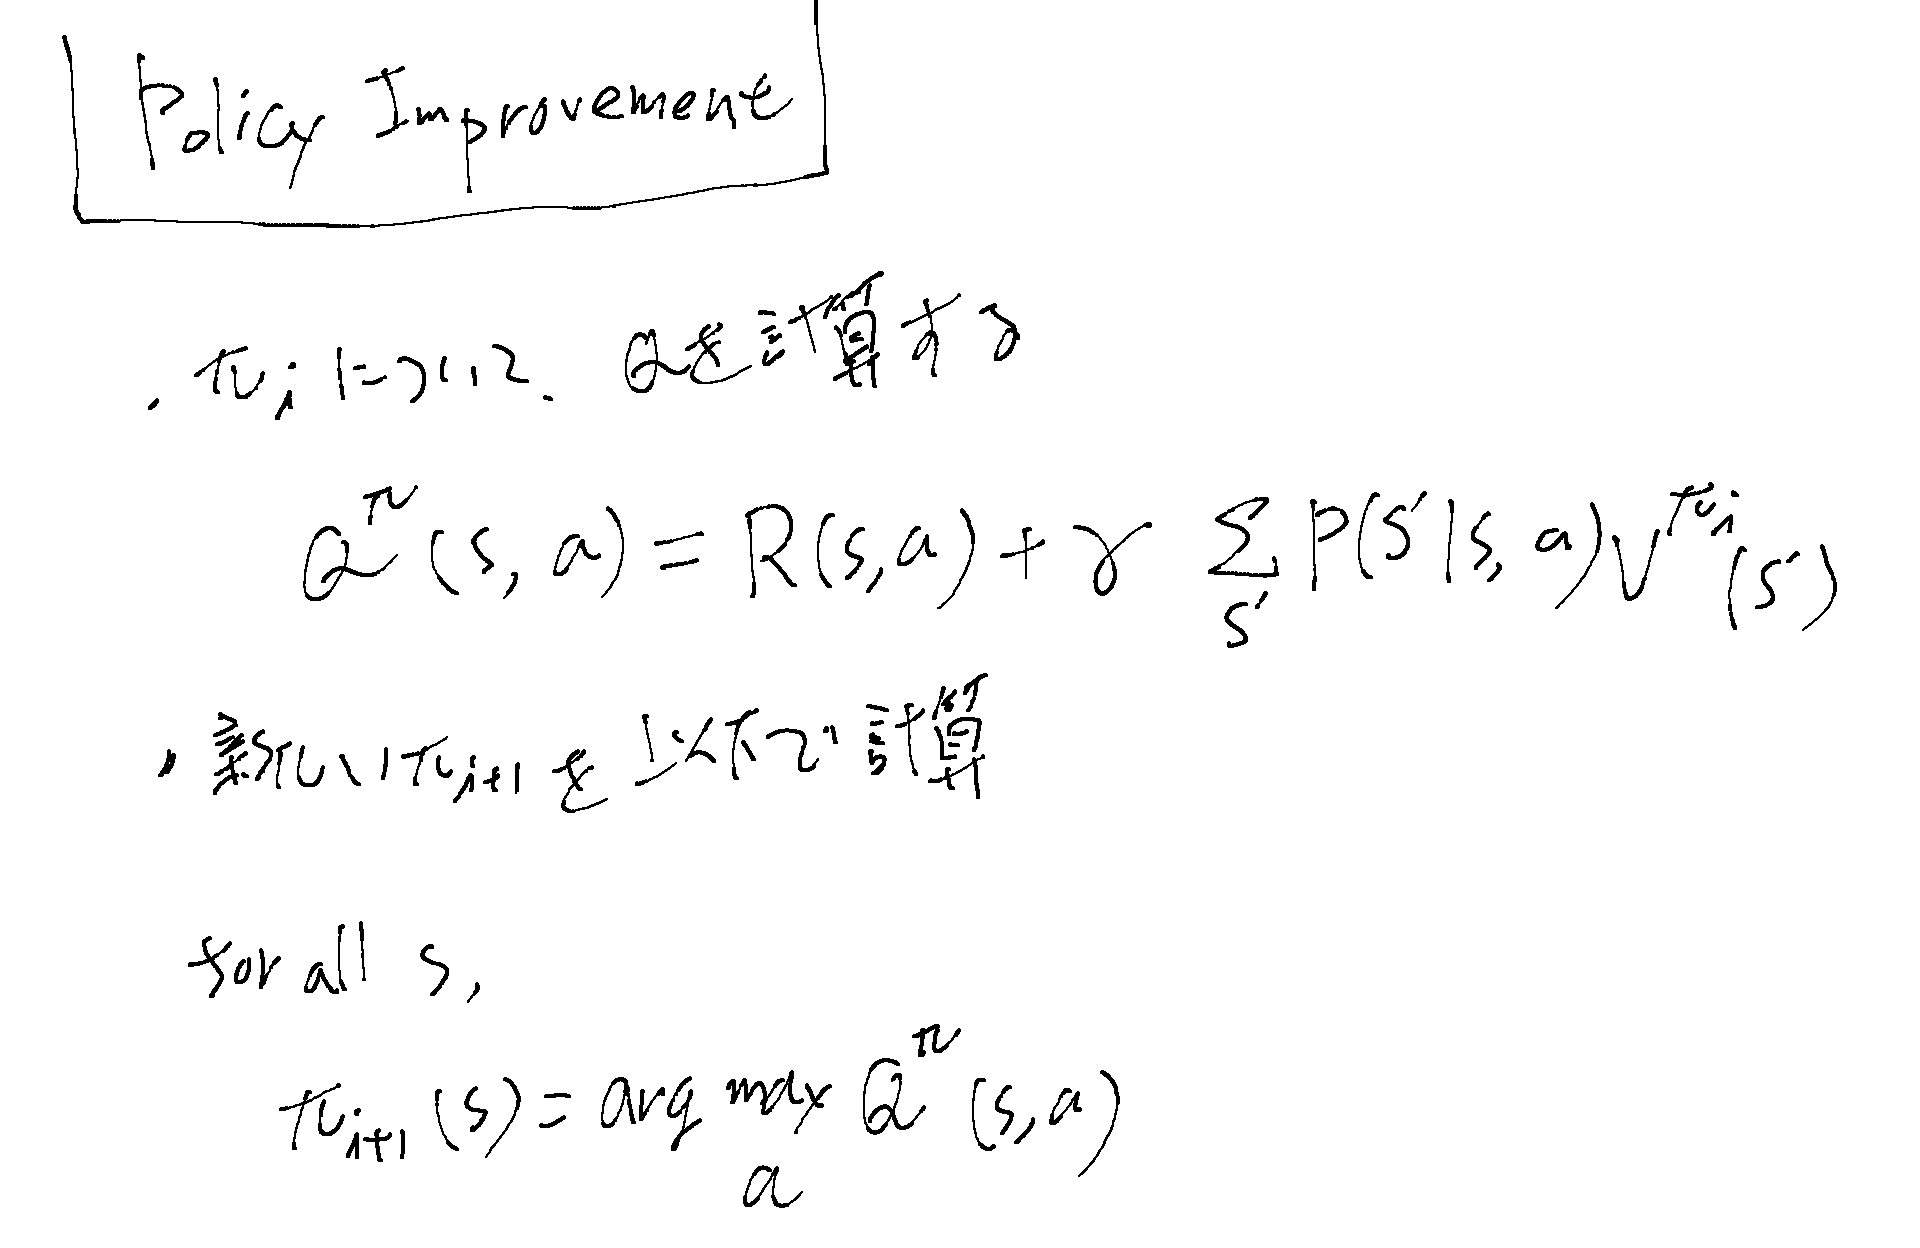
Policy Improvementは実際に何をやっているか?
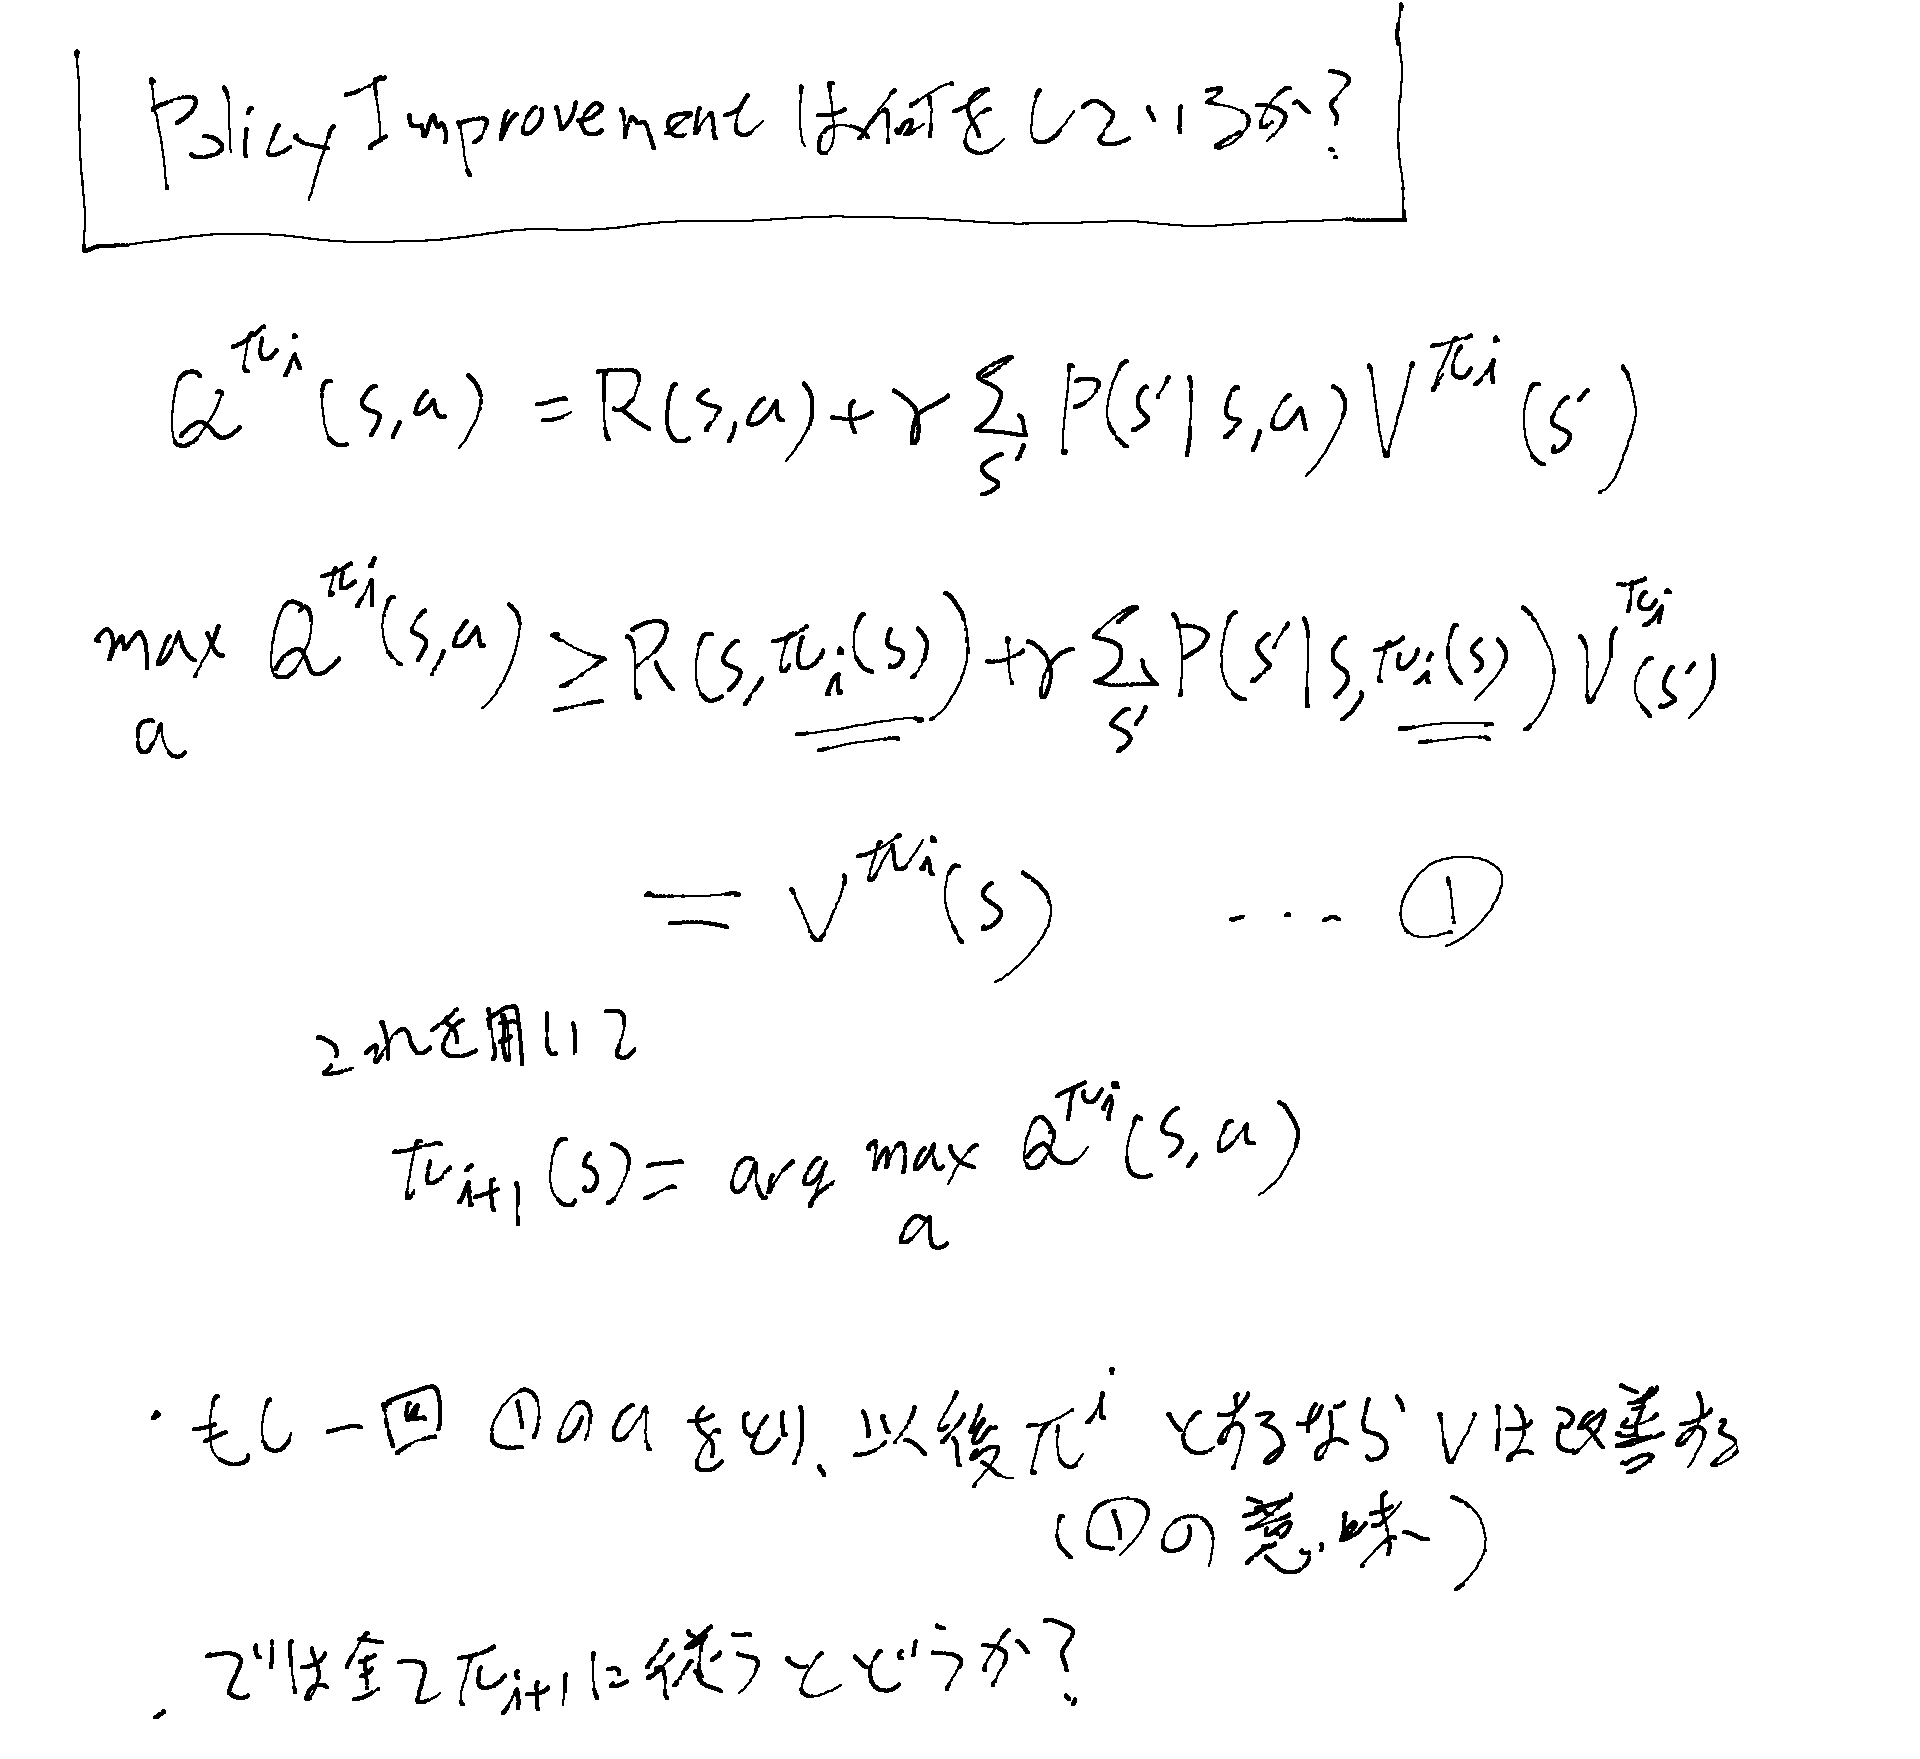
各sに対し、一つアクションをaに置き換えて、以後は前のポリシーに従うとVが改善する、というようなaを求めている訳だ。
このsに対して一回なら改善すると分かっているaのマッピングを全てのポリシーとして扱う、というのがPolicy Improvementの手続きとなる。
それは改善になっているのか?という疑問を見ていく。
PolicyのMonotonic Improvement
この手順がVを単調に改善していく、という事実を見ていく。
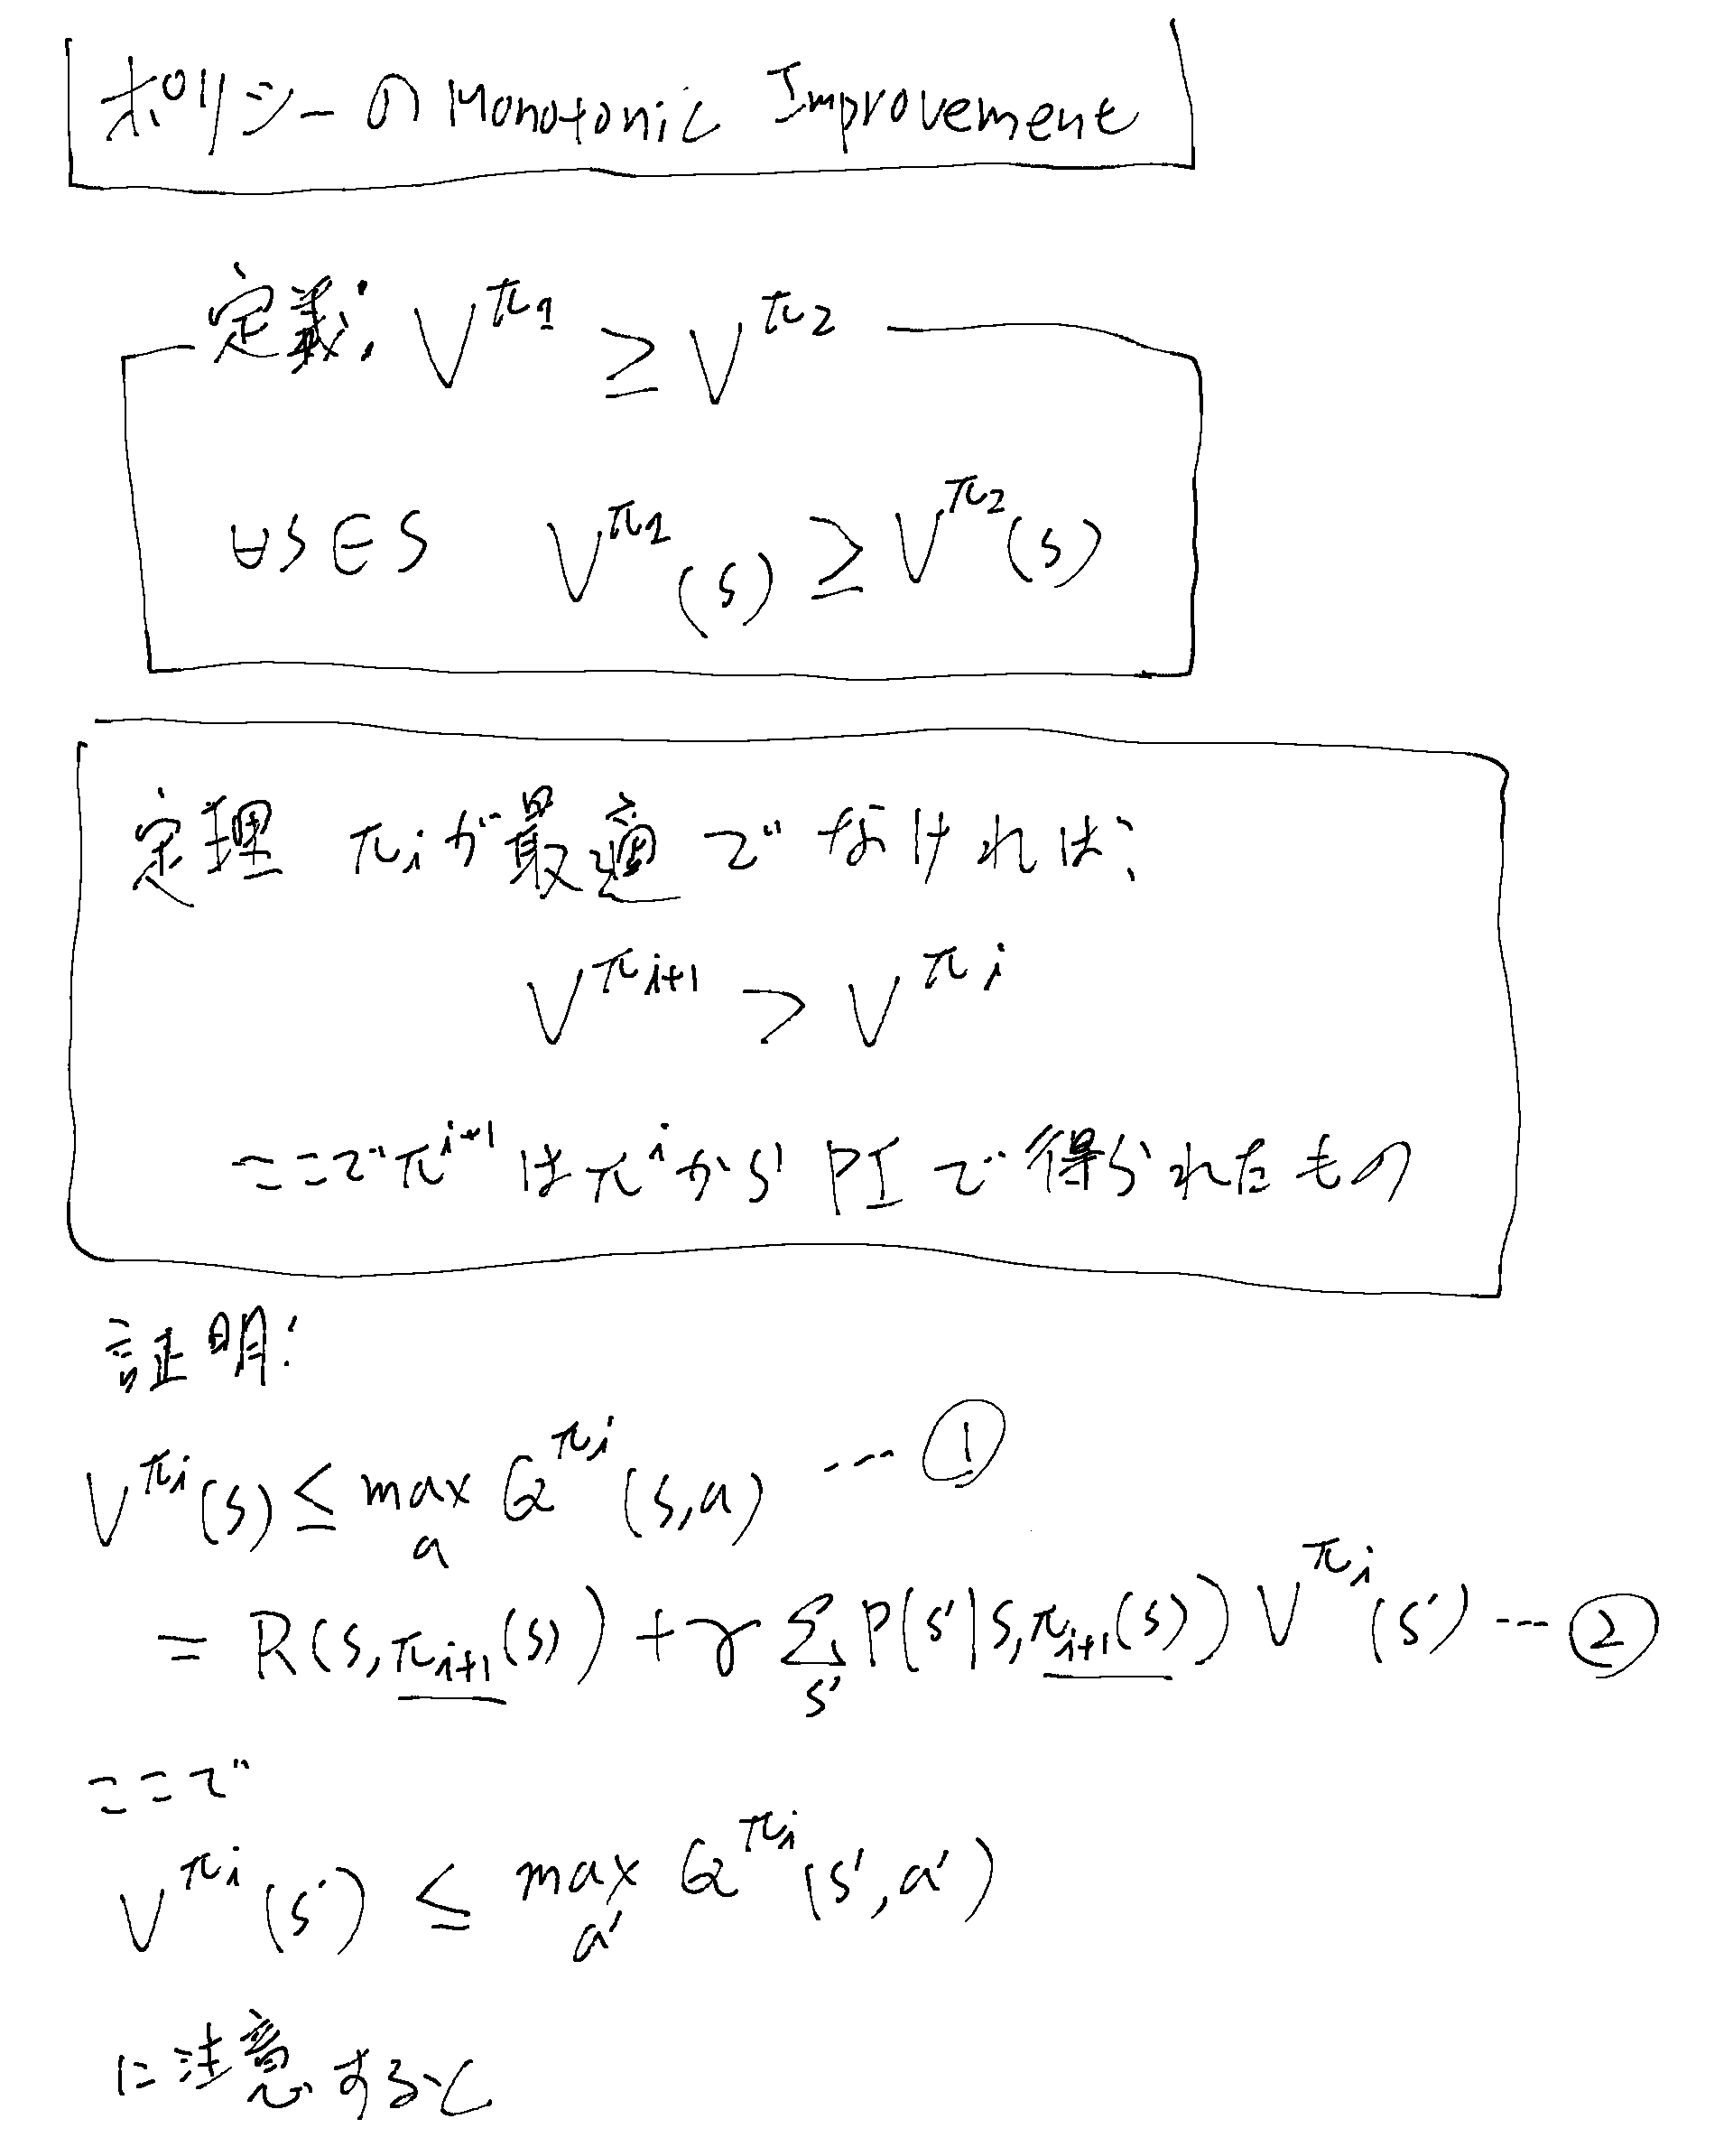
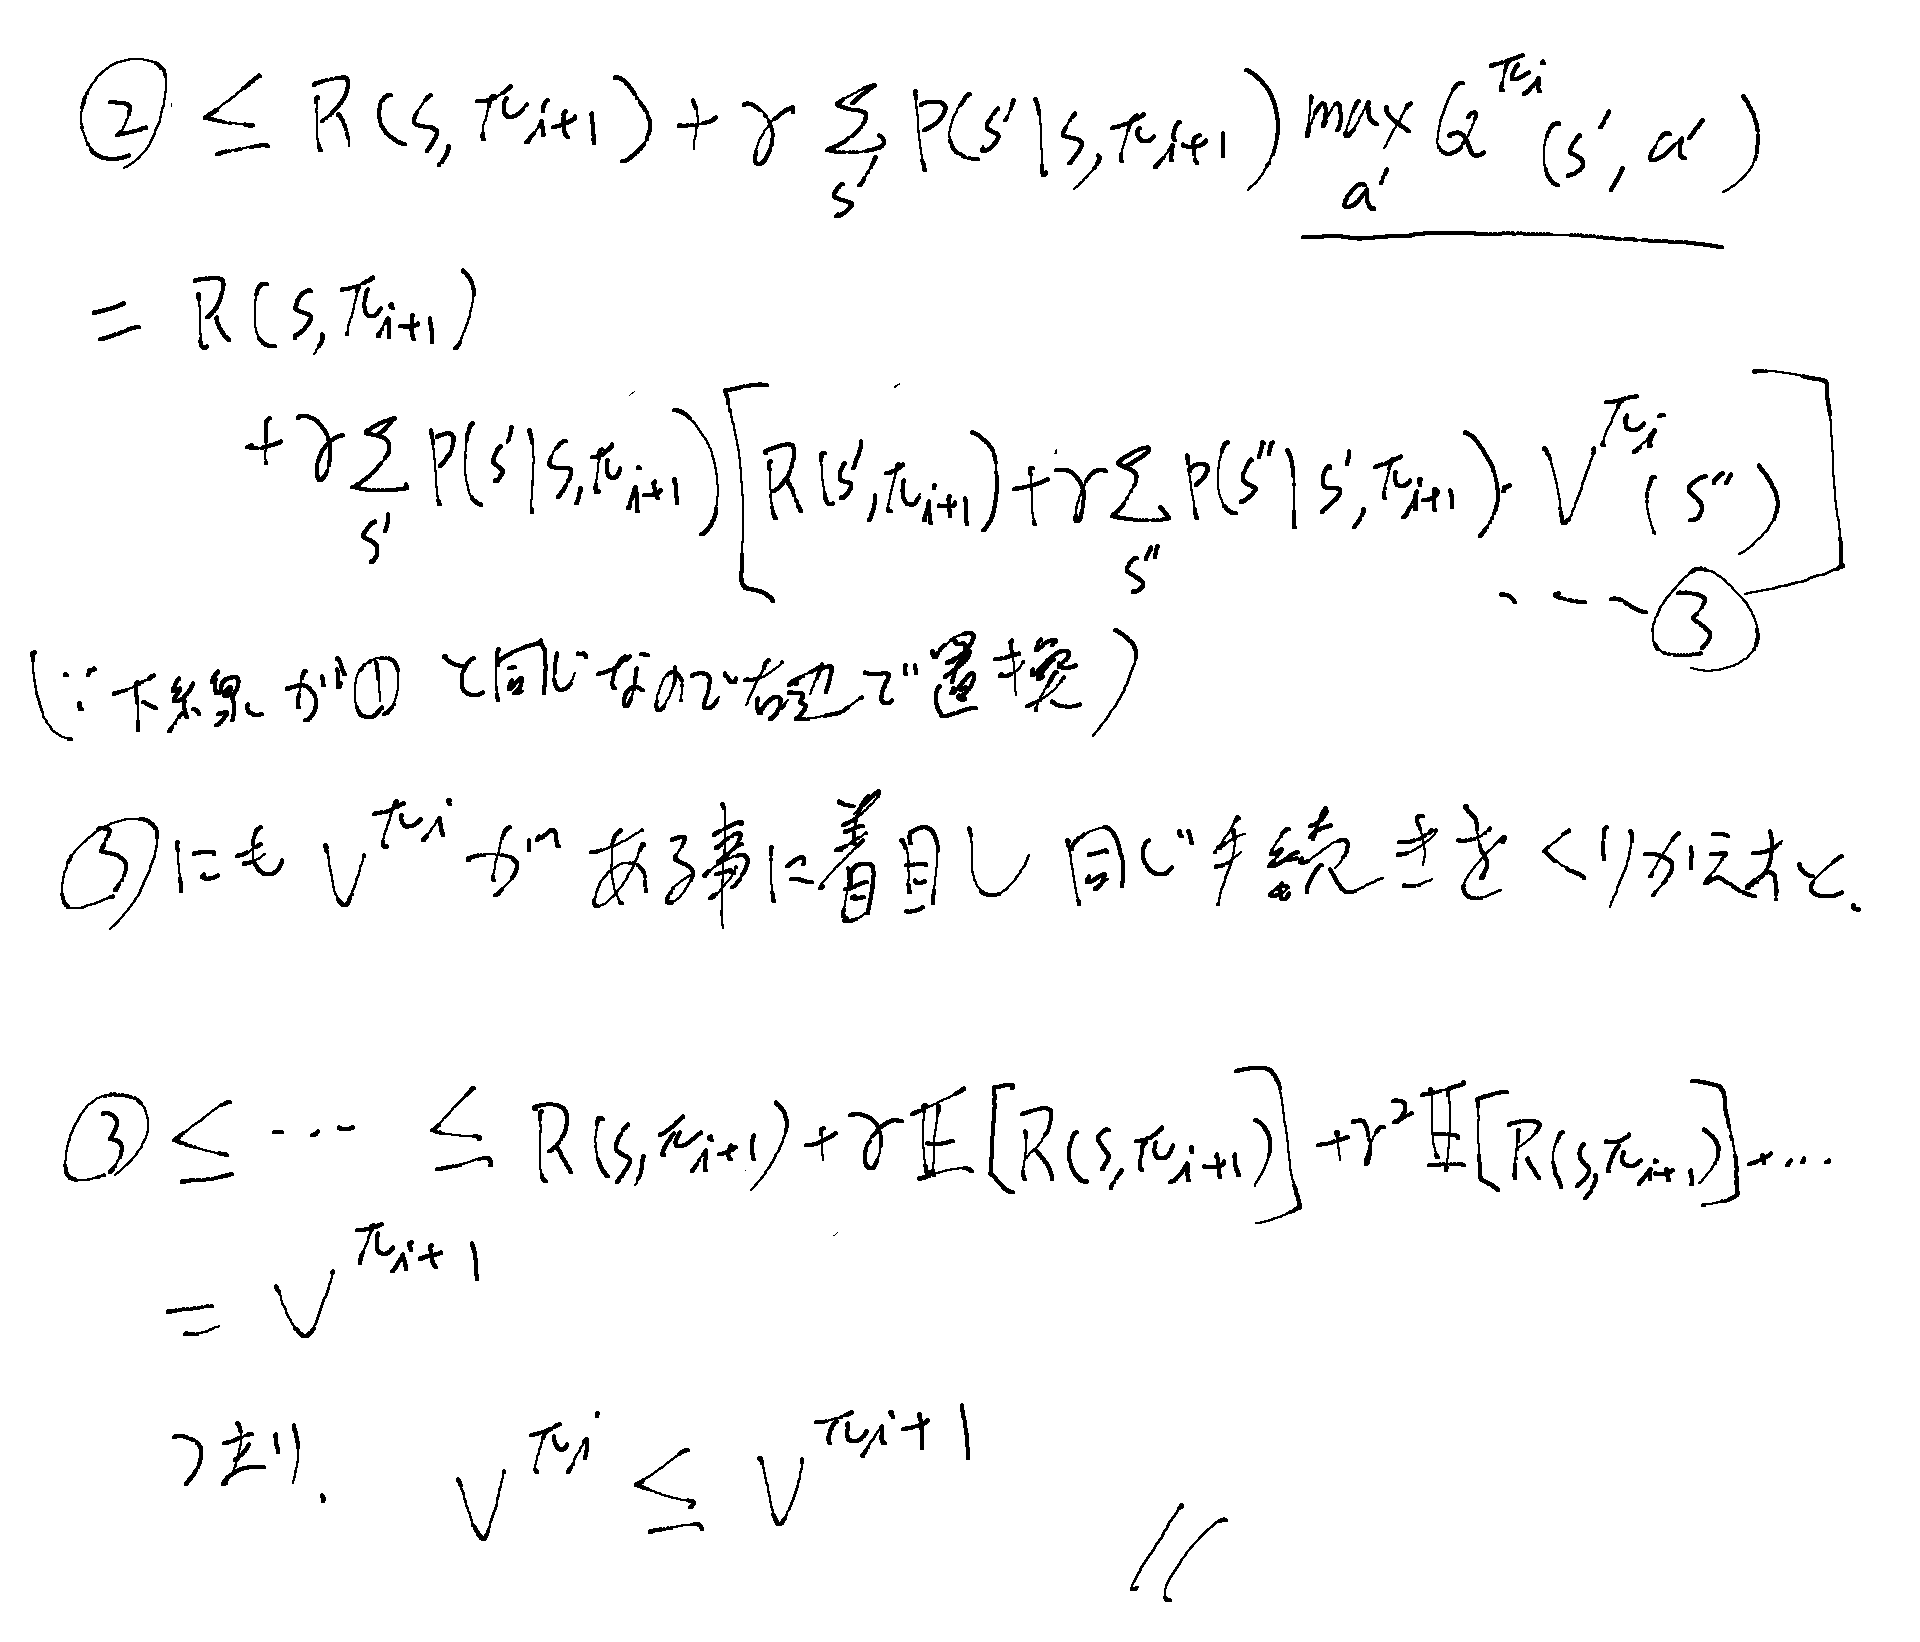
つまり、一つのアクションだけだとQが改善するという時に、 この残った前のポリシーのVをさらに新しいactionのQで上から抑えてそれを展開すると同じ形になるので、 再帰的にこの操作を繰り返してどんどん未来のポリシーを置き換えていける。
割引率で将来は消えるのだから、間の残った項だけを見ると、これが新しいポリシーでのVとなっている。 上から抑えた結果が新しいポリシーなので、新しいポリシーの方が上となる。
等号は全てのQのargmaxが元のポリシーと同じ場合のみで、それは既にVが最適なケースとなる。
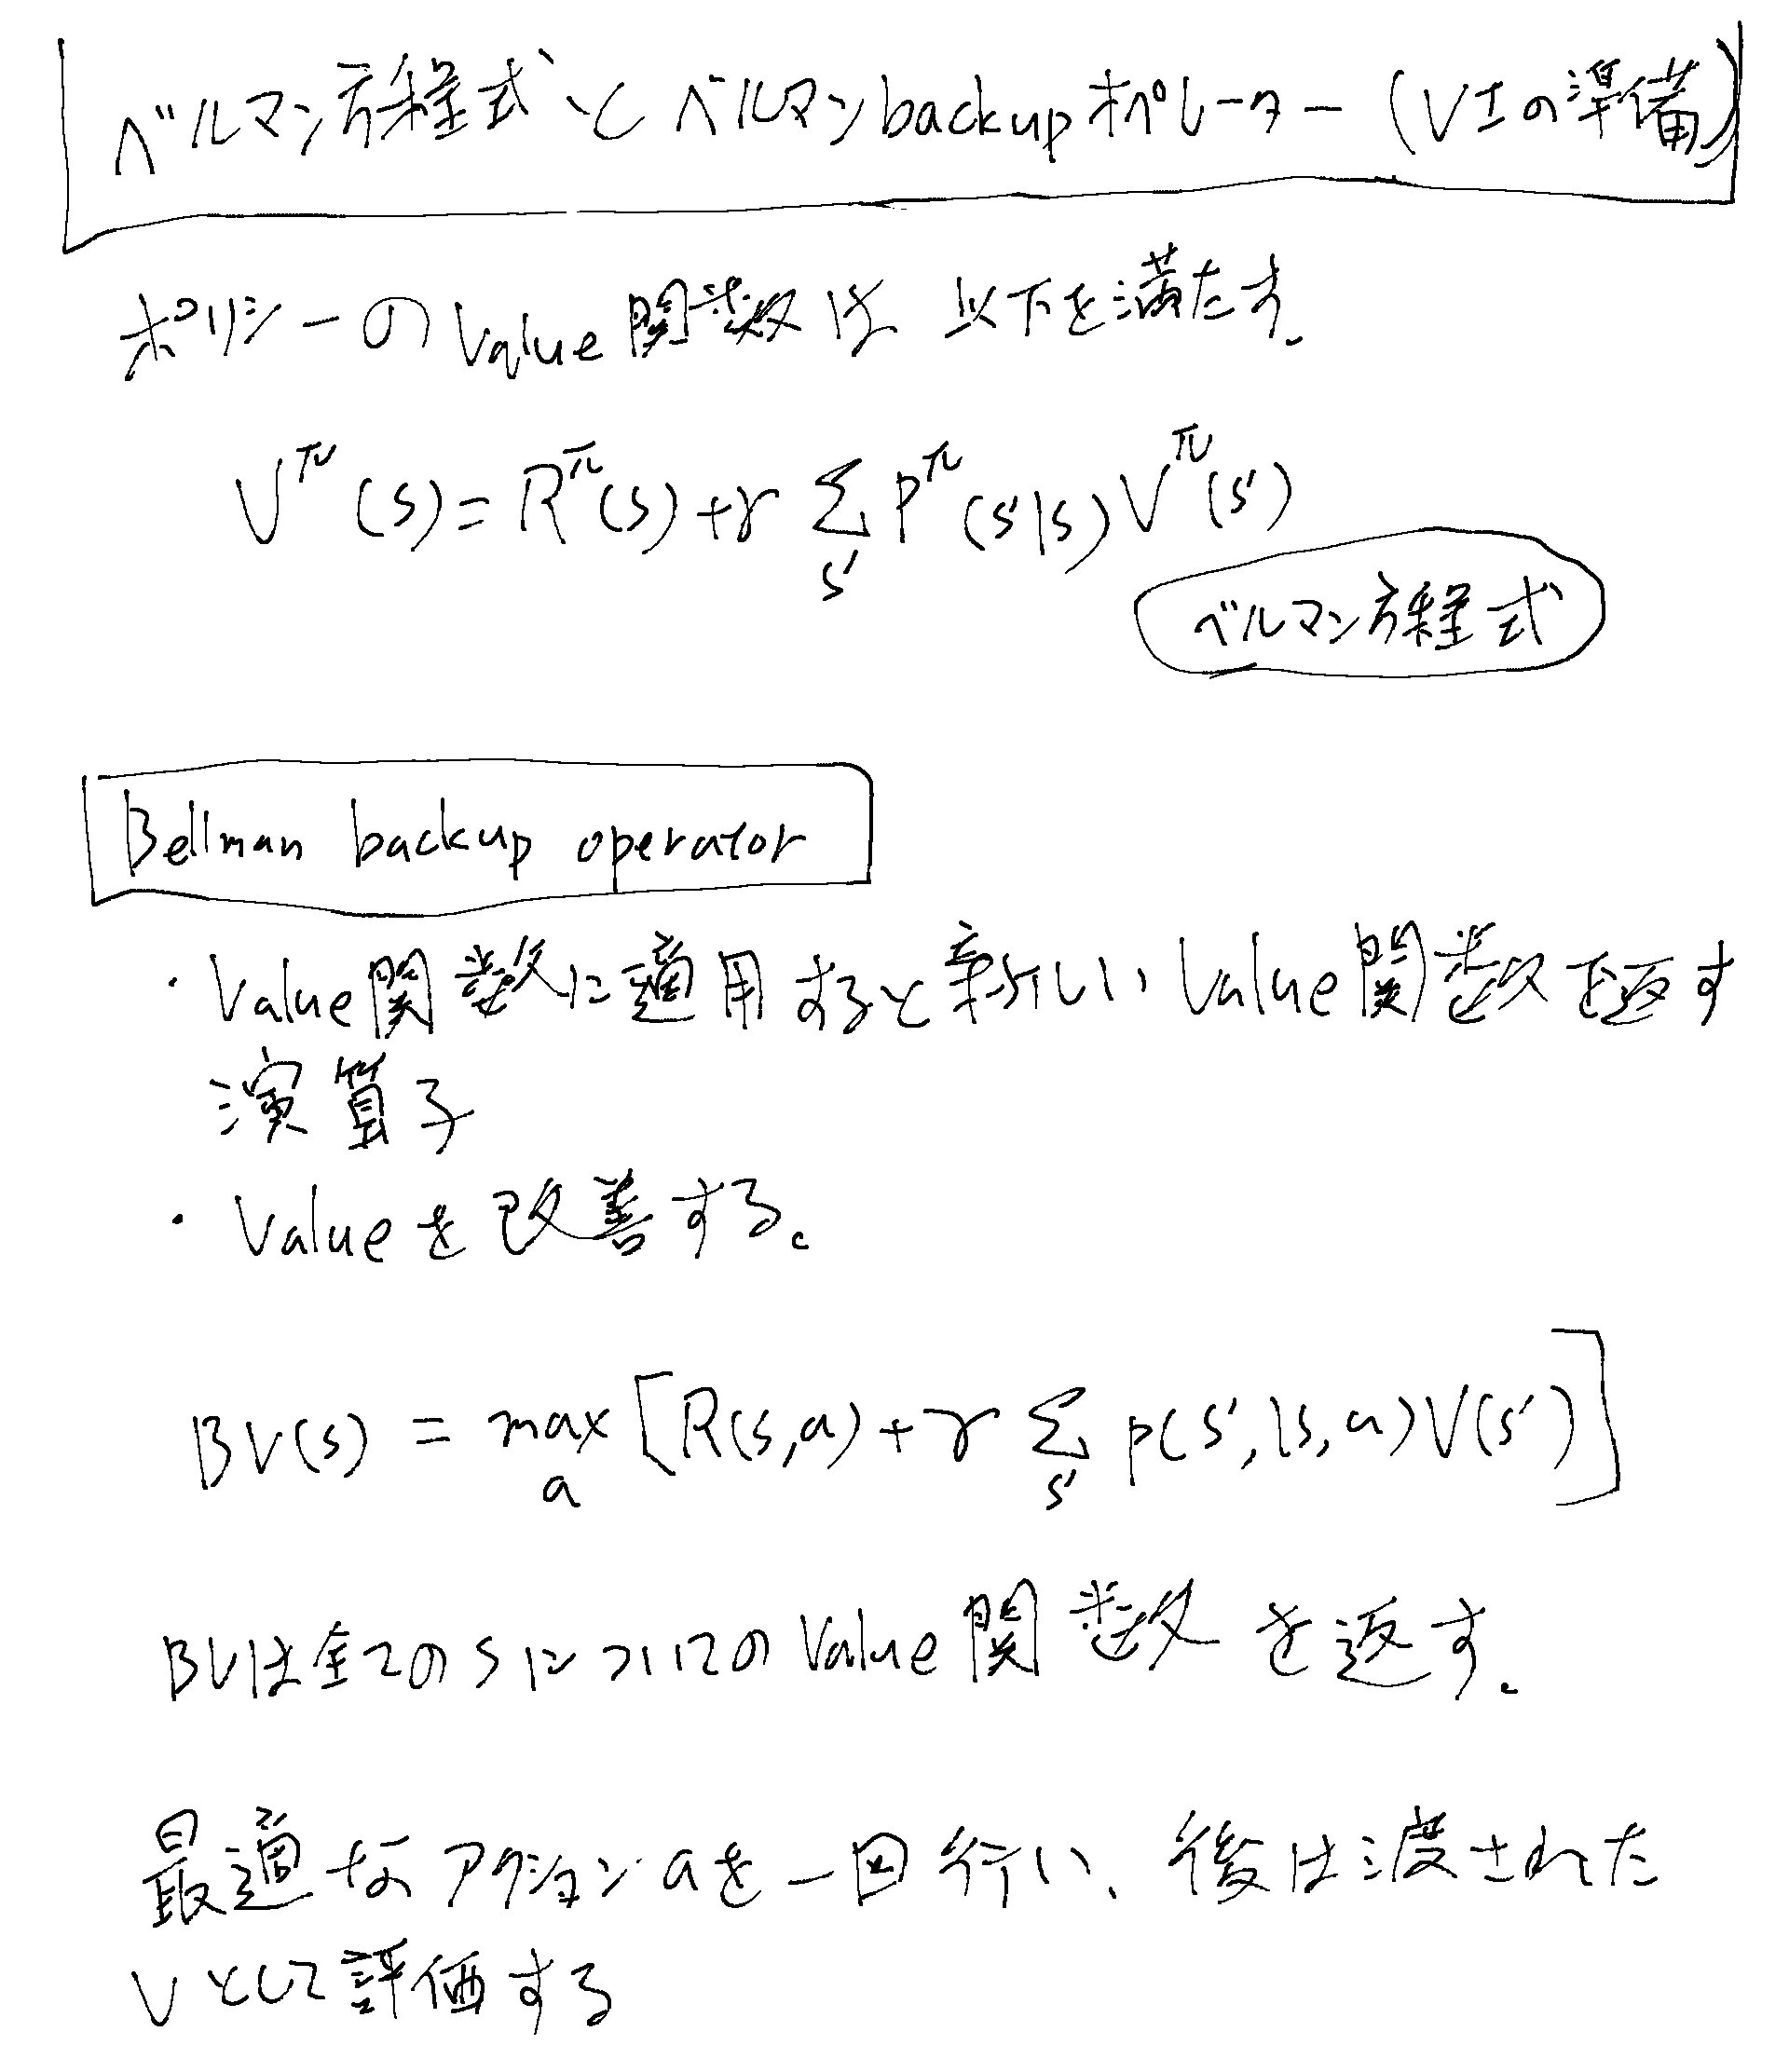
Bellmanのバックアップ演算子
次に最適なVを求めるという問題を考えるにあたり、下準備としてBellmanのBackup Operatorを定義する。
Value Iterationによる最適なVの計算
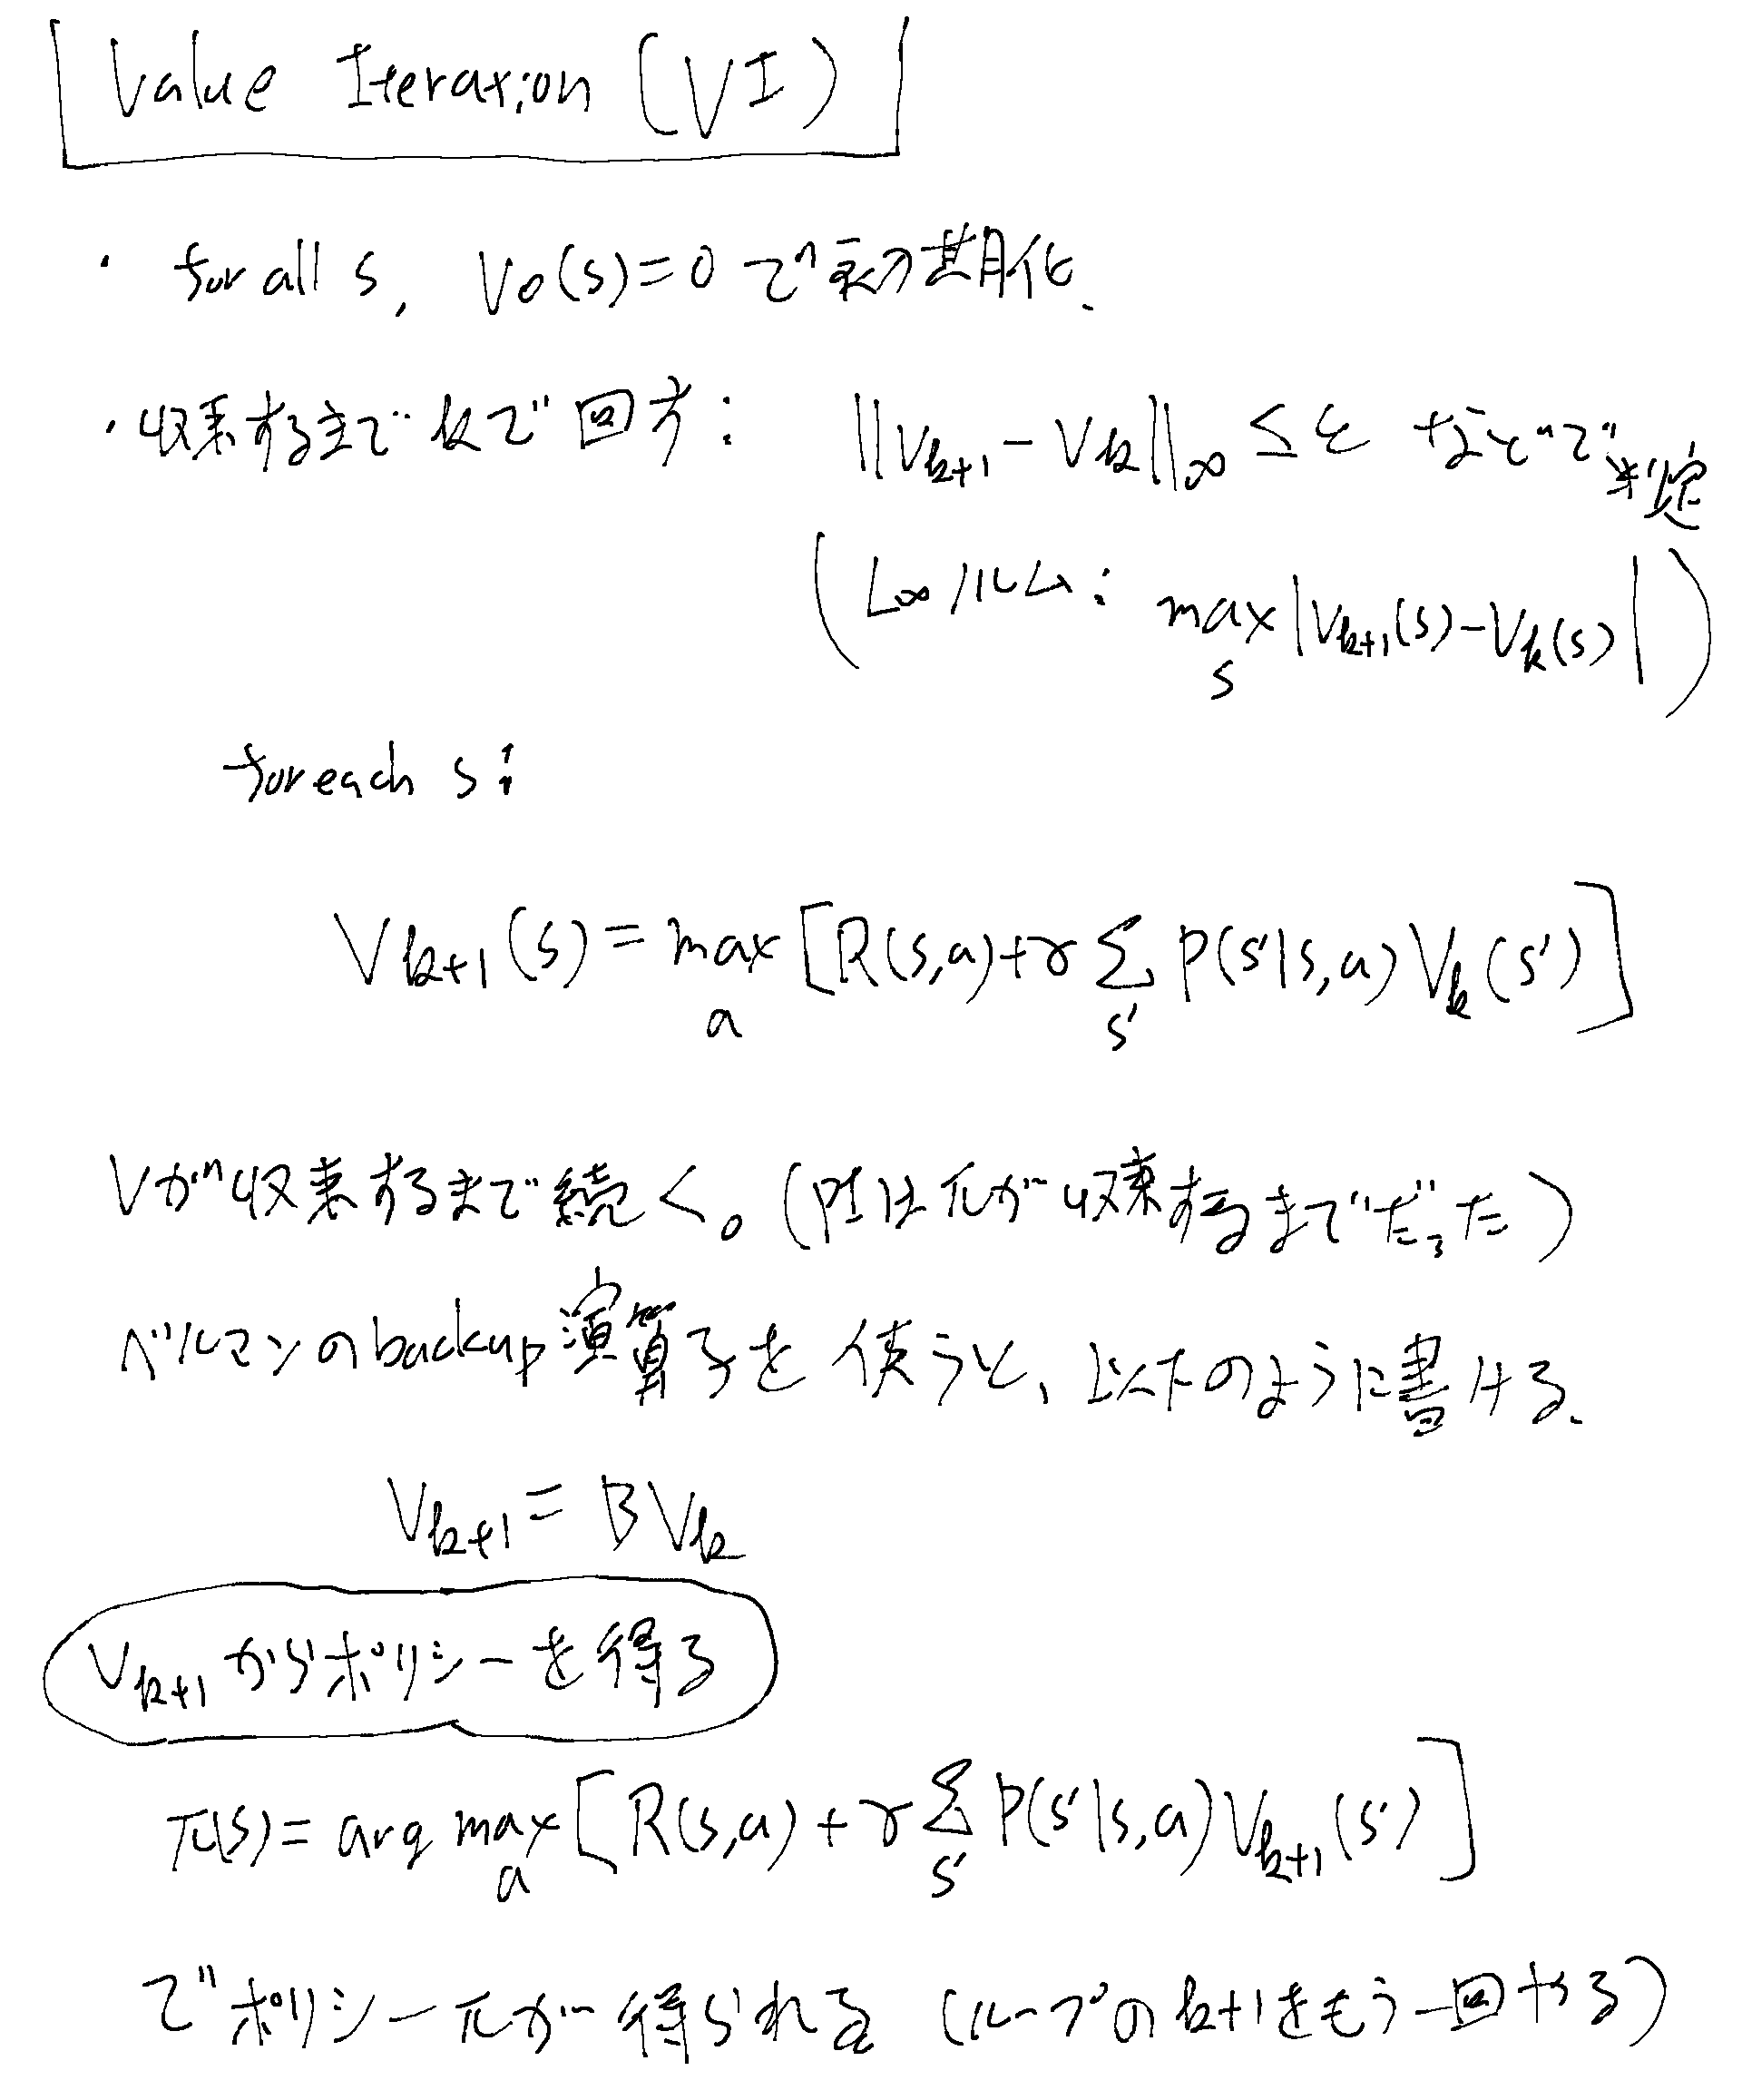
初期化したVから始めてバックアップ演算子を収束するまで延々と適用し続けていけば良い。
バックアップ演算子は最適なaを探す操作を含むので、最適なVが出た後に一回同じ操作で最適なaを各sについて探していけば最適なポリシーも得られる。
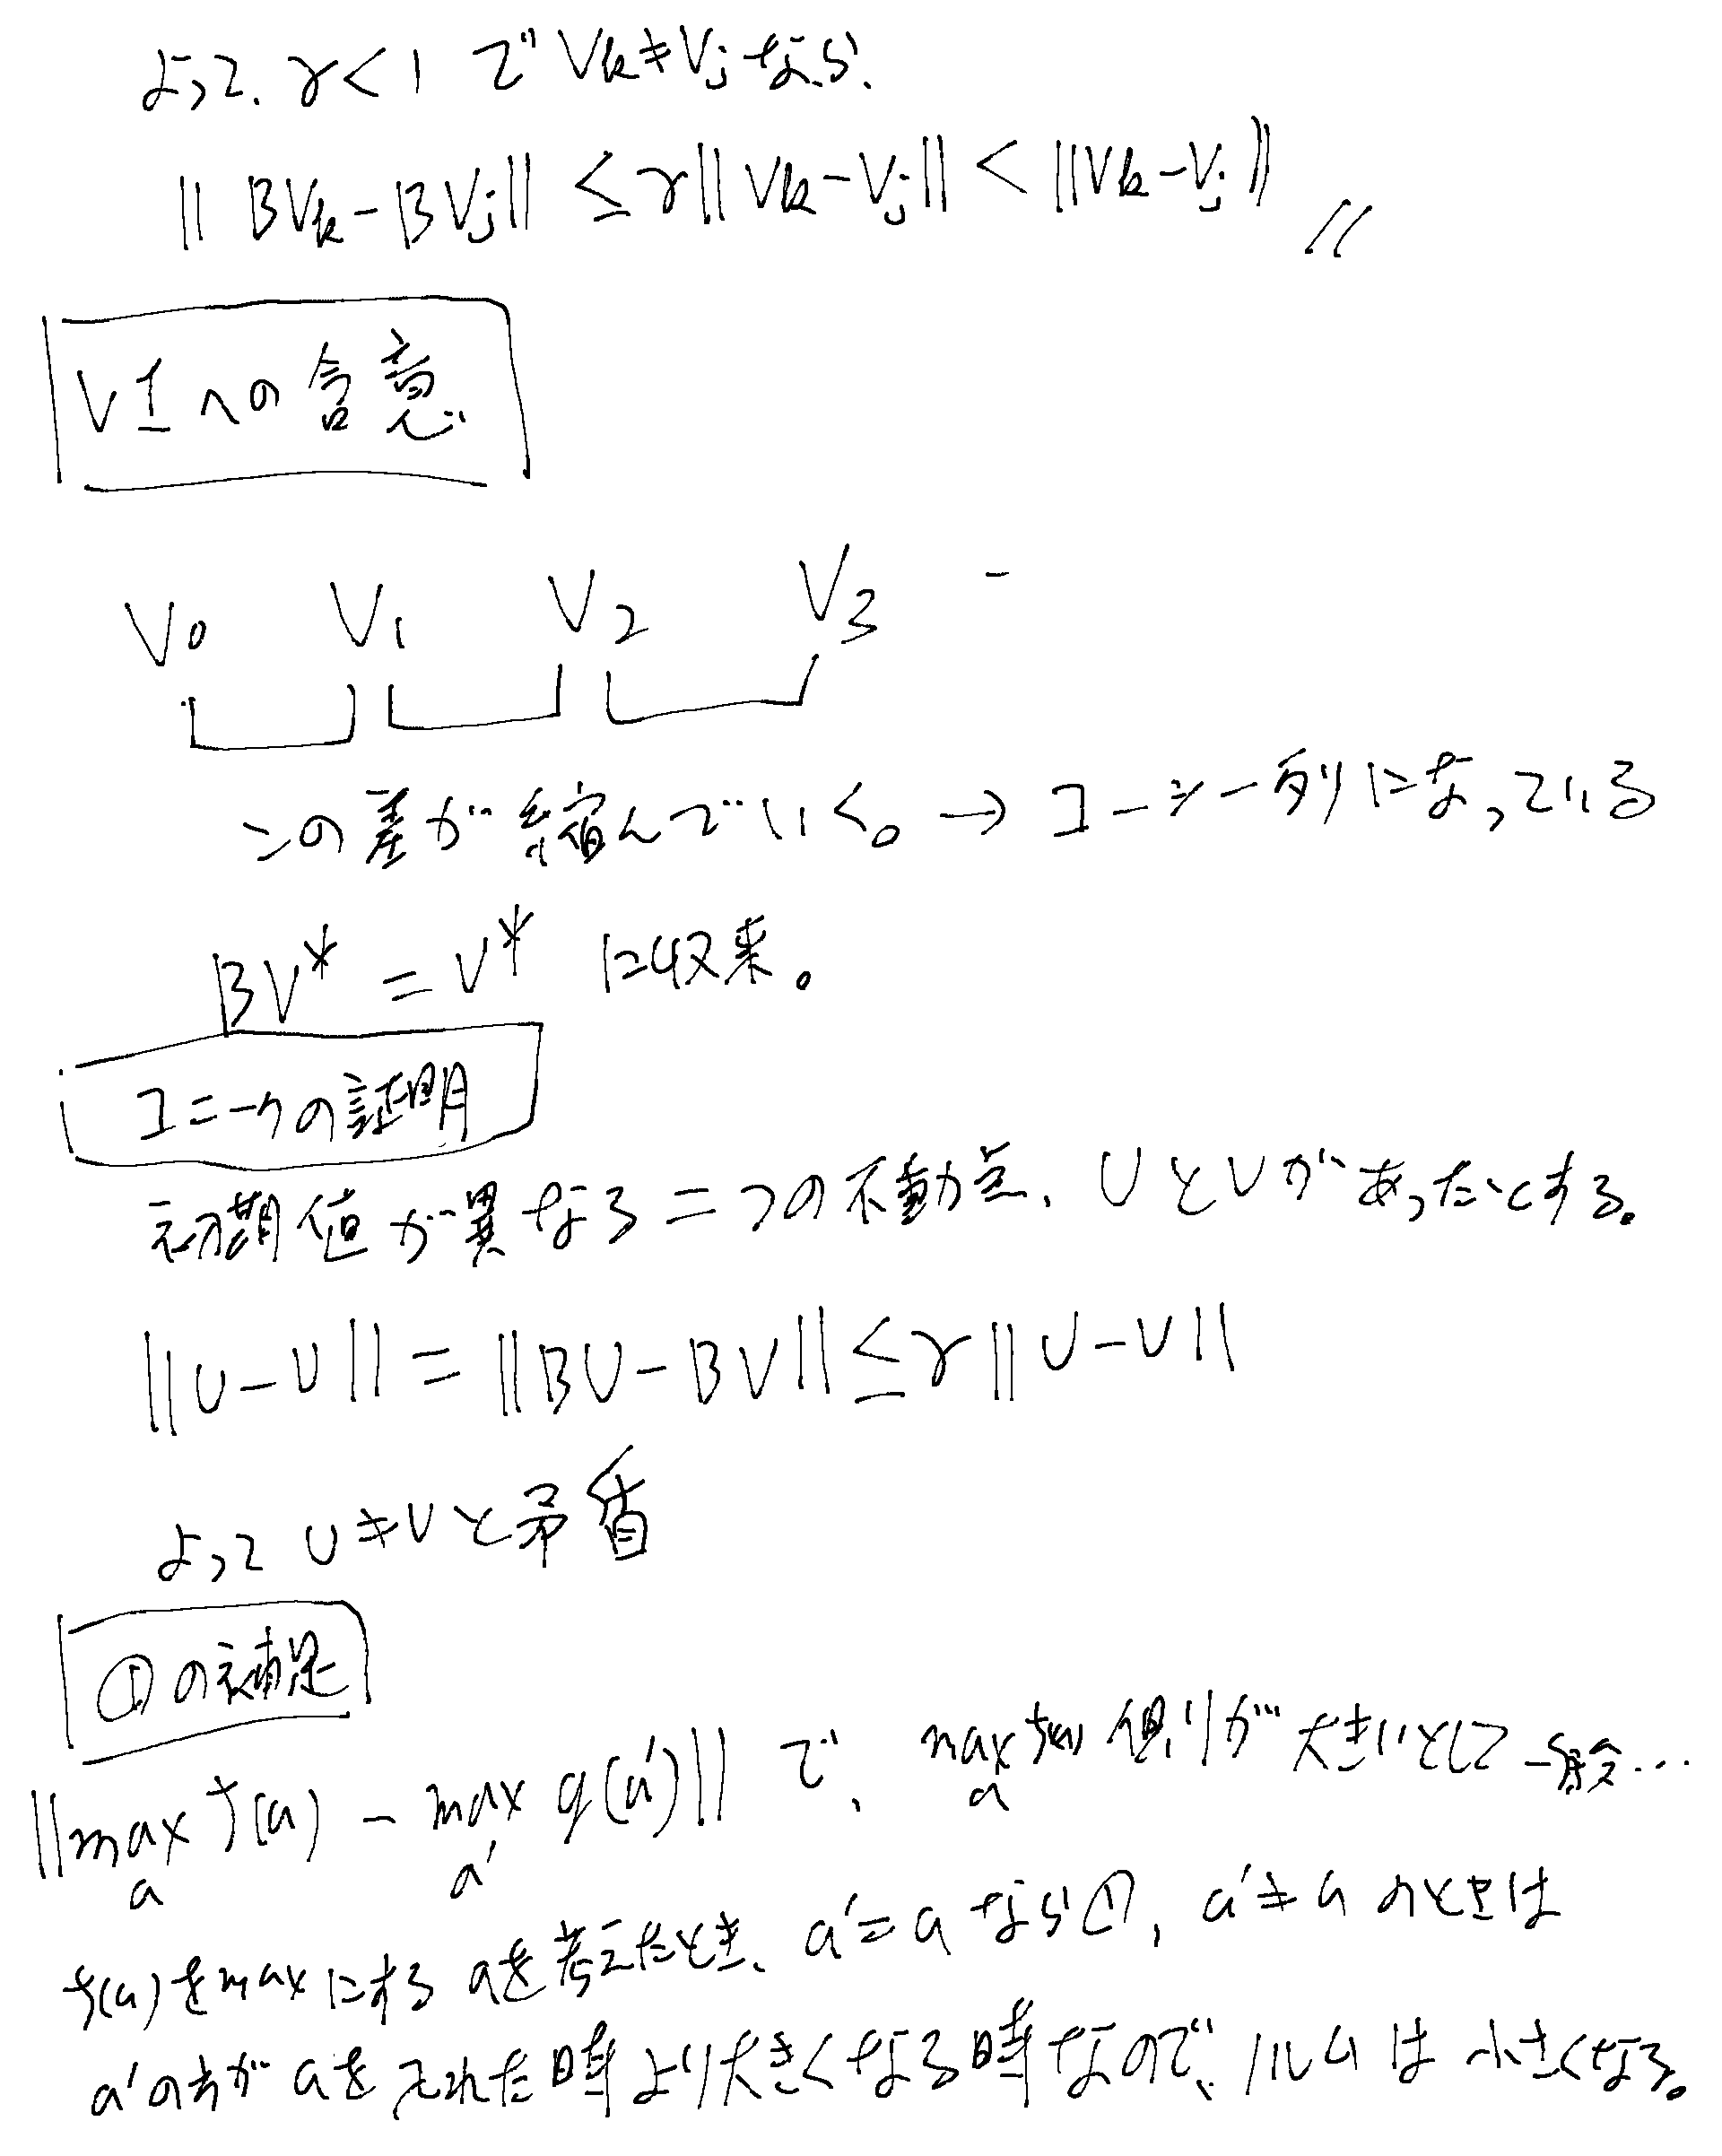
VIが最適な解を得られる証明
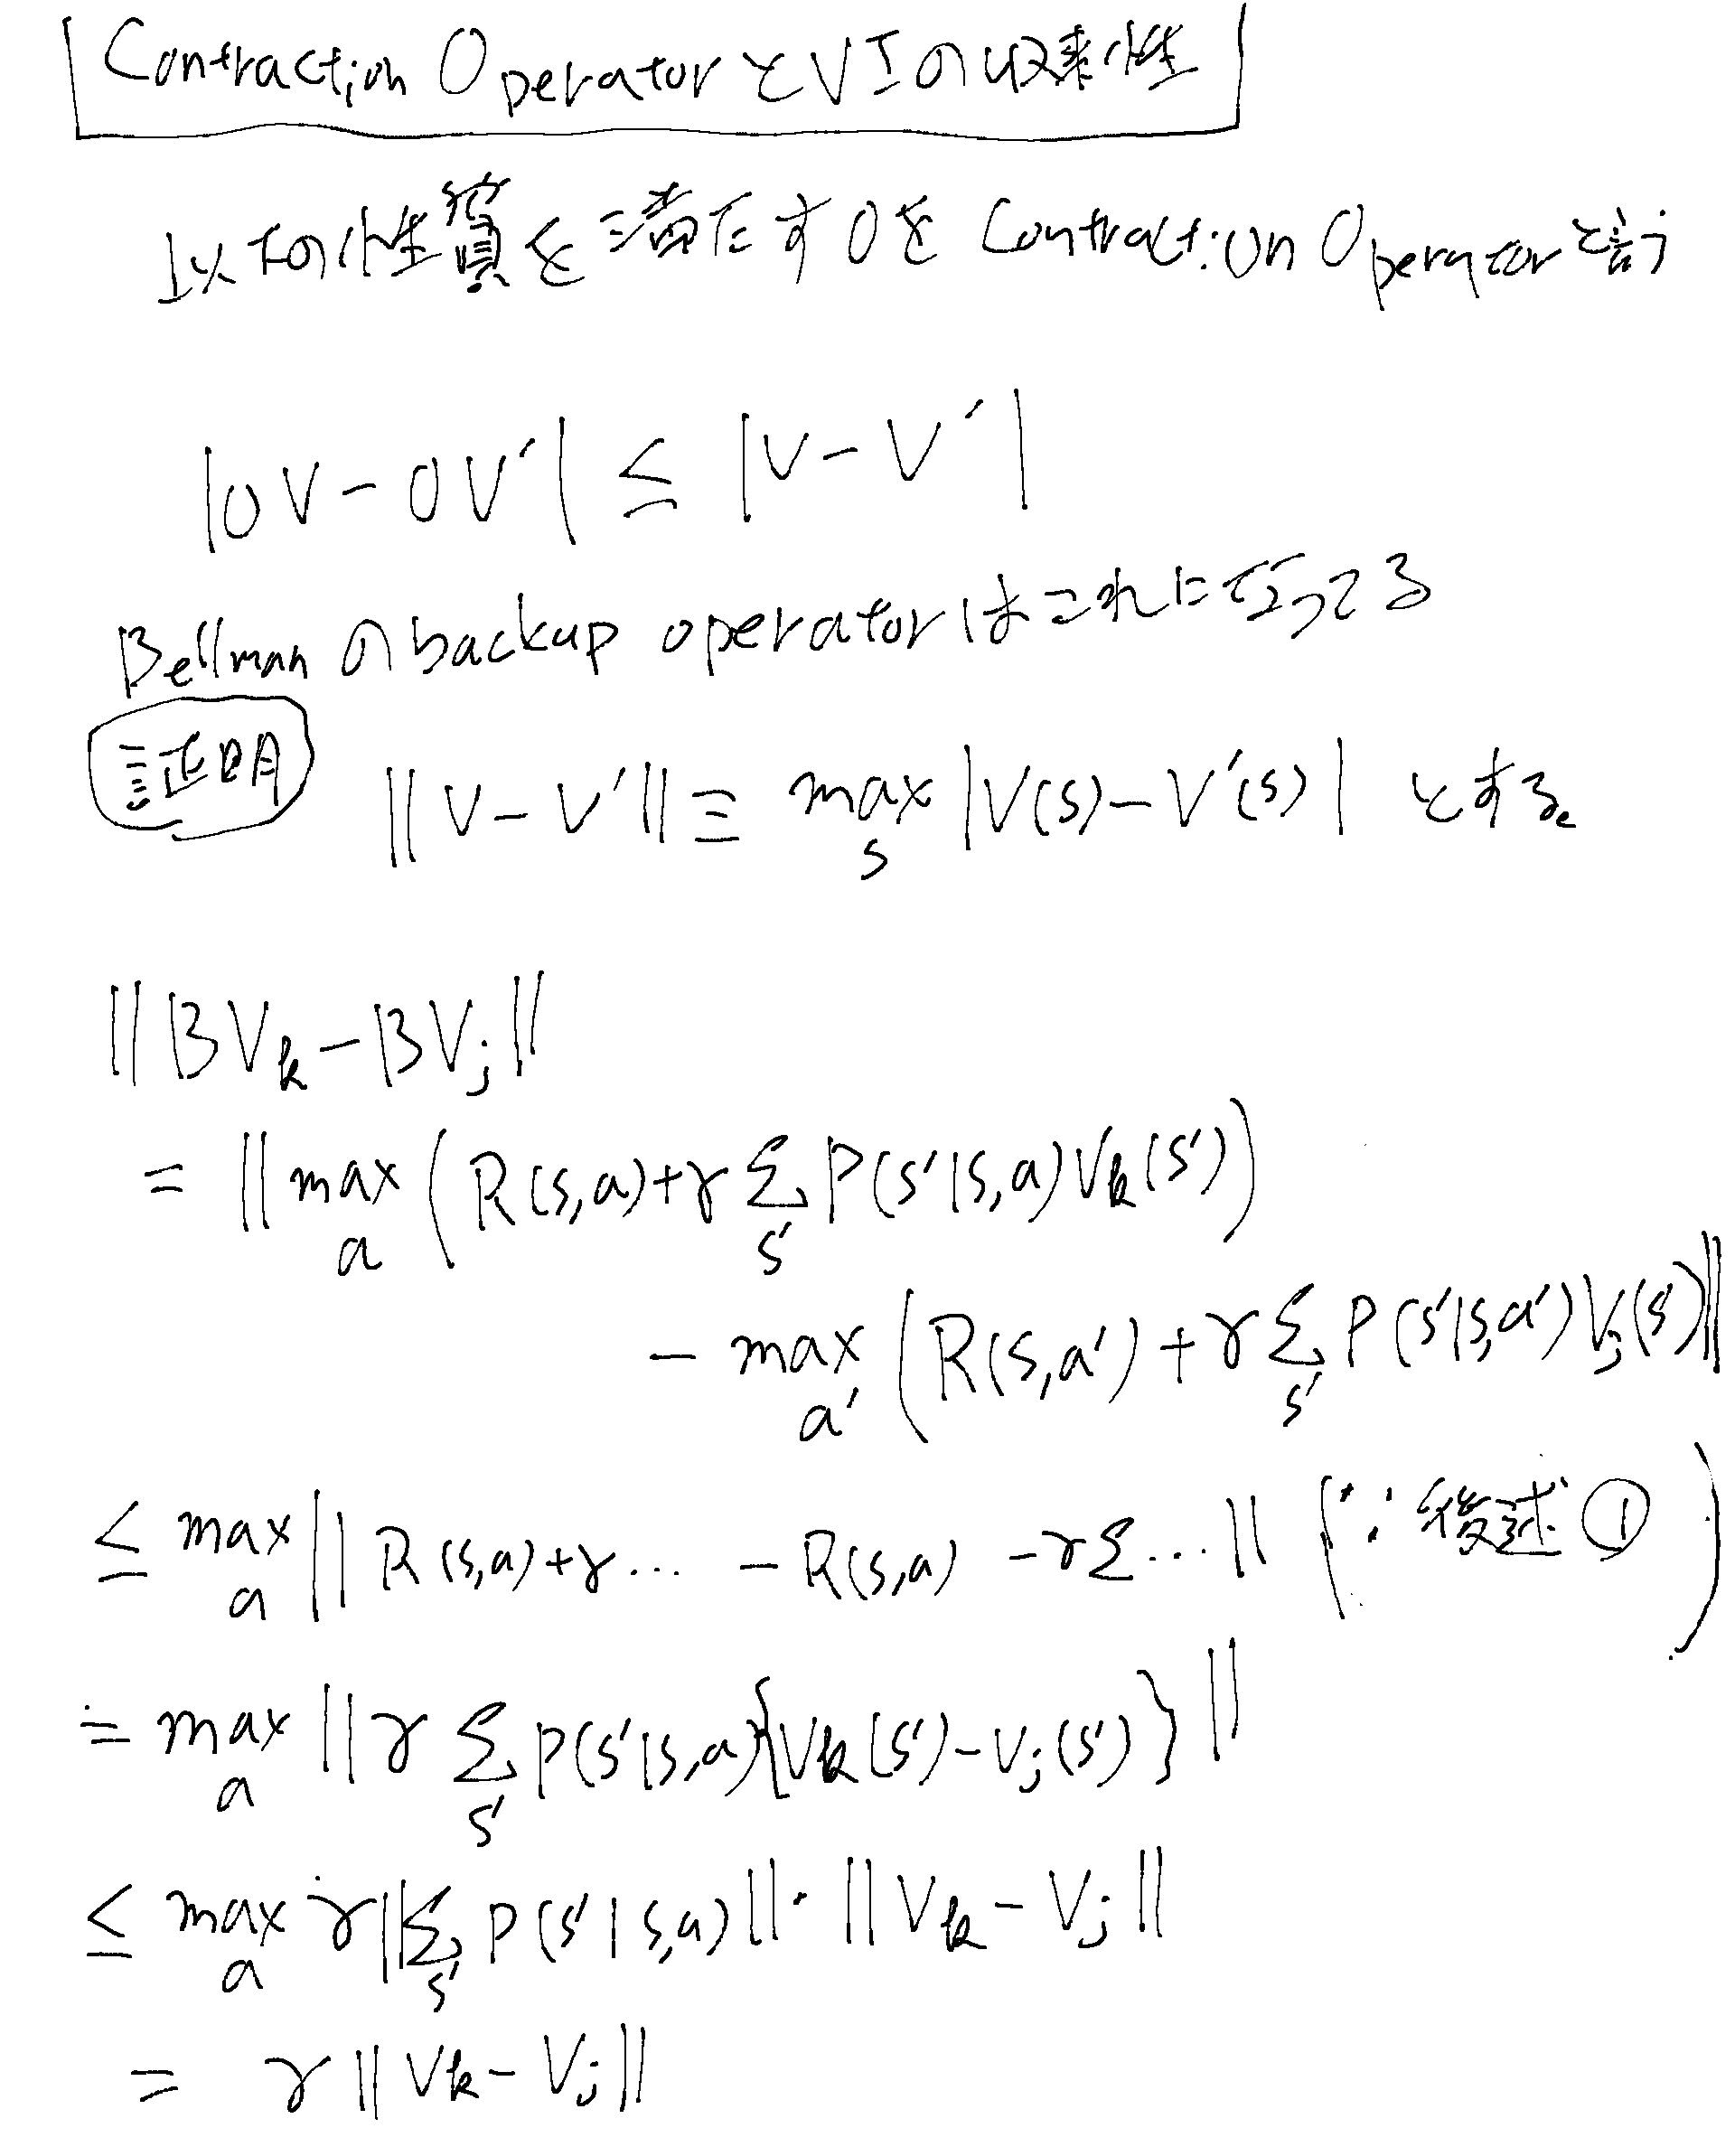
PIをバックアップ演算子で考える
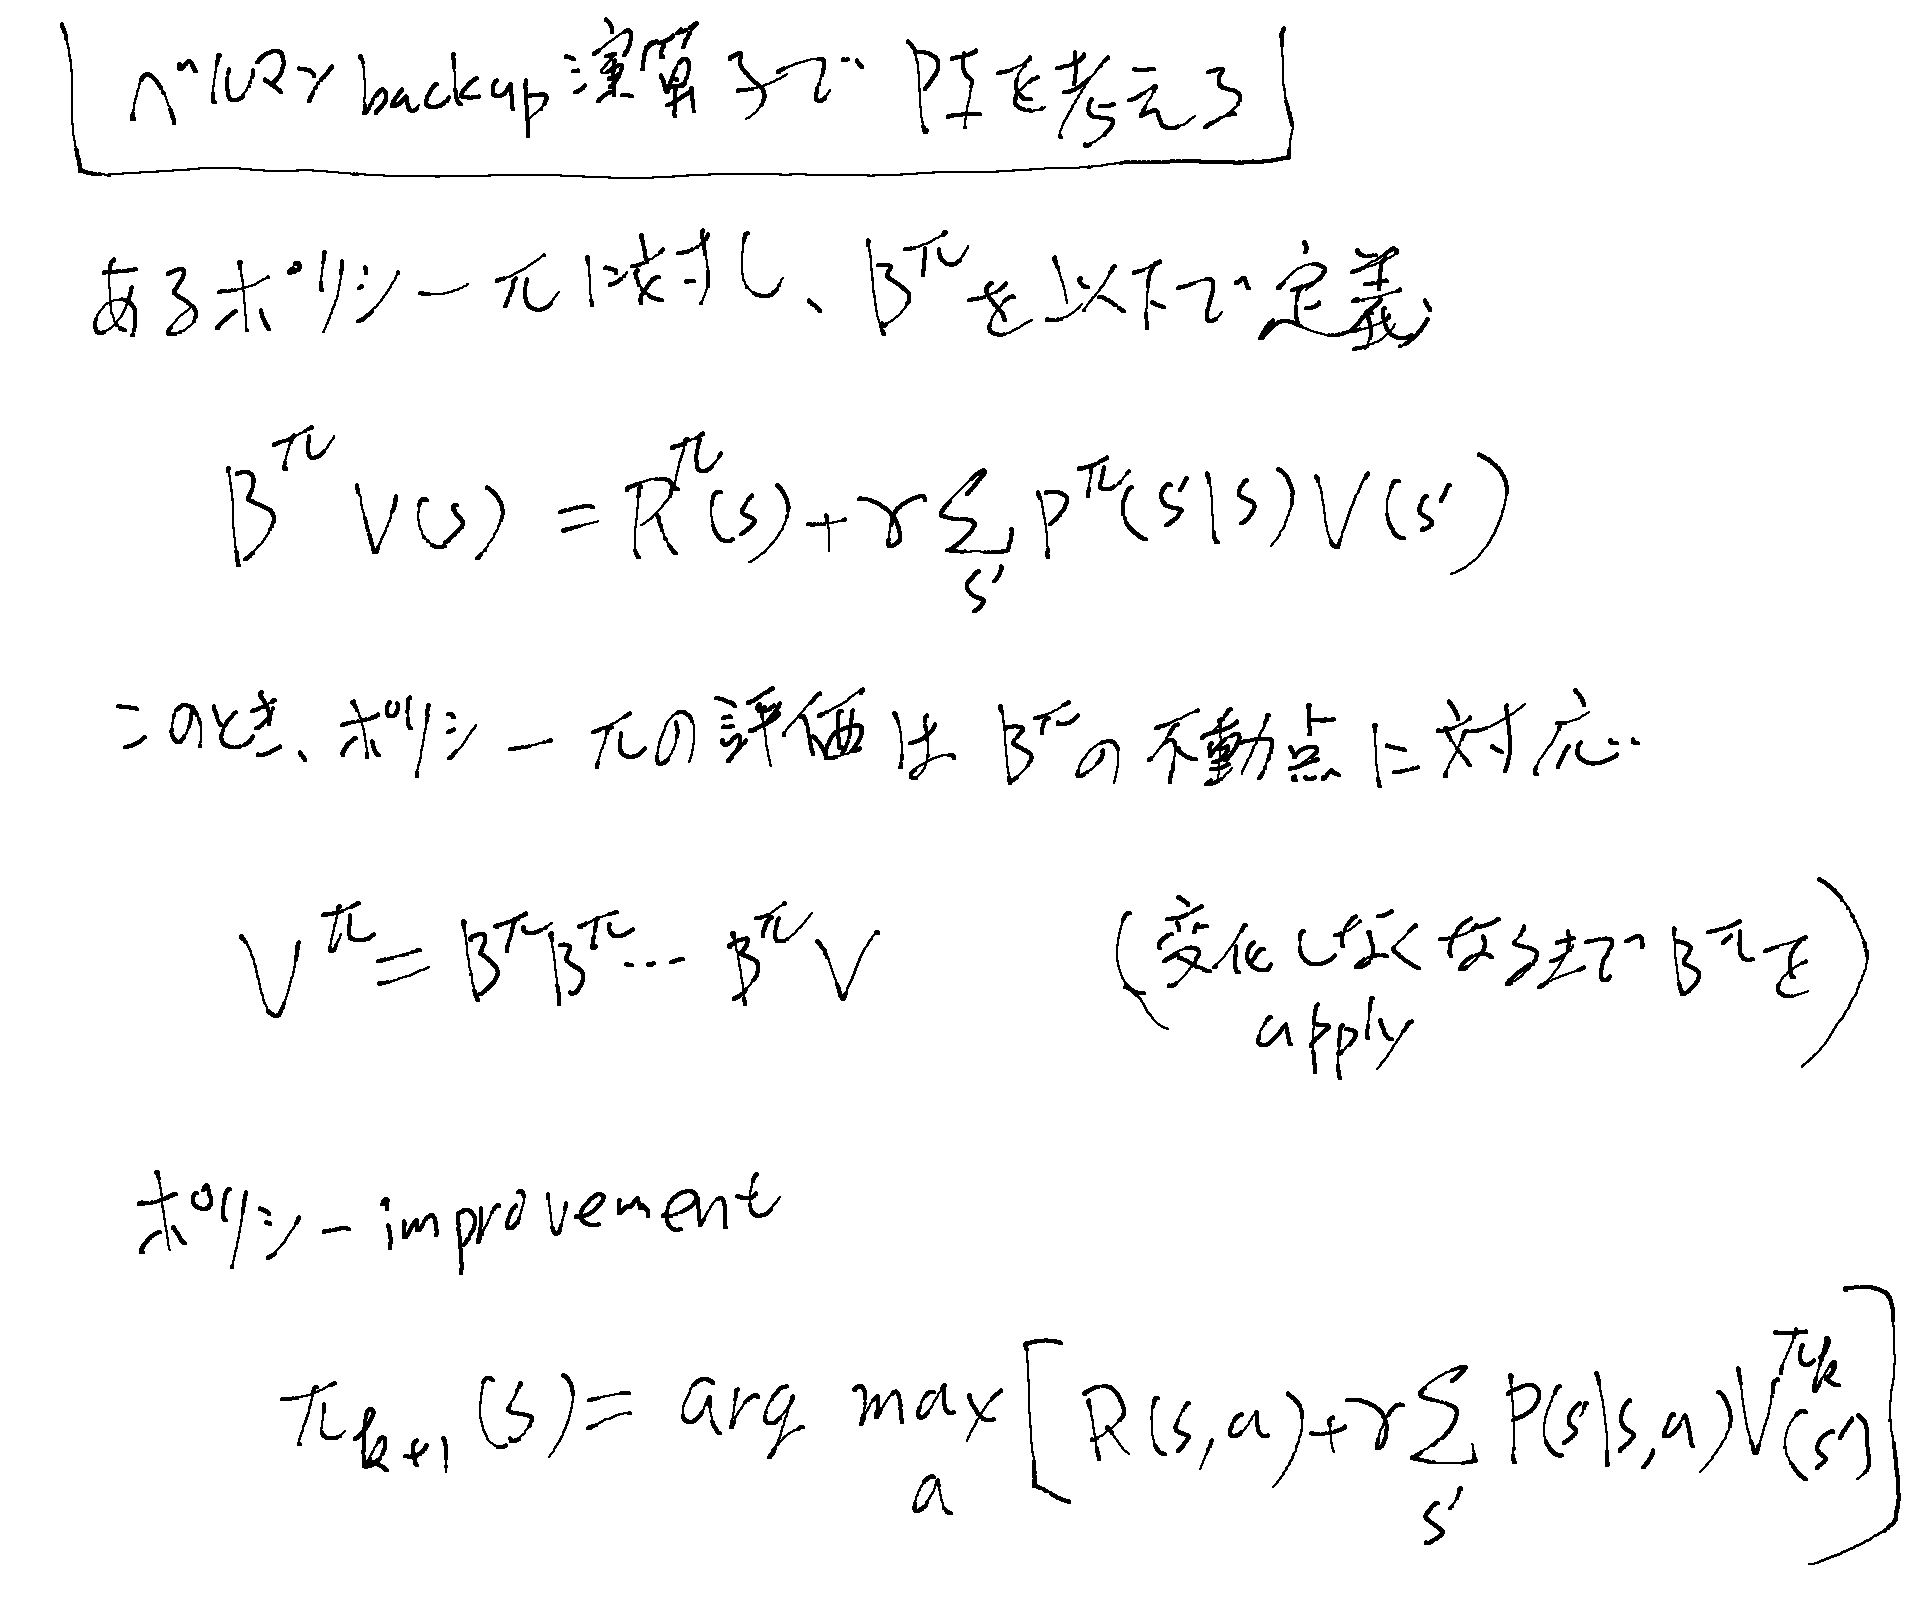
あるポリシーに対するバックアップ演算子を定義して、それを繰り返し適用する、という話。
一回適用すると1期のポリシーに従った時の利得と、それ以後の初期に与えられたVの利得、という計算になる。 これをN期までやればN期までポリシーに従った利得となり、 無限に繰り返せばポリシーに従ったValue関数になるという事か。
ポリシーに対応したValue関数を得るというのはそのポリシーの評価の所でやった話と合流する。
ポリシーに対するValue関数が得られれば、1期分だけValueを改善するactionを探す、 この時、以後のValueを得られているポリシーのValueで計算出来る、というのがポイント。
これで1期分だけ改善するactionを各sについて求める事が出来、これを新しいポリシーとする事が出来る(Policy Improvement)
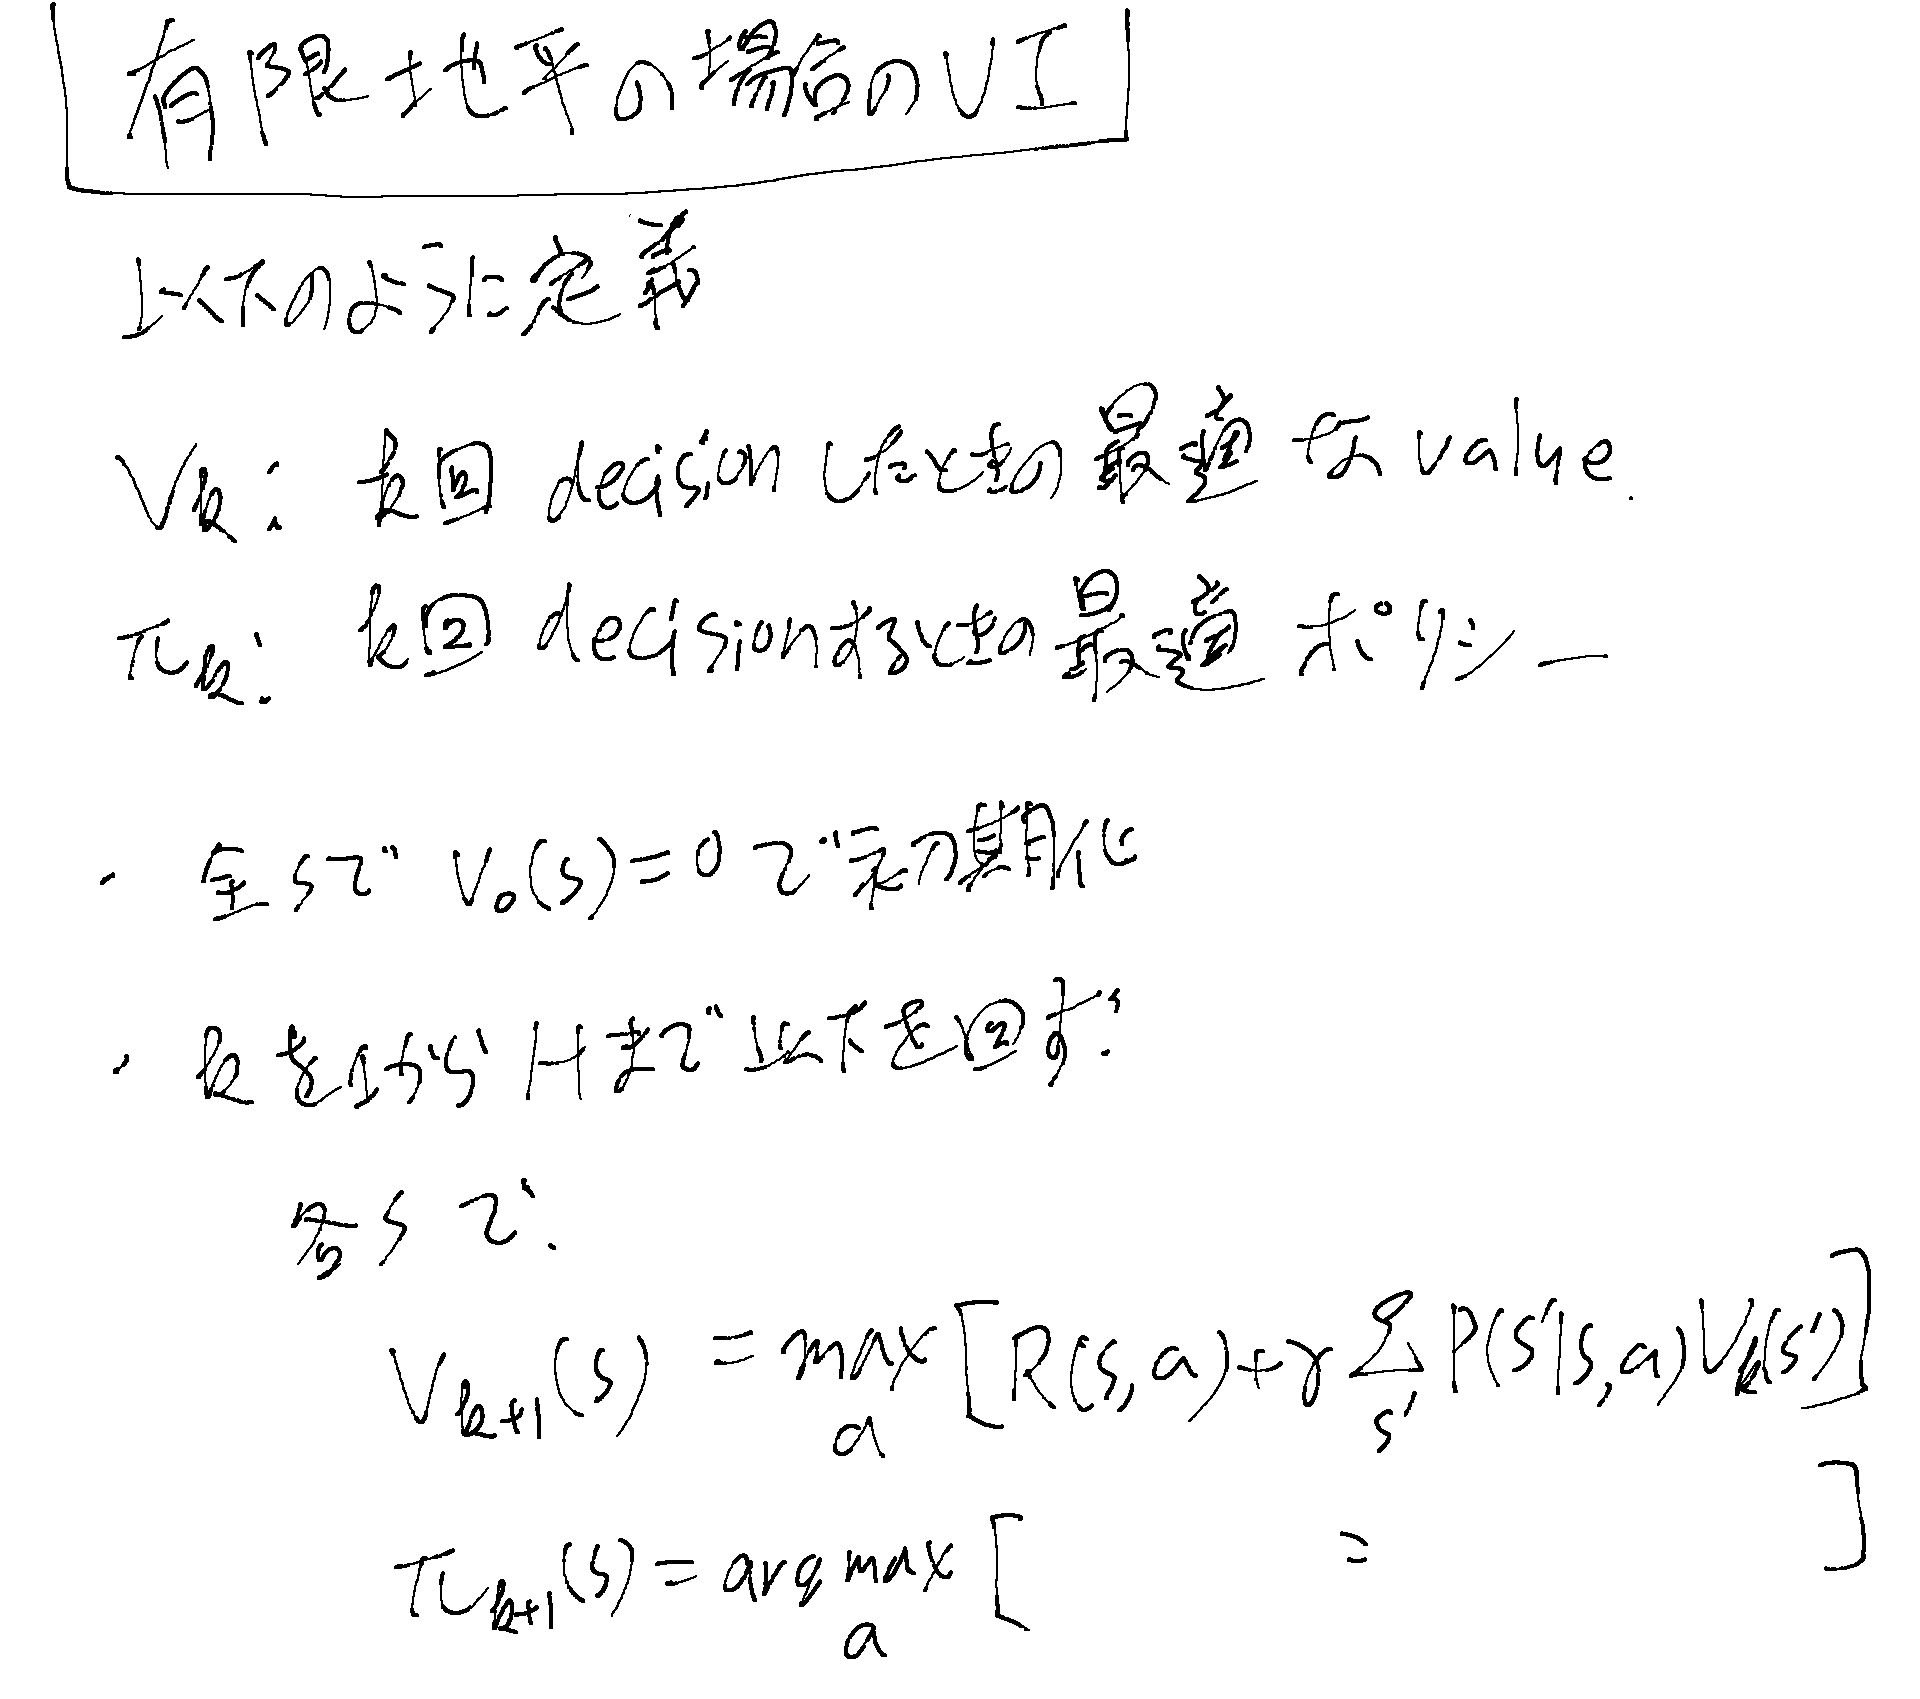
有限地平の場合
Valueをシミュレーションで求める
有限地平の場合、ポリシーからエピソードを複数生成する事が簡単に出来る場合がある。 その場合はエピソードを複数生成してリターンを計算して平均してしまえば、直接Vの推計値を得る事が出来てしまう。