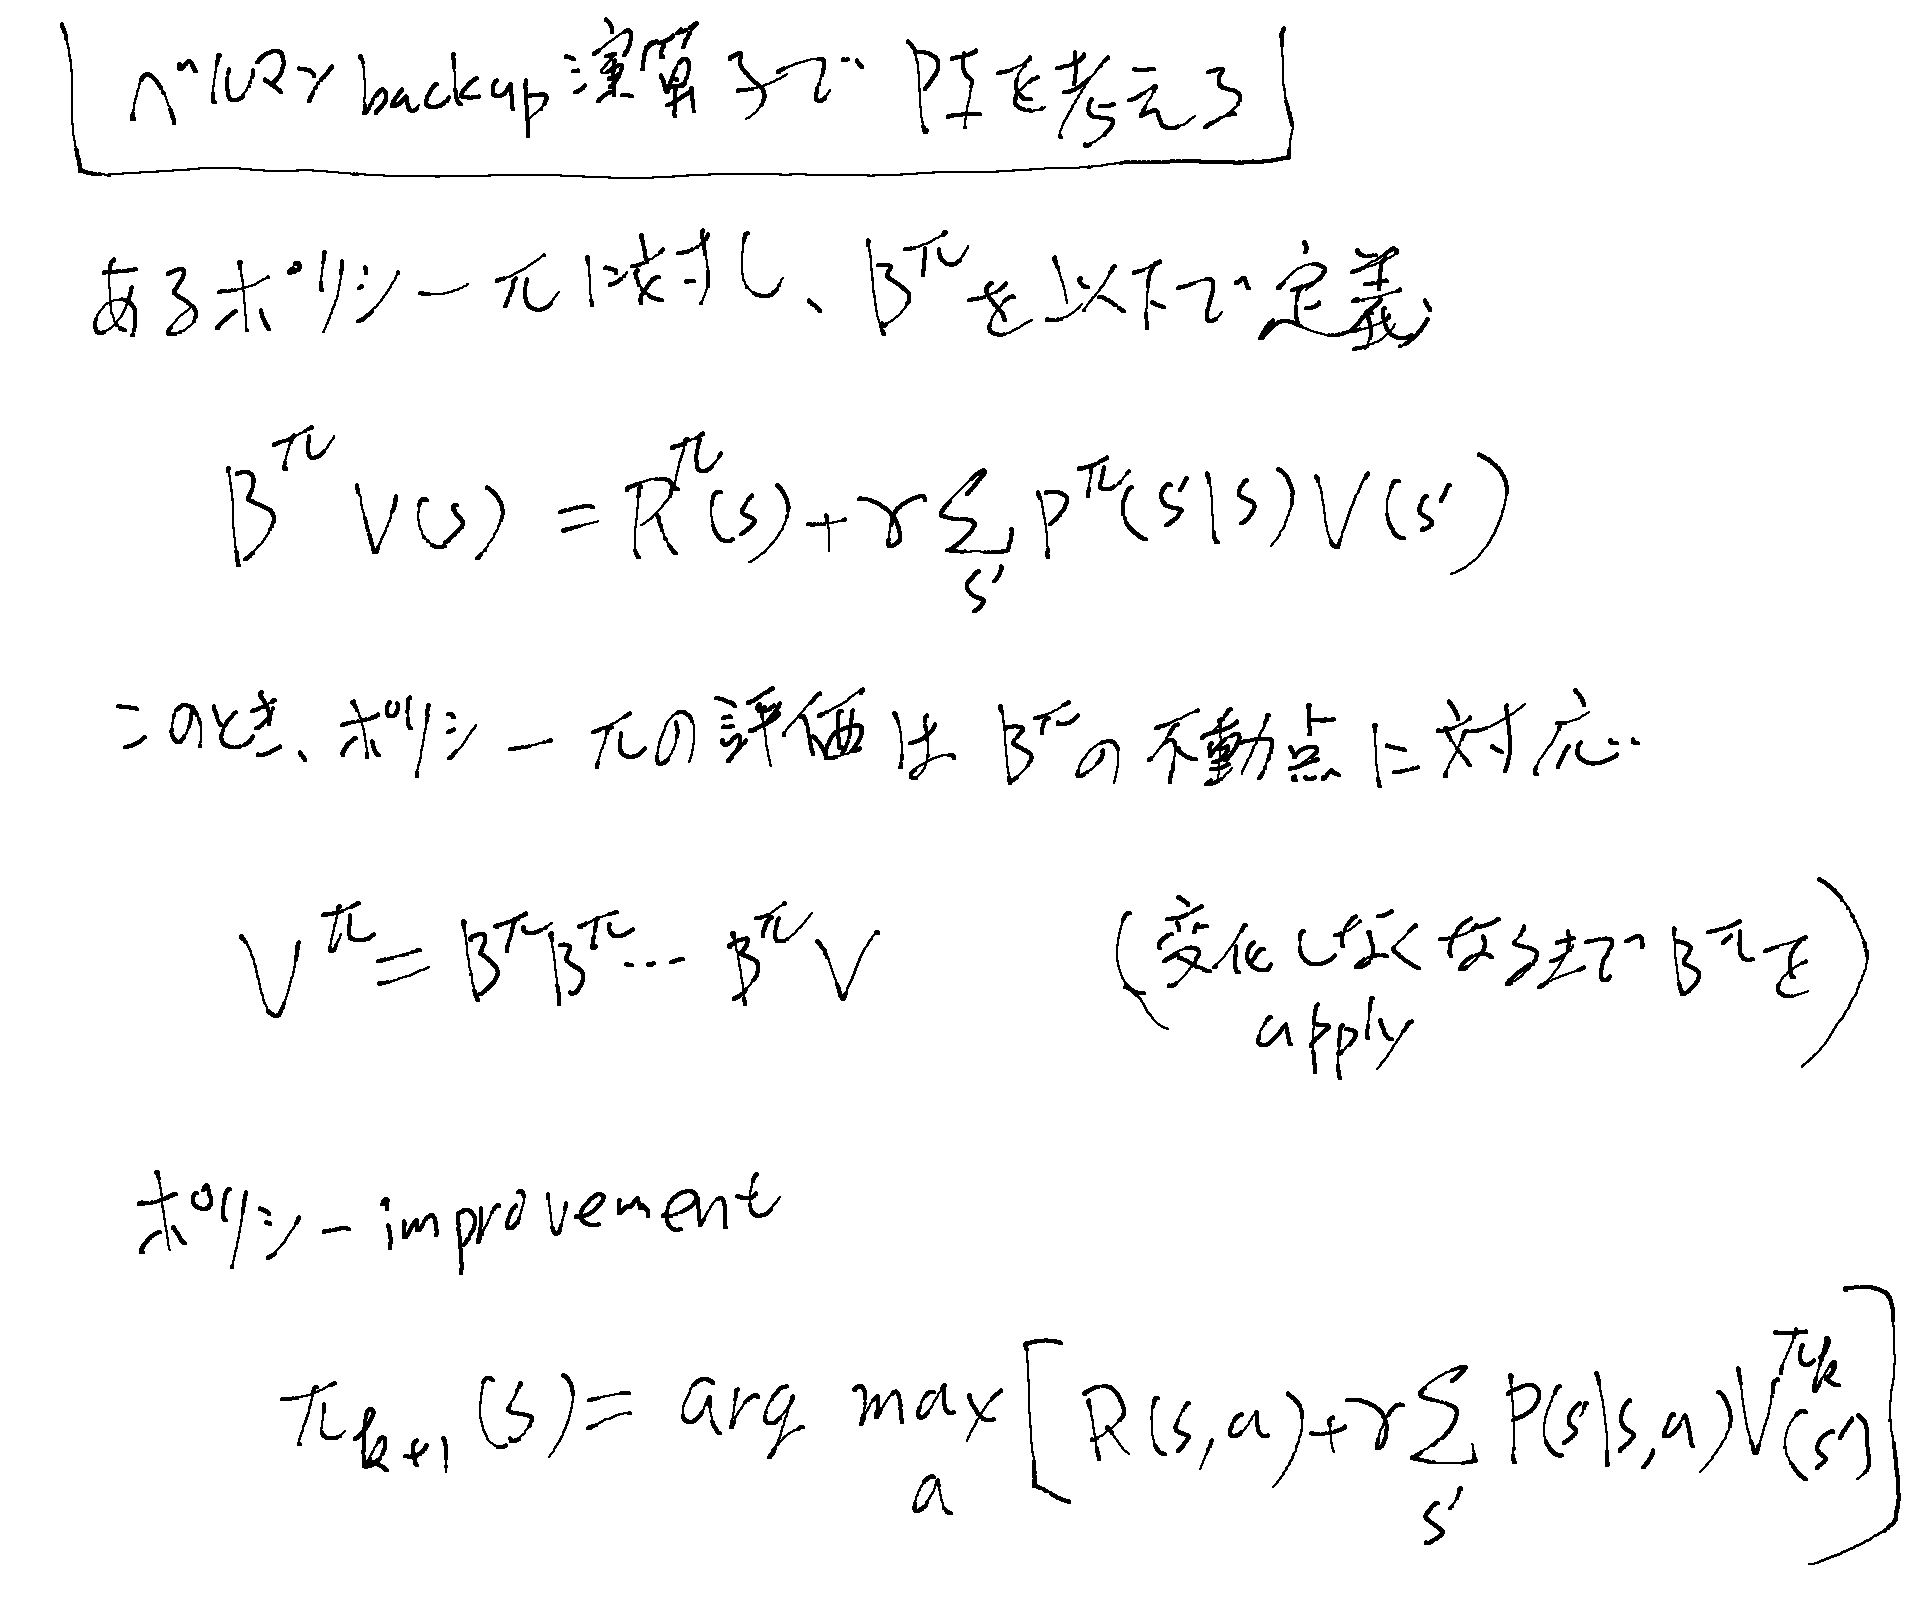ベルマンバックアップ演算子
Less than 1 minute
ベルマンバックアップ演算子
強化学習、強化学習の用語定義、MarkovDecisionProcess
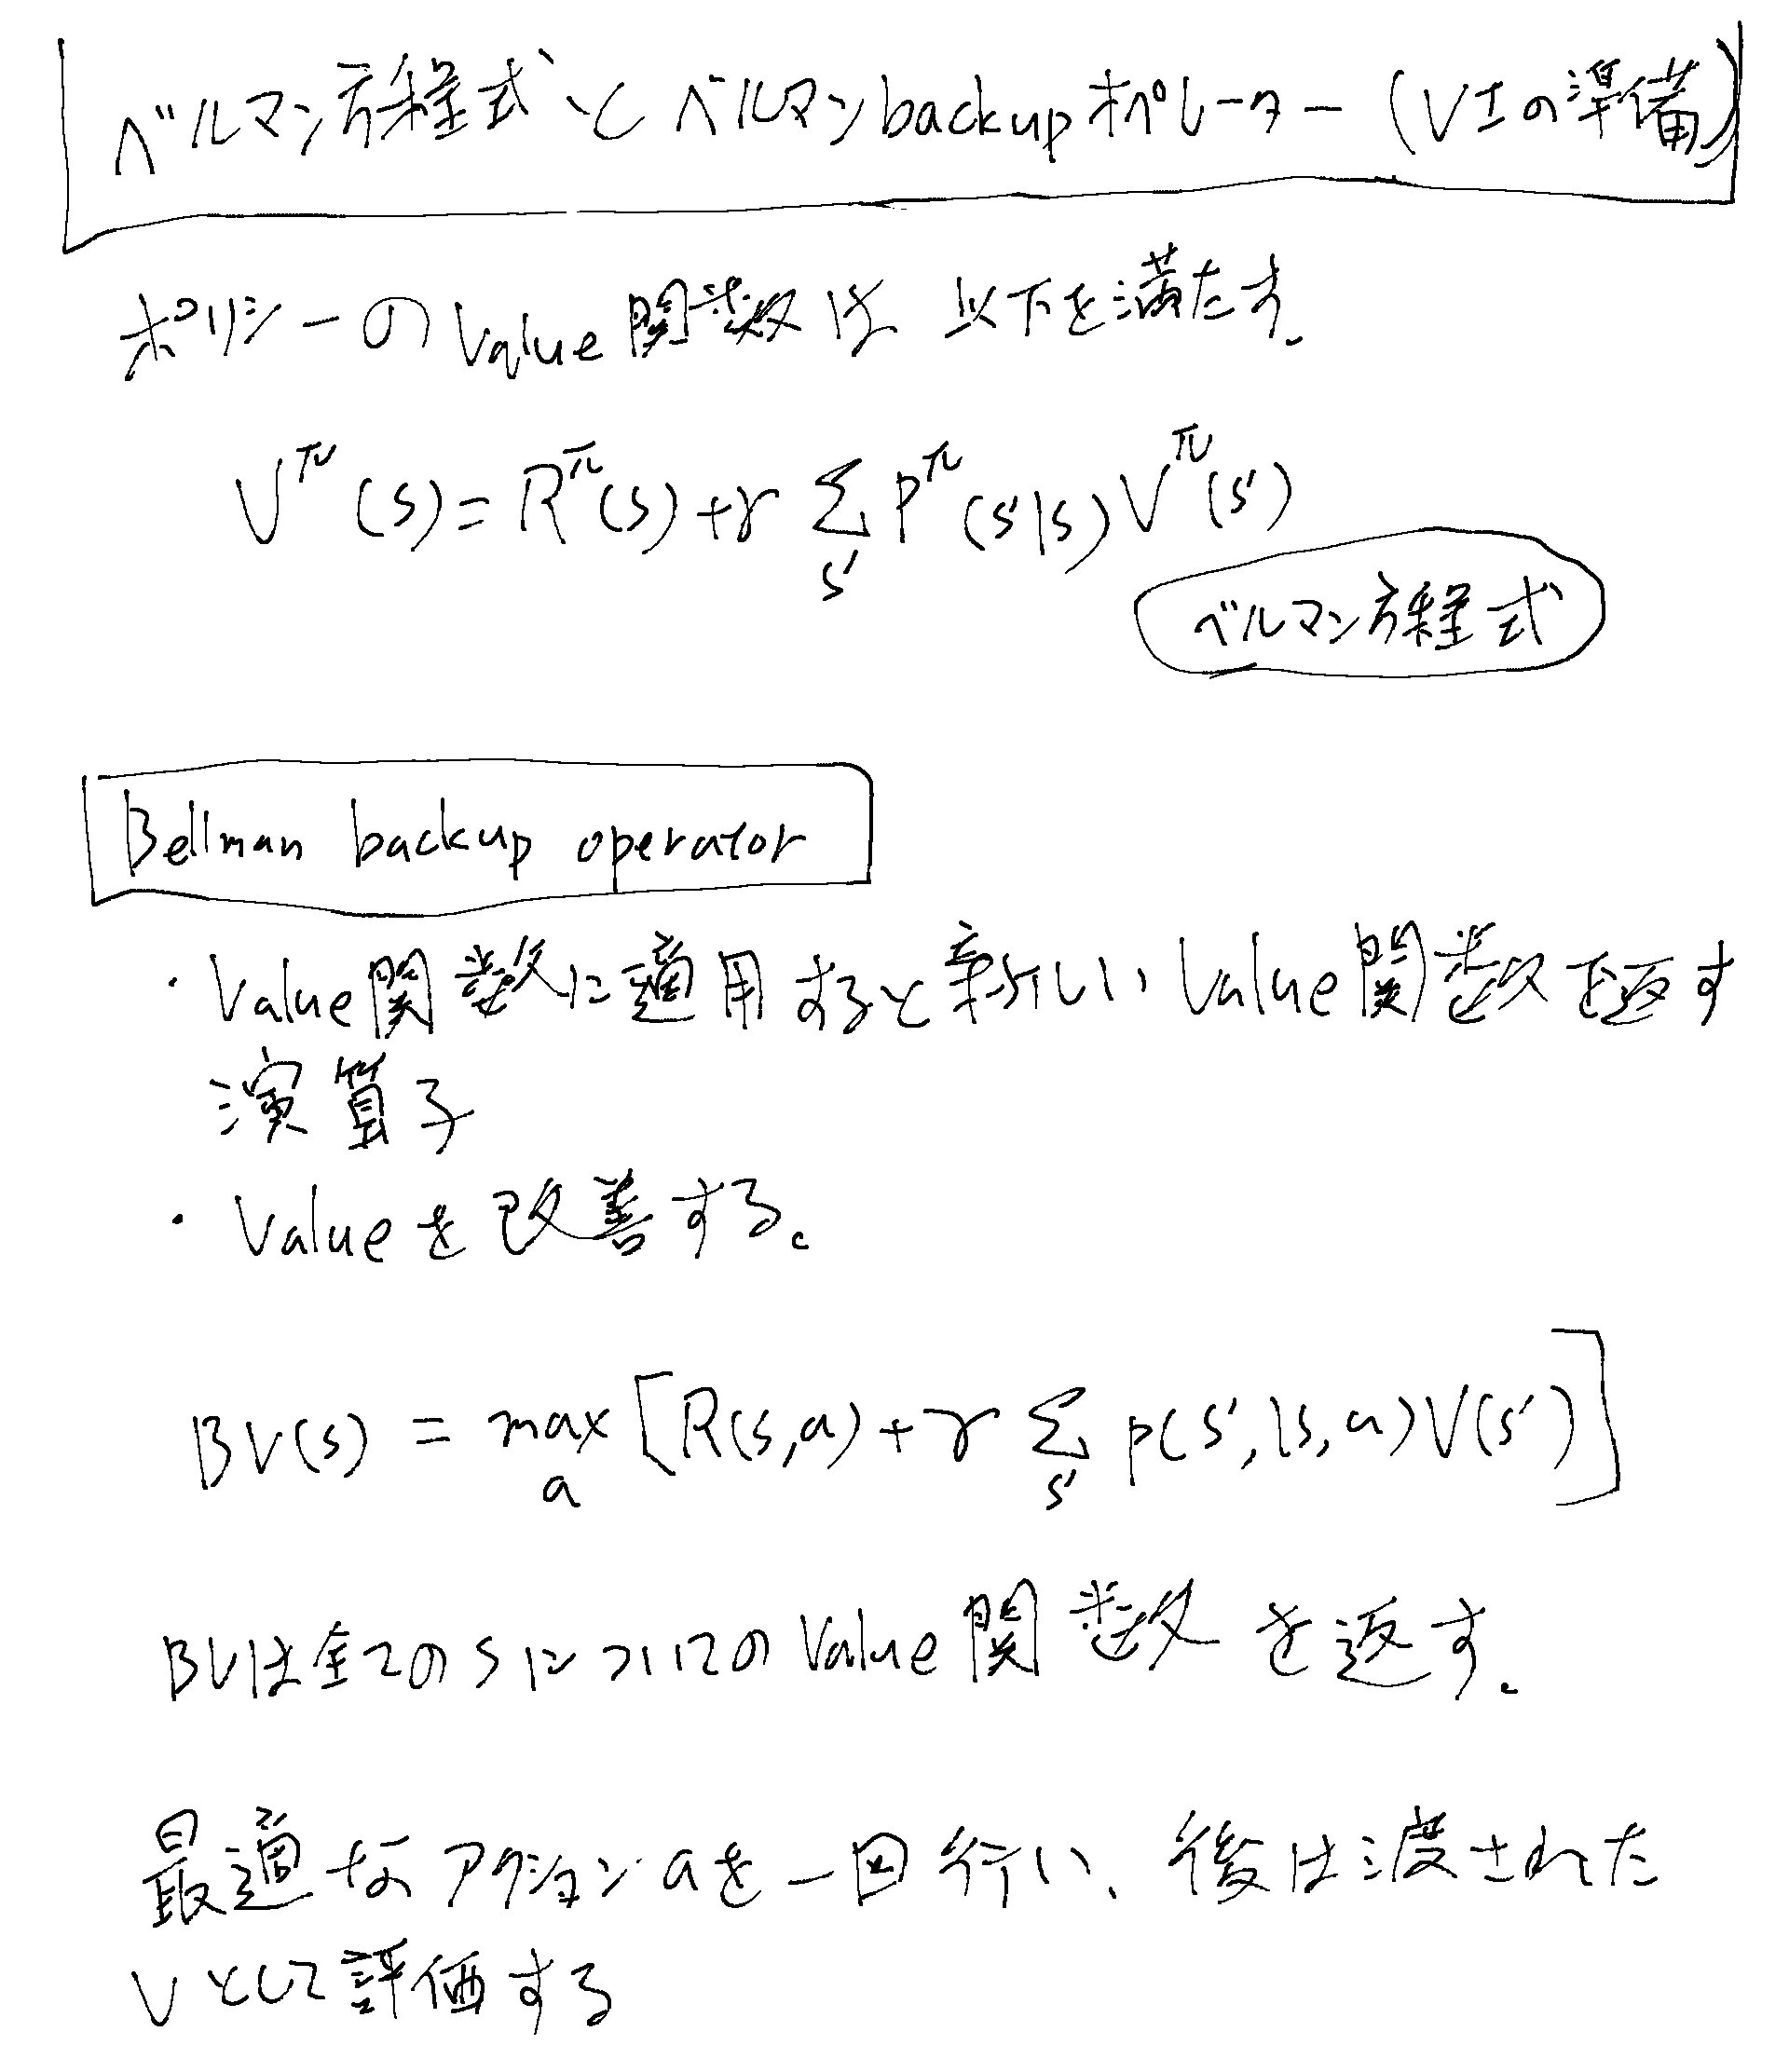
Tabular型のMDPでポリシーを与えると、Value関数はベルマン方程式となる。
この時にベルマンのバックアップ演算子を上記のように定義する。
- Vを渡すと新しいVを返す演算子
- Q関数で最大のaを選んだものか
特定のポリシーに関するバックアップ演算子
特定のポリシーに対するバックアップ演算子、というのがMarkovDecisionProcessのPIの再解釈の所で出ていた。