GPT1論文
Less than 1 minute
GPT1論文
GPT1の論文、Improving Language Understanding by Generative Pre-Trainingの事。
- Improving Language Understanding by Generative Pre-Training pdf
- Improving language understanding with unsupervised learning - OpenAI ブログ記事
概要
Transformerのデコーダーのみでlanguage modelを学習しまくって、それをtransfer learningするといろんなタスクで良いよ、という論文。 ラベル無しの文章で学習してスコアをあげるという試み。
タスクごとにモデルを作るのでは無く、全てのタスクをk個のトークンを元に次のトークンを予測する、という枠組みに変形する事で同じモデルを使うというのがアイデアではある。
ただし問題に合わせたfine tuneはする。4択とかはそれぞれの単語の確率のsoftmaxにしたりとか結構問題ごとに手は入れる。 最後のレイヤーだけでどうにかする、という感じ。
モデルとパラメータ数
Transformerブロックが一つで2Mi個くらいなのに、GPT1は原論文から解き明かす生成AIの表4.1によると117M個らしい。 レイヤー数と合わない気がするのでもう少し詳しく見ていく。
モデルは12レイヤーのデコーダーオンリーモデルで、dは768次元、ヘッドは12個、FFNは間を3072にしている、との事。
計算してみる。
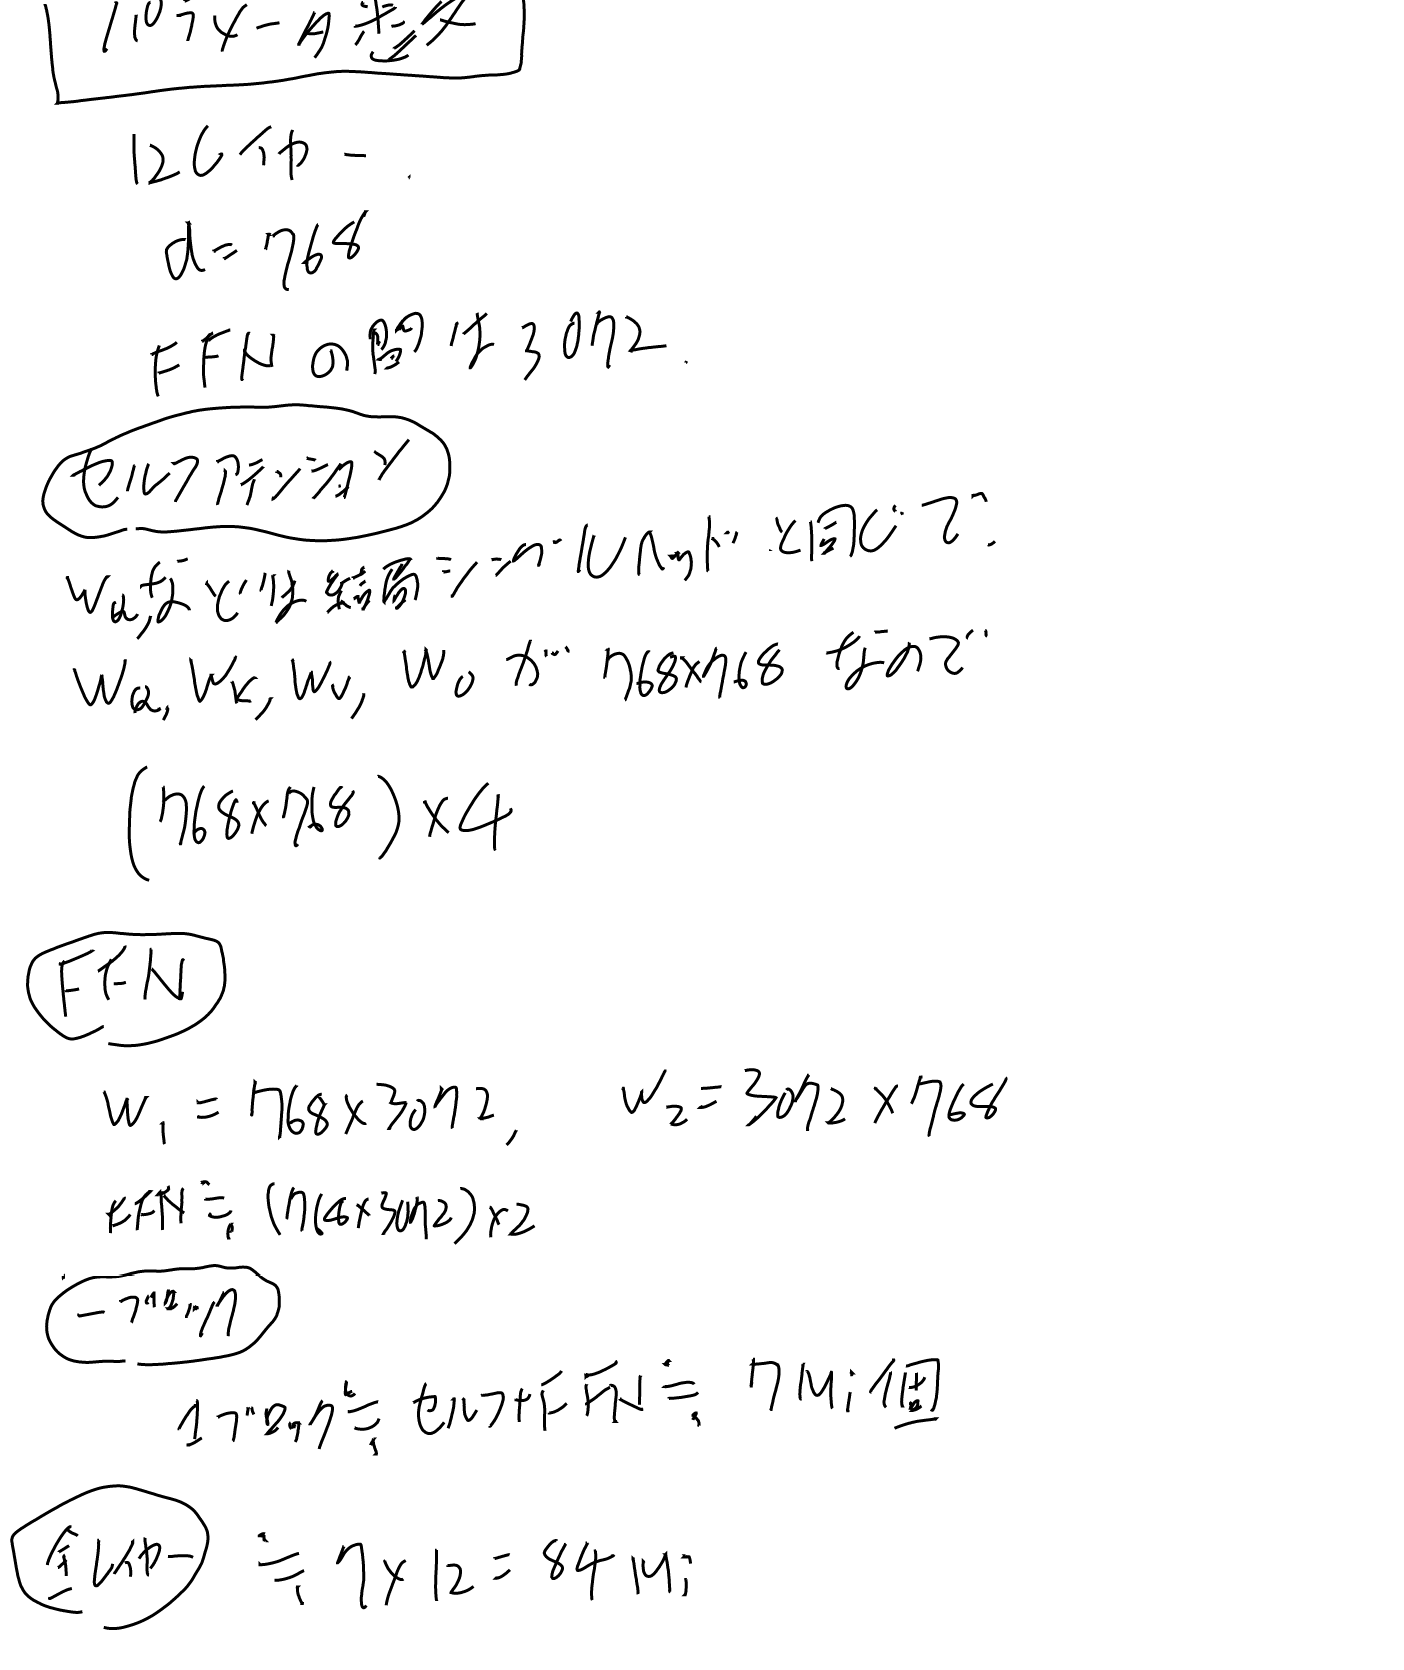
結構違うのだが。embedの行列か?
embedの行列も計算して足してみる。 vocabは40000。
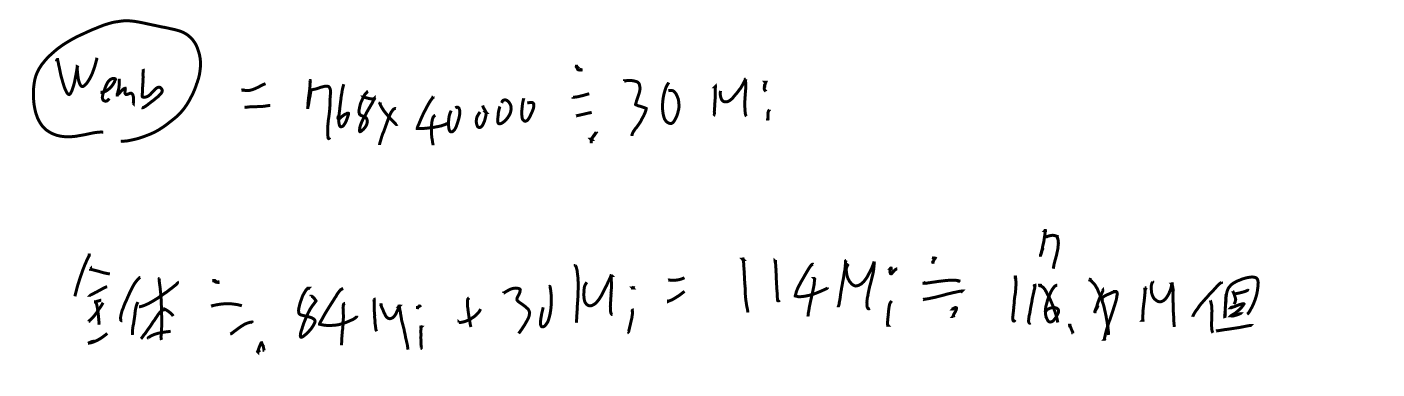
という事で117M個くらいになりそうで無事一致。っていうかembedって大きいんだなぁ。